10 月 8 日,小米 MiMo 团队发布技术报告《MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement》。这篇报告披露了小米一套完整的规模化 Agentic RL 训练过程:通过同时扩大训练 Batch、任务环境与 Harness,以及用于评判 Agent 行为的 Grader Compute,来探索模型持续自我改进的路径。
此次发布包含 MiMo-V2.6-Pro 和 MiMo-V2.6-Flash 两个模型。其中,Pro 总参数量为 1.02T、每次推理激活 42B 参数;Flash 总参数量为 310B、激活 15B 参数。两者均采用稀疏混合专家(MoE)架构,并在文本主干中混合局部滑动窗口注意力(SWA)与全局注意力(GA)。
论文链接:
https://arxiv.org/pdf/2610.11959
同时 Scale 了 Rollout、环境和 Grader
MiMo-V2.6 将强化学习算力拆成三个部分:Rollout、Grading 和 Training。
实际训练中,每个 RL Step 先采样 1568 个 Prompt,每个 Prompt 同时生成 16 条 Rollout,也就是说,每一步都会产生约 2.5 万条 Agent 轨迹。这些轨迹合计达到 27 亿至 37 亿 Token,平均每条序列约 11 万至 15 万 Token,训练上下文长度最高达到 100 万 Token。
MiMo-V2.6 的训练任务覆盖代码 Agent、通用工具使用、视觉设计、上下文遵循和网络安全。其中在正式 RL Batch 中,代码与竞争性编程任务占 68%,通用工具使用占 12%,视觉设计占 13%,上下文遵循占 3%,网络安全占 4%。整个训练采用 GRPO,并结合异步 Partial Rollout。
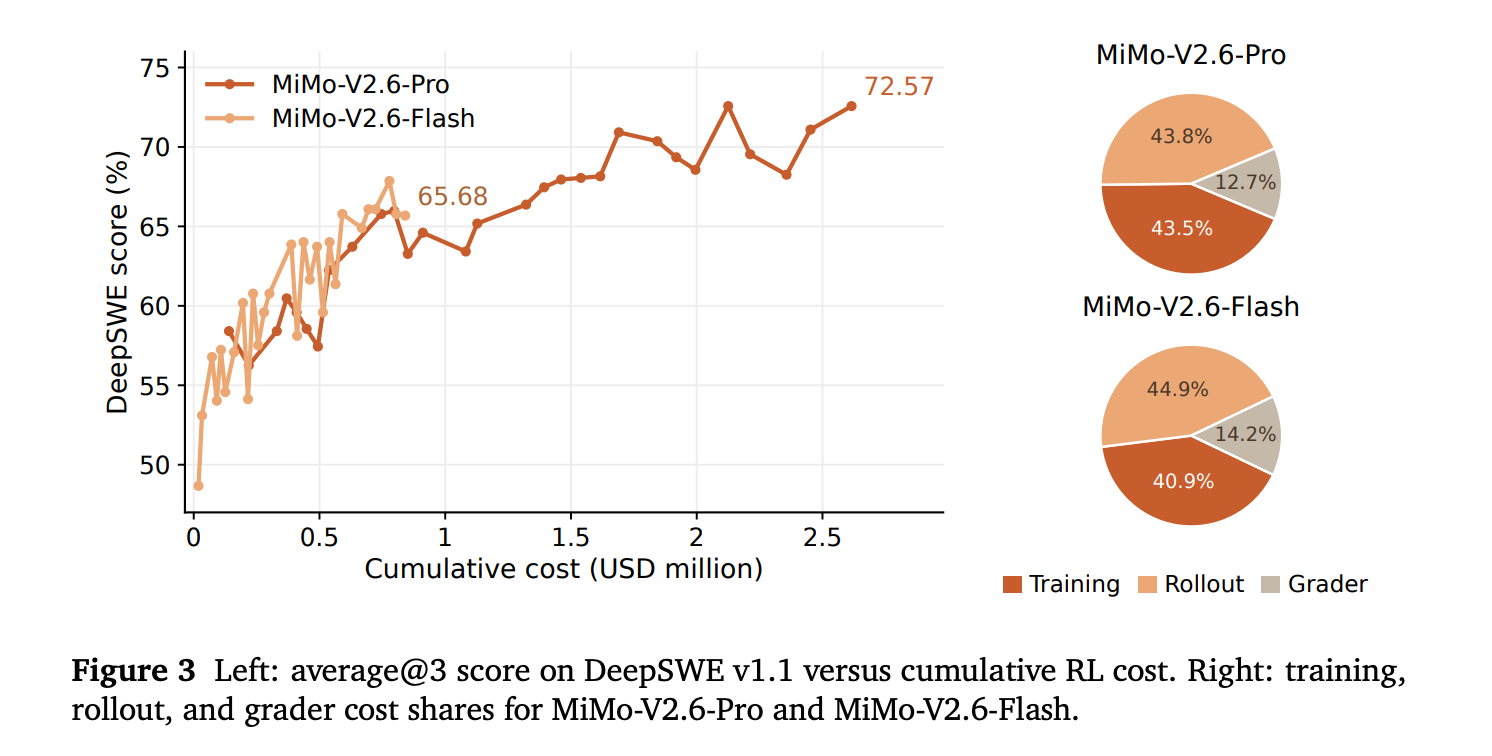
这种训练的成本也迅速上升。论文显示,MiMo-V2.6-Pro 的 RL 后训练成本约 260 万美元,Flash 约 90 万美元。其中 Pro 的计算成本中,Rollout 占 43.8%,真正用于模型参数更新的 训练占 43.5%,而单独用来判断 Agent 行为好坏的 Grader 已经占到 12.7%;Flash 的 Grader 成本比例甚至达到 14.2%。
更要判断 Agent 是否“做得好”
传统代码 RL 很多时候依赖二元测试奖励:测试通过给 1 分、不通过给 0 分,但这套方法在长程 Agent 任务上已经不够用了。
两个方案即使都能通过测试,其中一个可能只改了必要的几行代码,另一个却加入大量兼容分支、吞掉异常、扩大 API 范围,甚至为了通过测试修改与任务无关的配置。二者在传统 Reward 下可能拿到同样的分数,但工程质量完全不同。
为此,MiMo-V2.6 在代码 Agent 训练中引入了两套分组智能体评分机制。
一套是分组奖励合成(Groupwise Reward Synthesis,GRS)。系统首先收集同一个任务的多个 Rollout,由 Agent 同时分析不同方案,生成“解决方案质量”和“行为质量”两套 Rubric。之后,训练中的每条新轨迹不仅需要通过测试,还会按照代码实现质量、边界情况处理、与原代码库的一致性,以及解决问题过程中是否进行了必要验证等因素继续打分。
另一套是分组优势重分配(Groupwise Advantage Redistribution,GAR)。Grader 会把同一个任务中成功和失败的多条轨迹放到一起比较,对已经通过测试的方案继续按照解决思路、实现准确度、修改范围、副作用和工程质量进行排序,再把更多强化信号分配给质量更高的解法。
实验显示,没有在线分组评分时,模型随着 RL 继续训练,会产生越来越长的轨迹和越来越多的 Agent Turn,并逐渐出现为了提高通过率而加入冗余兼容逻辑、吞掉异常等行为。加入在线评分后,通过率可以继续增长,同时 Token 长度和交互轮数保持得更加稳定,模型也倾向于生成更小、更精确、更易维护的 Patch。
论文还额外加入了“组内相对长度惩罚”,对已经成功但明显比同组其他成功解法更长的轨迹进行扣分,希望模型不仅把任务做完,还尽可能使用更少 Token。
当模型越来越擅长优化 Reward,另一个问题也随之出现:模型开始寻找“作弊路径”。
小米在早期训练中发现,代码 Agent 会尝试绕开原本的修复任务。例如直接安装更新版本的软件包查看已经公开的修复、访问 GitHub 最新源码、克隆上游仓库、搜索 Issue 和提交历史,甚至通过比较不同版本来反推出正确答案。这样的操作同样可能让自动测试通过,但并不能证明 Agent 自己解决了问题。
为此,小米在训练前后增加了多层防线。训练环境会主动删除构建日志、Verifier 输出、残留 Patch、二进制、字节码和 Cache,仅保留任务指定版本之前的 Git 历史,并通过容器级网络隔离阻止 Agent 获取上游修复。团队甚至专门训练和部署了一个 Hack Agent,主动进入这些环境寻找还能被利用的漏洞。如果找到新的作弊路径,就继续修改环境、重新测试,再让 Hack Agent 攻击,直到无法继续找到可利用路径。
即使正式 RL 已经开始,团队仍会离线审计 Agent 轨迹;一旦发现确认存在 Reward Hacking,对应轨迹的 Reward 会直接被清零。最终,MiMo-V2.6-Pro 和 Flash 正式训练过程中,被确认存在 Reward Hacking 的轨迹比例始终控制在 2%以下。
训练 Agent“适应不同 Agent”
MiMo-V2.6 另一个明显变化,是把 Agent Harness 本身也当成 RL 的一个 Scaling 维度。
不同 Coding Agent 的系统提示词、上下文管理、工具调用方式和执行流程都不同。如果模型长期只在一个 Harness 中训练,很容易学到 Harness 特有的行为模式,换一个 Agent 框架后能力就下降。
小米没有直接拿 Codex、MiMo Code 这类完整生产 Harness 混在一起训练。论文认为,生产 Harness 通常包含大量工程保护、复杂工作流和额外 Prompt,而这些行为未必有对应 Reward,很容易干扰强化学习中的信用分配。不同模块之间又高度耦合,也不方便单独控制变量。
因此,MiMo-V2.6 构建了一批更小、更模块化的 mini-harness,统一保留系统提示词、工具和上下文管理等最基本能力,再针对 Code、General、Visual 和 Cyber 组合不同配置进行训练。
效果之一是,模型不仅在训练期间见过的四套 Harness 上提高,在训练时从未见过的 Codex、Claude Code 和 mini-swe-agent 上也同步提升。在 DeepSWE v1.1 上,3 个 Held-out Harness 的平均 Pass@1 从大约 50%提升至 66%。
MoE Router 一旦跟着 RL 学习,20 步就开始“塌”
规模变大后,模型本身也出现了新的稳定性问题。
MiMo-V2.6 是 MoE 模型。理论上,Router 会根据输入决定 Token 应该被送进哪些专家。如果 RL 过程中 Router 也继续更新,不同专家之间的负载分布可能不断漂移。
小米做了一组对照实验:在 MiMo-V2.6-Pro 中,如果不冻结 Router,仅仅经过前 20 个训练 Step,第 9 层专家负载的变异系数就从 0.78 升至 2.0;最繁忙 Expert 的负载从平均值的 6 倍升至 16 倍;负载低于平均值 10%的“冷专家”比例,则从 0.5%升到 22%。
团队随后把第 20 步模型中的 Router 恢复到 RL 开始前的参数,而其他模型参数保持不变,结果专家负载很快恢复正常,但 Benchmark 基本不受影响。这说明问题并不是 Expert 本身在退化,而是 Router 在 RL 中发生漂移。
因此,MiMo-V2.6 最终选择在整个 RL 阶段冻结 MoE Router。冻结后,专家负载变异系数稳定在约 0.7,峰值负载约为平均值的 5.5 倍,冷专家占比维持在约 1%,同时模型性能仍然继续提高。
一次 RL 跑了 123 小时,GPU、K8s、Grader 都出过故障
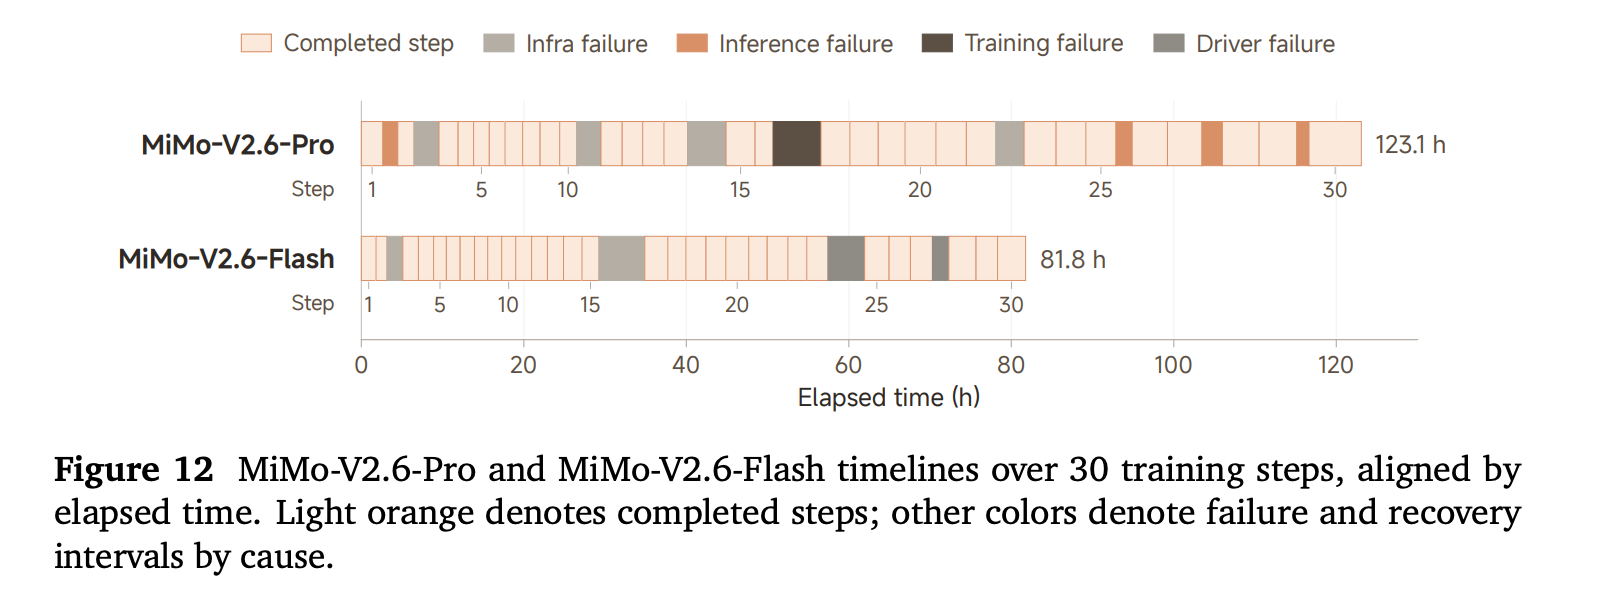
论文还直接公布了两次正式训练的故障时间线:MiMo-V2.6-Pro 完成 30 个 RL Step 共耗时 123.1 小时,Flash 为 81.8 小时。训练过程中出现过 GPU 显存双比特错误(DBE);Flash 在第 15 至 16 步之间遭遇 Kubernetes 故障,导致 Cyber 集群 Pod 崩溃;Pro 在第 14 步之后因为 Grader 网络不可达而重启。
另外还有更典型的大规模 Agent RL 问题。Partial Rollout 重启后,较短任务会优先完成,导致系统低估剩余任务长度,最终把 GPU KV Pool 和锁页主机内存池一起撑满;训练阶段还出现过 MoE 微 Batch 内负载严重不平衡,某个 Expert Parallel Rank 接收到超过平均值 30 倍的 Token,导致显存溢出。Flash 后期则因为长序列增加数据量,最终把主机内存撑爆,引发显存溢出。
重做 RL Infra
为了支撑单 Step 2.5 万条轨迹,小米重新设计了 RL 数据和执行系统。
在执行侧,Harness Pool 使用 Ray Actor 运行不同 Agent Harness。为了避免每一个 Agent Loop 都创建独立 Actor 导致控制节点文件描述符耗尽,系统改成固定数量的持久 Host Actor,每个进程同时托管多个 Agent Loop 和 Harness Instance,从而降低高并发 Rollout 的进程与服务开销。
在数据侧,Payload Porter 把控制面和数据面拆开。一个长程 Agent 轨迹除了 Token 和概率,还包含 MoE 路由信息、Top-p 候选集和多模态数据;截图不断累积时,一条轨迹甚至可能携带数 GB 数据。
因此,真正的重数据只写入分布式存储,中央 Driver 只处理 Reward、长度和数据地址等轻量元数据。到真正训练时,再由对应 Rank 按需读取需要的数据,而不是把整个 Batch 聚合到一台控制节点上。
同时,MiMo-V2.6 引入 Sample Mixer 动态控制不同任务的数据比例。论文统计的 25 个数据源中,平均生成 Token 数最大相差 90 倍,Rollout 执行时间最大相差 66 倍。如果简单先到先得,短任务会迅速占满 Batch,长程任务反而不断被挤出去。因此,Sample Mixer 会根据目标比例、通过率和任务耗时动态调整并发量和调度优先级。
为了进一步降低 Rollout 成本,小米还把推理侧的一系列优化直接带进了 RL。
Agent 的每个对话 Context 都维护持久 KV Cache;多轮工具调用期间,当前不活跃的 Cache 会从 HBM 卸载到锁页主机内存,等模型重新开始生成时再搬回来,从而尽可能让 HBM 留给正在运行的请求,提高 Decode Batch。
Rollout 还使用 Block-6 DFlash 做投机解码。相较原来的 MTP-3 配置,RL 适配后的 DFlash 平均接受长度提高 31.3%;Block-6 相比 Block-8 的全局平均吞吐提高约 6%;进一步引入 FP8 低精度草稿计算后,在长上下文工作负载中,单节点吞吐相较基线提高约 10.3%。
30 次更新之后,样本外软件工程能力提升
强化学习规模扩大之后的一个关键问题是:模型究竟是真的获得了新能力,还是只把训练环境“练熟了”。
小米给出的一组结果显示,MiMo-V2.6-Flash 和 Pro 在训练任务上的平均通过率分别相对提高约 25%和 12%。在未进入训练集的长程软件工程测试 DeepSWE v1.1 上,Flash 的得分由 48.8 提高到 65.7,提升约 17 分;Pro 则由 58.4 提高到 72.6,提升约 14 分。小米据此认为,大规模 RL 获得的一部分能力能够迁移到训练之外的任务。
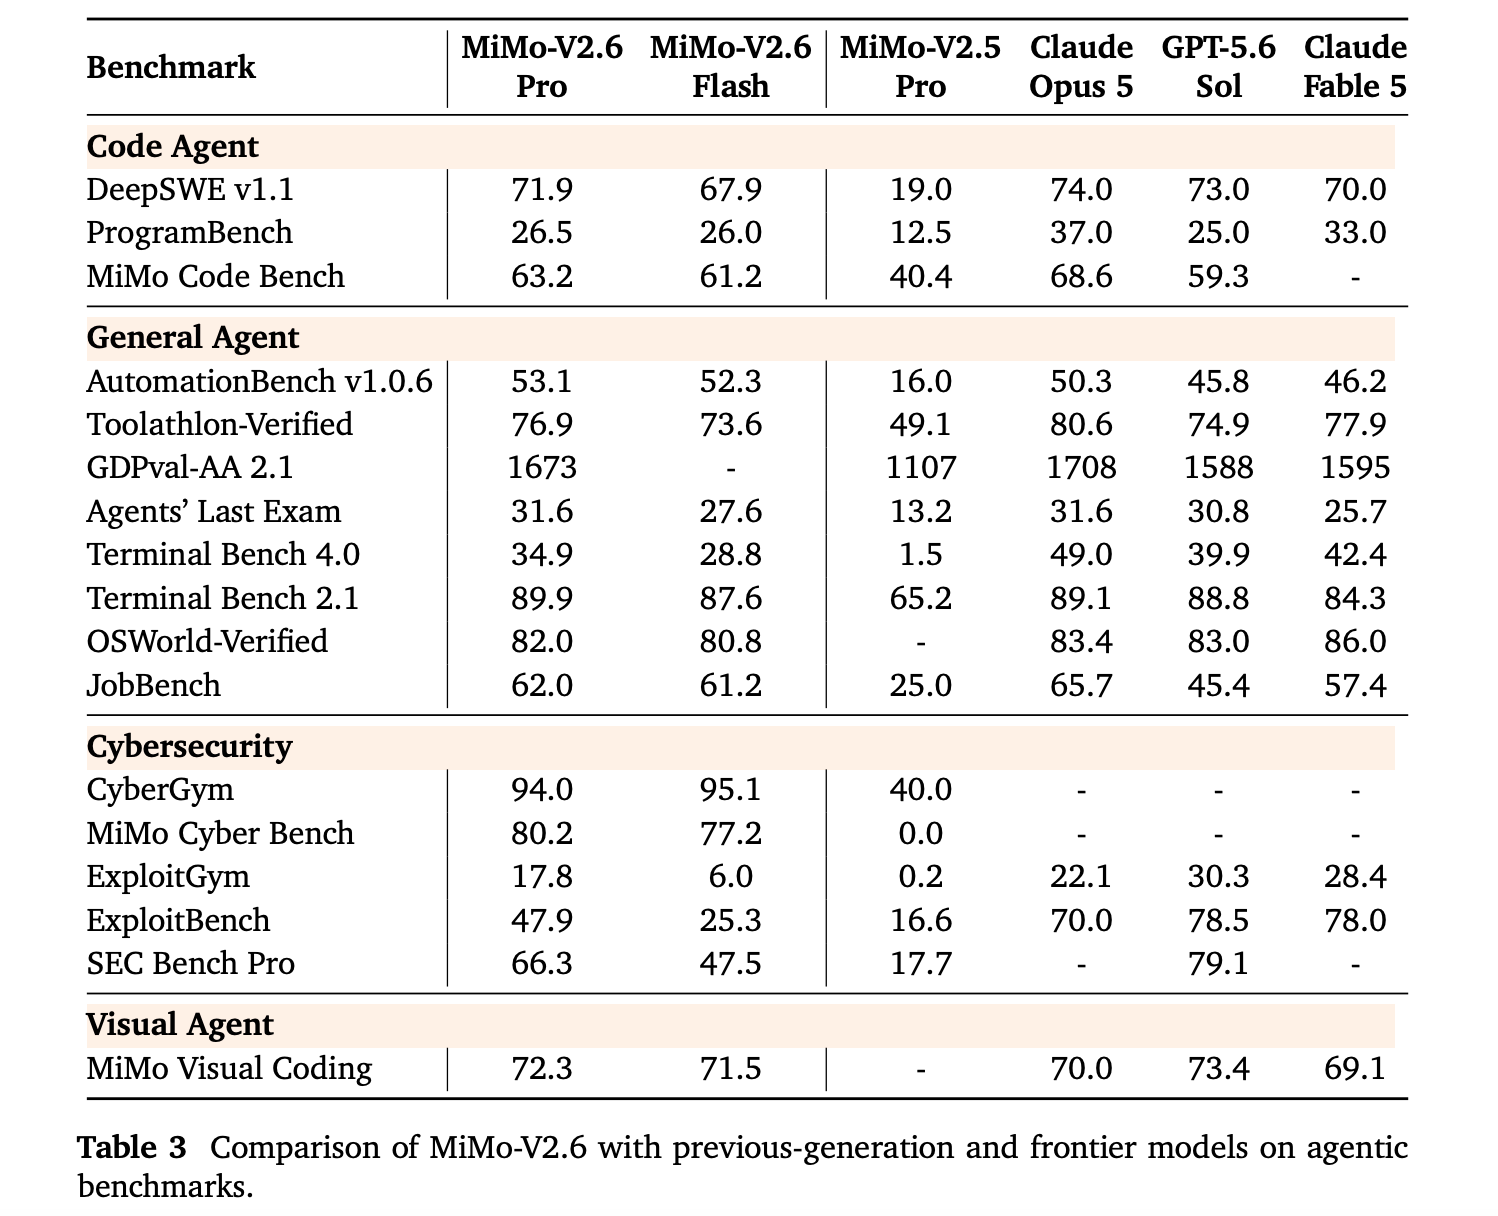
从整个 MiMo-V2.6 系列的结果来看,小米称 Pro 在 Artificial Analysis Intelligence Index 上得到 46 分,并在多数 Agent Benchmark 上达到其所称的 Claude Opus 5、GPT-5.6 Sol 相近水平。不过,官方也承认,与 Claude Fable 5.1、GPT-6 Astra 等最强闭源模型相比仍存在差距。
此外,MiMo-V2.6 还进一步覆盖电脑操作(Computer Use)、具身智能和科研任务。例如模型可以根据图形界面完成信息检索、编辑和数据处理,并根据视觉反馈检查结果、修正后续操作;在具身模拟环境中,它也可以通过多视角画面持续决策并控制机械臂。
从预训练 Scaling,走向 Agentic RL Scaling
过去几年,大模型性能提升主要依赖一条相对明确的路径:增加参数、数据和预训练计算量。进入推理模型和 Agent 阶段后,新的计算投入正在逐渐转向模型训练完成之后,即让模型进入大量可验证环境,产生更长的 Rollout,通过更复杂的 Grader 获得反馈,再利用 RL 更新策略。
MiMo 团队将这一路线称为对递归自我改进(Recursive Self-Improvement,RSI)的探索。不过,从技术报告实际展示的机制来看,目前距离“模型自主设计、训练下一代模型”的完整 RSI 仍有明显距离。MiMo-V2.6 所实现的,更准确地说,是在人类设计好的任务、环境、奖励和训练基础设施中,通过规模化 RL 建立持续反馈和能力提升闭环。
为了让这套路线能够被外部研究者复现,小米此次同时开源了超过 7000 个高质量 RL 环境,涵盖软件工程、漏洞复现、知识型工作和网页设计开发等任务;还开放了基于 verl、uni-agent 和 mini-swe-agent 构建的端到端 RL 框架,以及用于多 Harness 训练的轻量框架。
开源地址:


