作者 | 林绮蓓
编辑 | 蔡芳芳
9 月 20 日,千问开源 Qwen-Image-2.1,官方将其定义为“一个兼顾生成效果、推理效率与使用成本的图像模型”。
具体来说,这是一款统一图像生成与编辑的模型,其视觉生成部分仅包含 7B 参数和 32 层 Single-Stream DiT,却同时集成了文生图、单图编辑、多图编辑、透明图像生成与编辑、局部修改、人像与商品一致性保持等能力。
据千问团队介绍,Qwen-Image-2.1 此次主要围绕四个方向升级:更紧凑和高效的模型结构、原生透明图像能力、更灵活的多图与局部编辑,以及进一步改善的文字、人物光影和细节表现。
模型目前已经开源上线 GitHub、Hugging Face 和 ModelScope。
项目链接:
GitHub: https://github.com/QwenLM/Qwen-Image-2.1
Model Scope: https://www.modelscope.cn/models/Qwen/Qwen-Image-2.1 Hugging Face: https://huggingface.co/Qwen/Qwen-Image-2.1
7B,千问这次开始给图像模型“瘦身”
Qwen-Image-2.1 最直接的变化是模型规模。
2025 年 8 月发布的首个 Qwen-Image,其视觉生成模块规模达到 20B。而 Qwen-Image-2.1 视觉生成模块参数量为 7B,采用 32 层 Single-Stream DiT;同时使用 Qwen3-VL 8B 作为文本和条件图像编码器,将文字指令以及参考图像编码到统一表示形式;图像部分则使用支持 RGBA 的 64 通道 VAE,空间压缩倍率为 16 倍。
参数缩小之后,一个自然的问题是能力是否会明显下降。
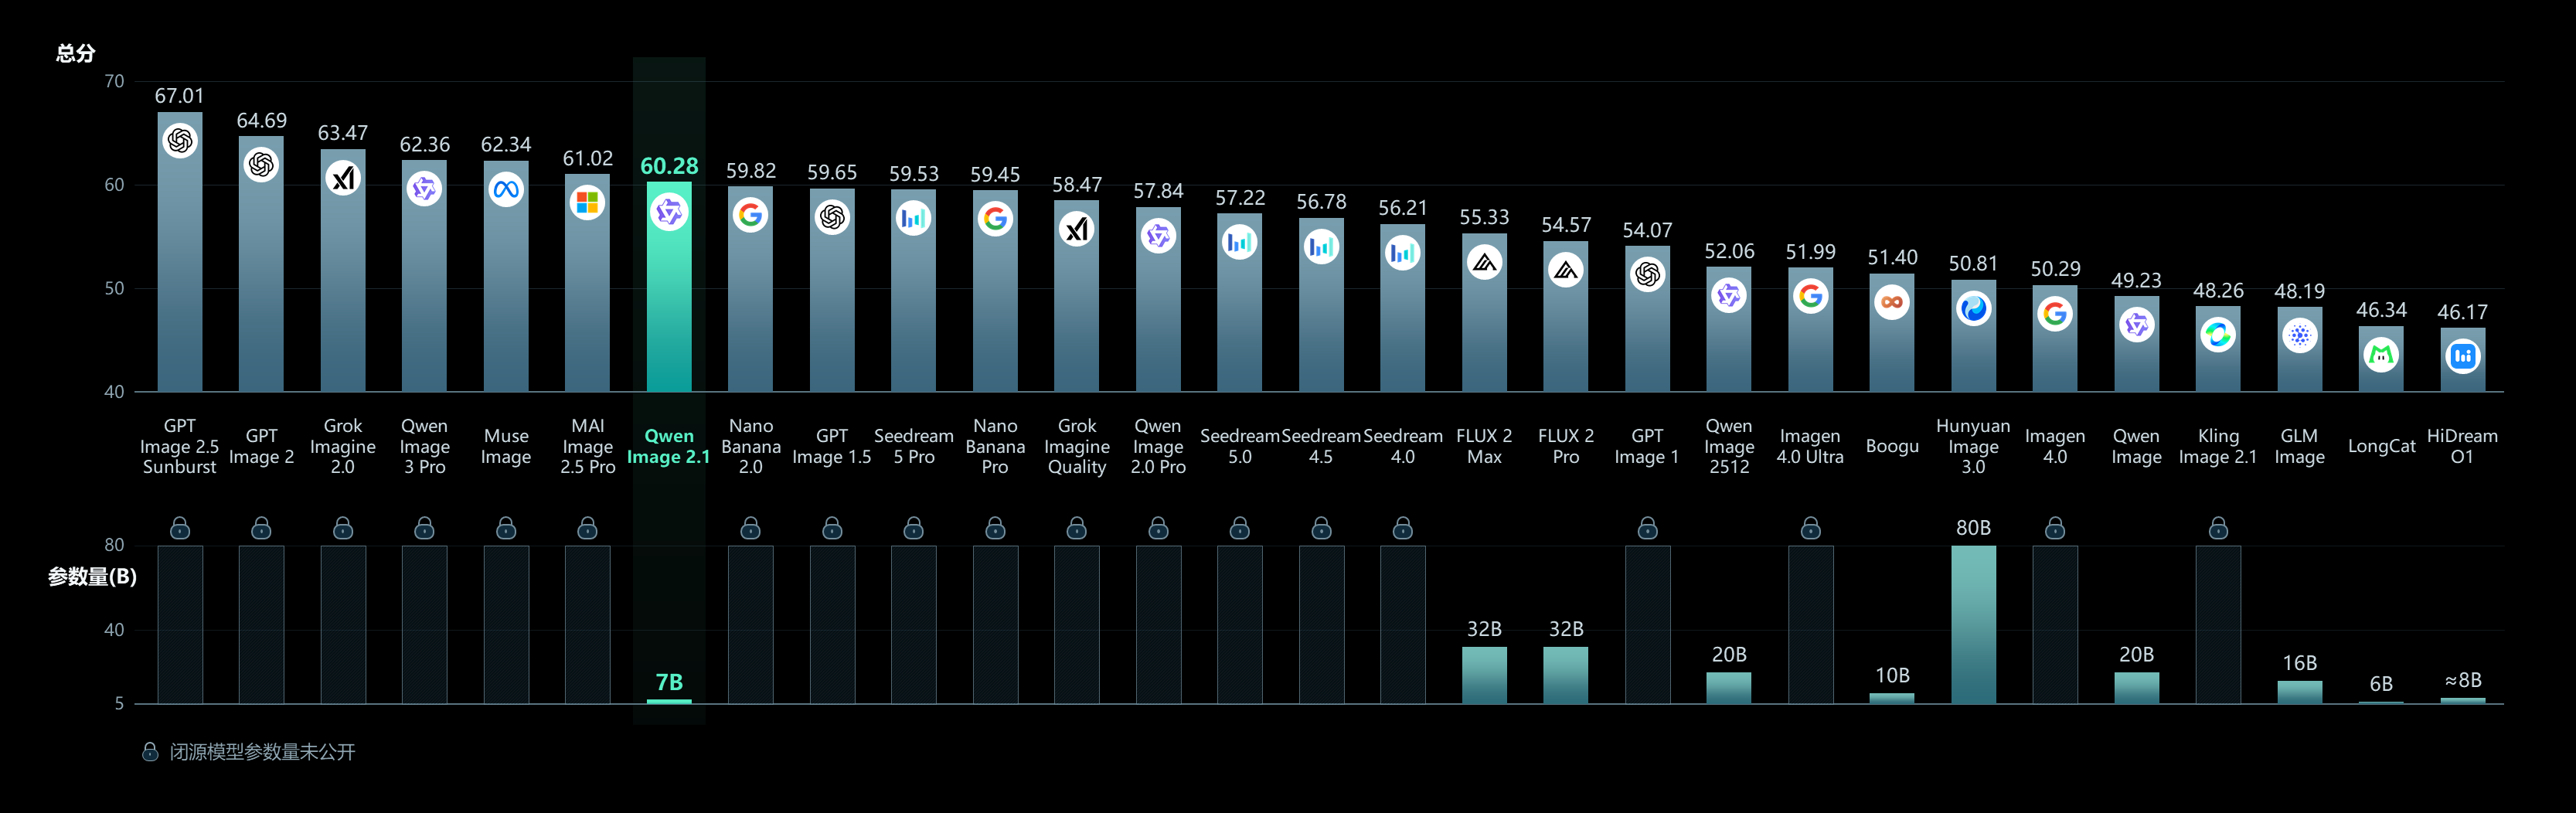
千问在此次发布中给出了 Qwen-Image-Bench 的对比结果。按照官方发布图表中披露的数据,Qwen-Image-2.1 综合得分为 60.28;Google Nano Banana 2.0 为 59.82,GPT Image 1.5 为 59.65。从这份官方发布的榜单来看,Qwen-Image-2.1 的整体表现已经进入头部图像模型所在的第一梯队。
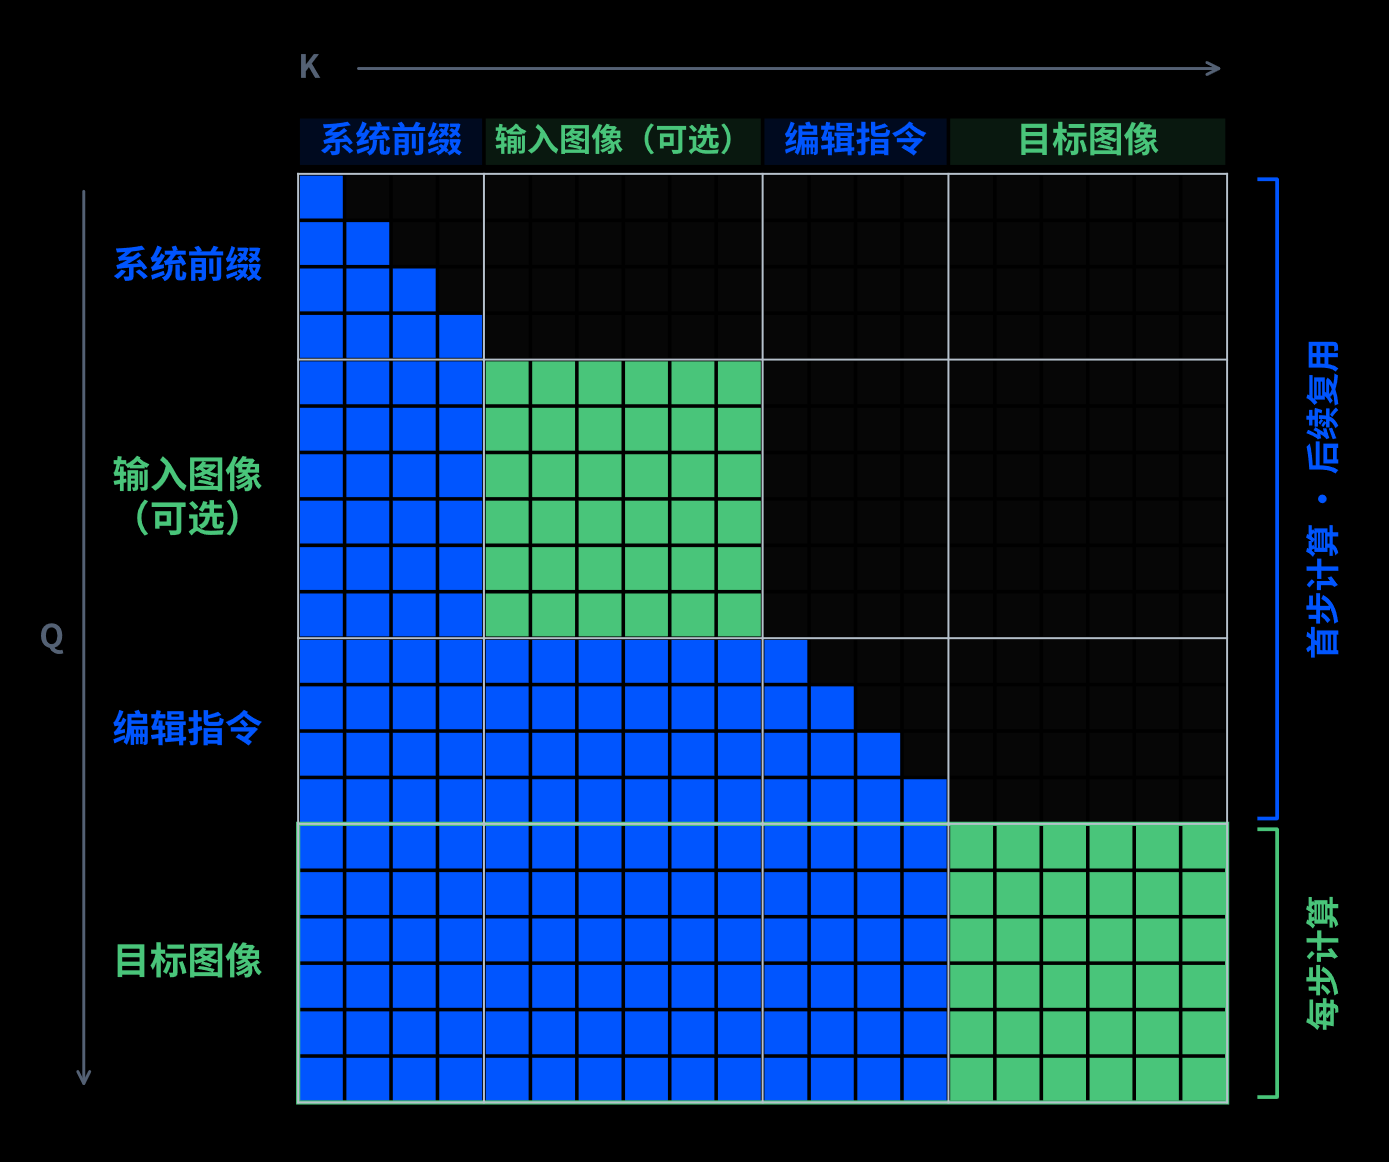
千问特别强调了“小模强效,极致价比”。为了优化推理效率,Qwen-Image-2.1 引入了混合粒度注意力机制。其中,系统提示词和编辑指令等文字部分采用 Token 级因果掩码;图像则使用 Chunk 级掩码。模型借助 KV 缓存复用机制,把编辑指令与参考输入图像视作静态上下文,仅在推理第一步完成预计算并缓存,以此加快推理速度、减少显存占用。
不只是生图:透明图、多图融合和局部编辑都被整合进这个模型
Qwen-Image-2.1 有个比较特殊的能力,是原生支持 RGBA 透明图像。
传统文生图模型输出的通常是 RGB 图片。当用户想生成 Logo、贴纸、商品素材、人物抠图或者设计元素时,往往还需要额外使用背景移除、分割或者抠图模型,将主体从背景中提取出来。
根据官方说明,用户可以通过提示词让模型直接生成透明图像,也能够编辑已有透明图层,或者从普通照片中提取主体。
这项能力并不是千问第一次尝试。2025 年 12 月,团队曾经单独发布 Qwen-Image-Layered,用于透明图像生成以及图层相关任务。但 Qwen-Image-2.1 进一步将这一能力整合进统一模型:模型可以根据任务决定输出普通图片还是透明图片,而不再需要在不同模型之间切换。
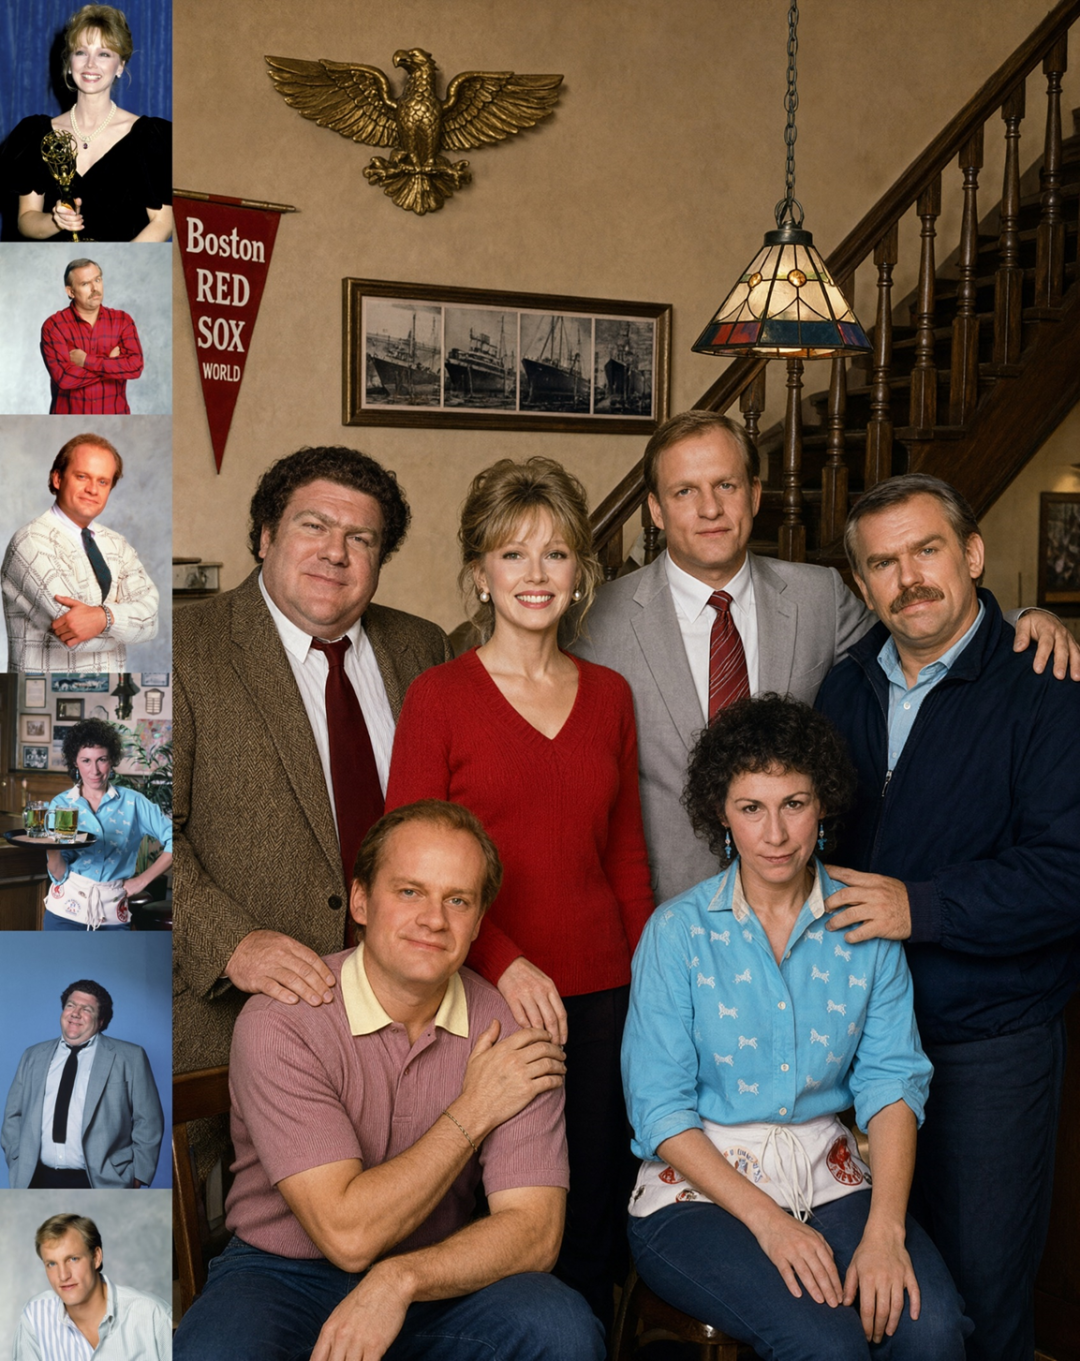
除此之外,Qwen-Image-2.1 另一个值得关注的变化,是将参考图数量提升至最多 10 张。这意味着模型不再局限于围绕单张图片进行编辑,而是可以同时理解并组合多个人物、商品或其他视觉素材。官方展示了几类典型场景:例如,输入 6 张不同人物的单独肖像,模型可以将这些人物组合到同一张多人合照中。
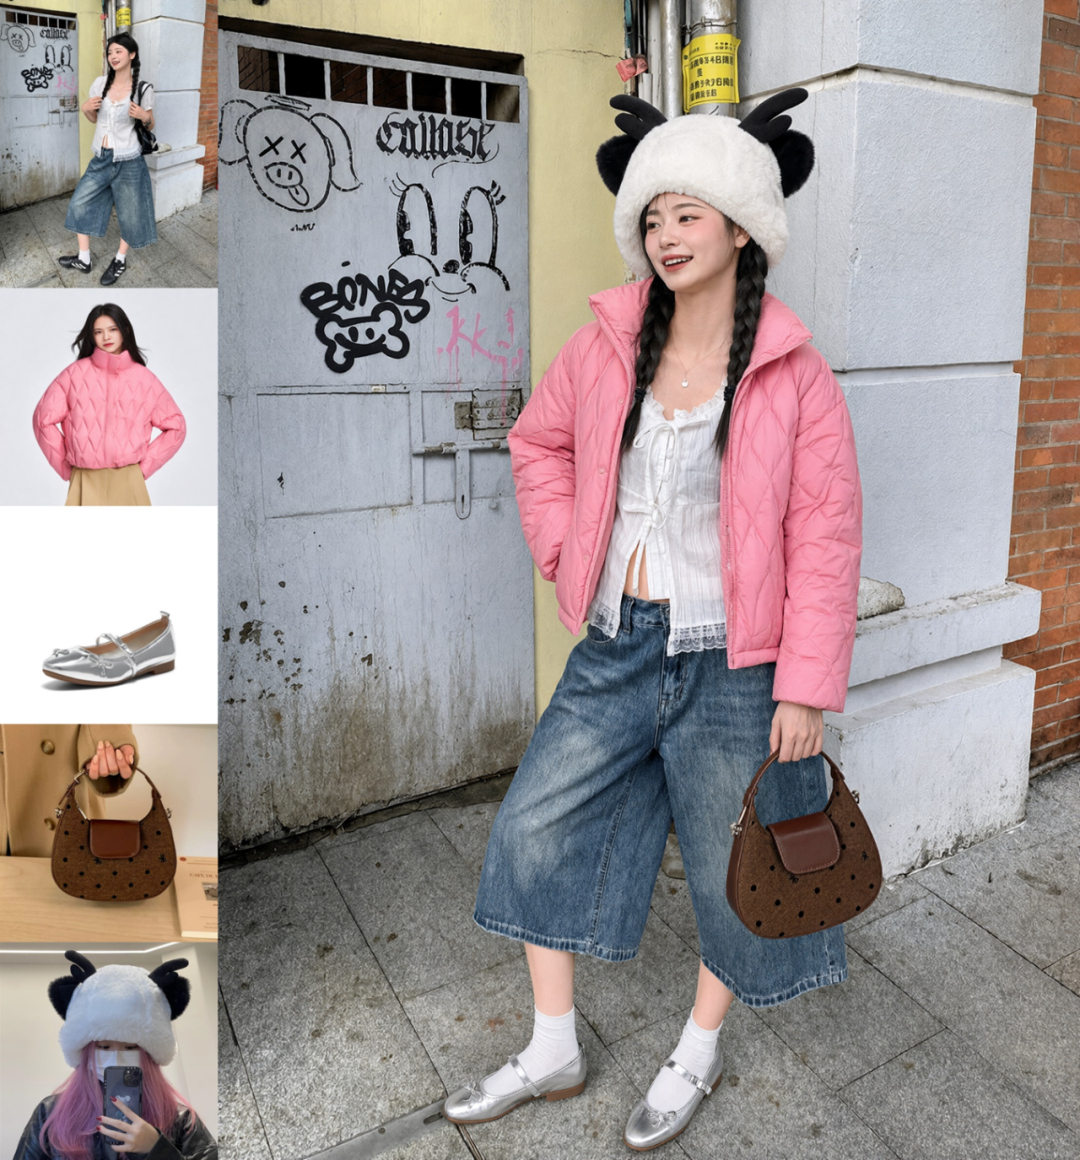
输入模特、服装、鞋子、包和帽子等 5 张参考图,可以生成一套完整穿搭。
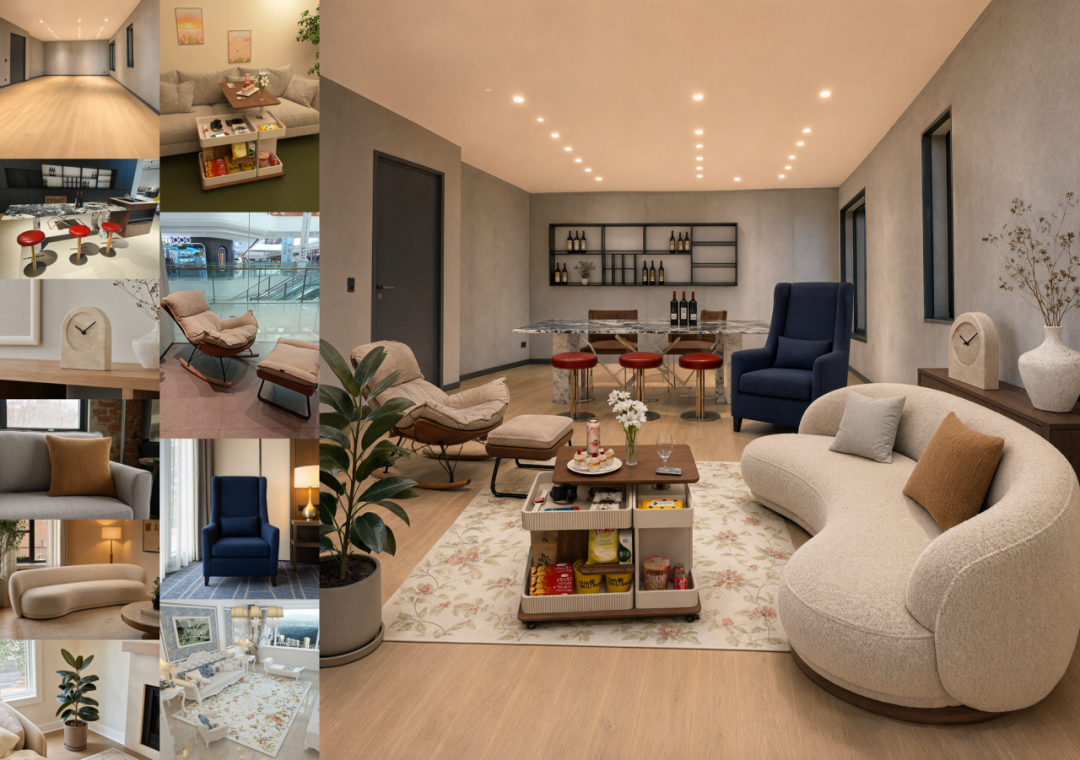
室内设计场景中,则可以一次输入 10 件不同家具,让模型根据这些素材重新组合出一个完整空间。
这也进一步满足了真实生产环境的需要。
电商人员可能已经拥有商品照片和模特照片;设计师已经有 Logo、IP 角色和品牌视觉规范;影视和游戏团队则拥有角色设定图、场景概念图和道具素材。真正困难的地方在于,如何让模型在理解这些既有图片之后重新组织它们,而尽量不破坏人物身份、商品外观和关键视觉元素。
除了支持最多 10 张参考图片,Qwen-Image-2.1 还提供多种局部编辑方式。用户可以使用圈选、涂抹或者独立掩码的方式,明确指出图片中需要编辑的区域。
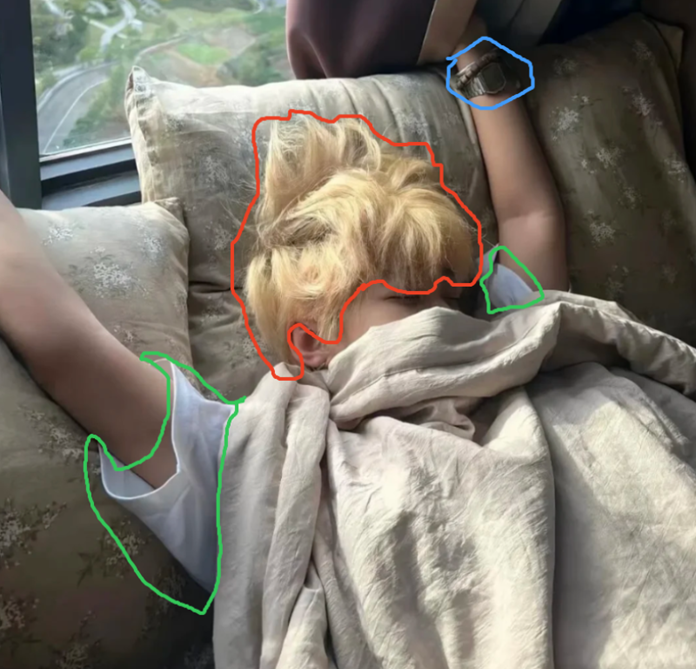
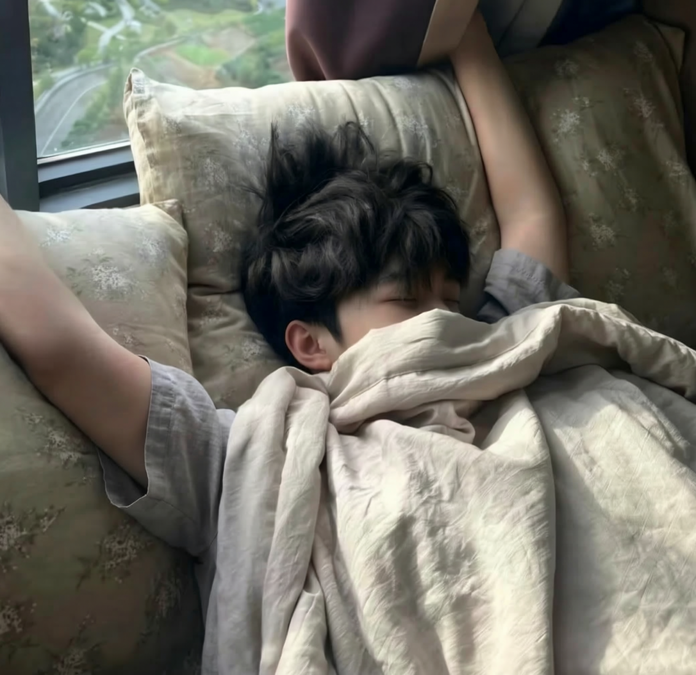
例如,千问展示的一组案例中,用户在同一张人物照片中圈出多个位置,同时要求模型删除手表、改变头发颜色并替换服装。最终,模型分别对指定区域进行了修改,同时尽量保留未被选中部分的原始内容。
对于位置更难用语言描述的编辑任务,Qwen-Image-2.1 还支持通过涂抹区域完成修改。例如,在一张包含鲨鱼的图片中,用户可以直接在鲨鱼右侧涂抹出目标区域,并要求模型在这里增加一名潜水员。相比单纯依赖文字描述位置,这种交互方式能够让用户更直观地指定新增或修改内容应该出现在哪里。
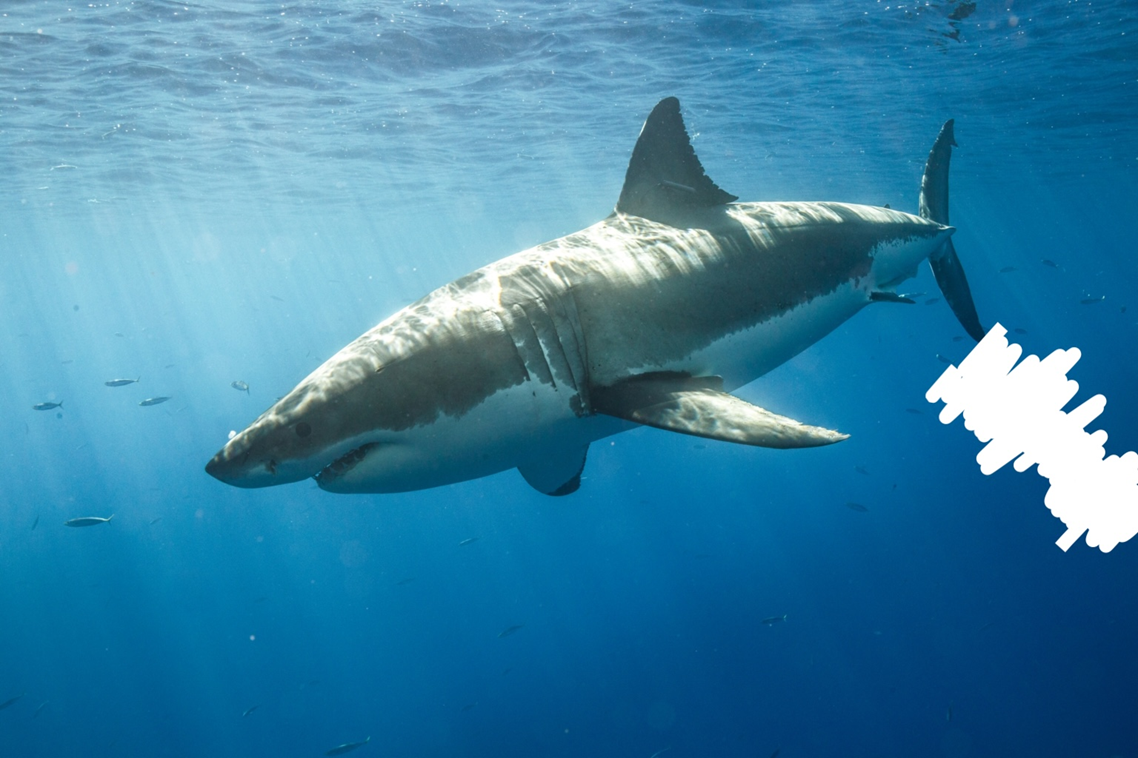
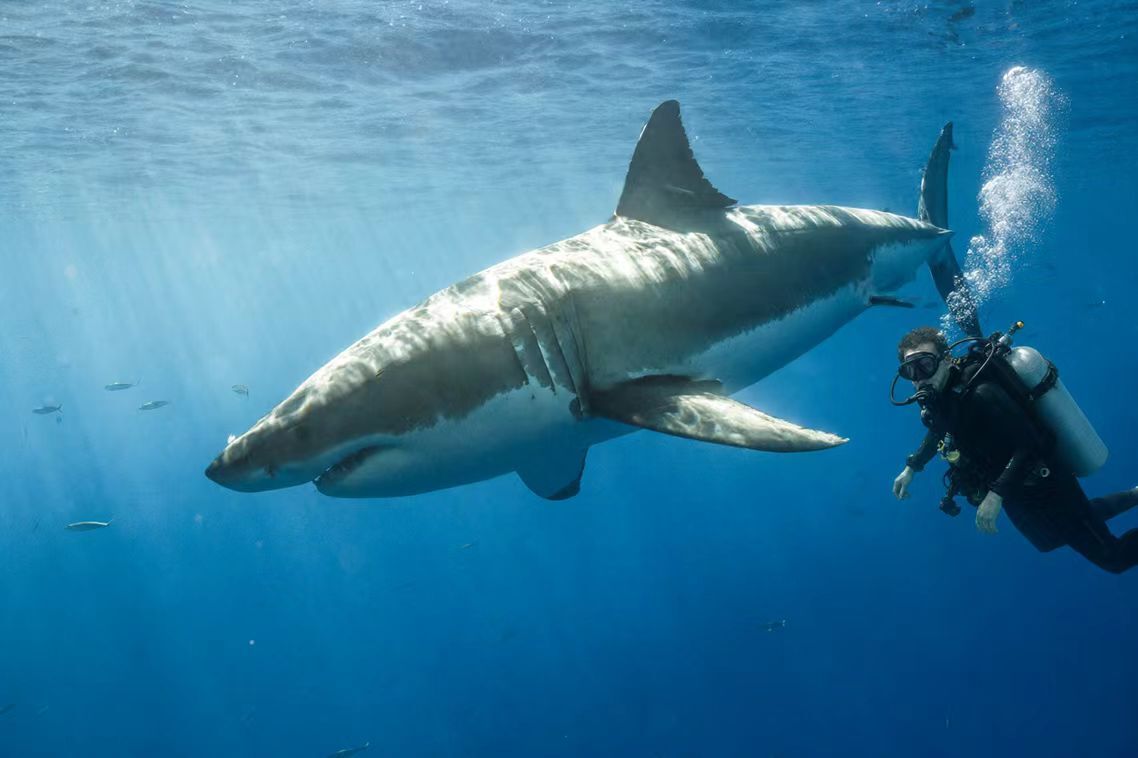
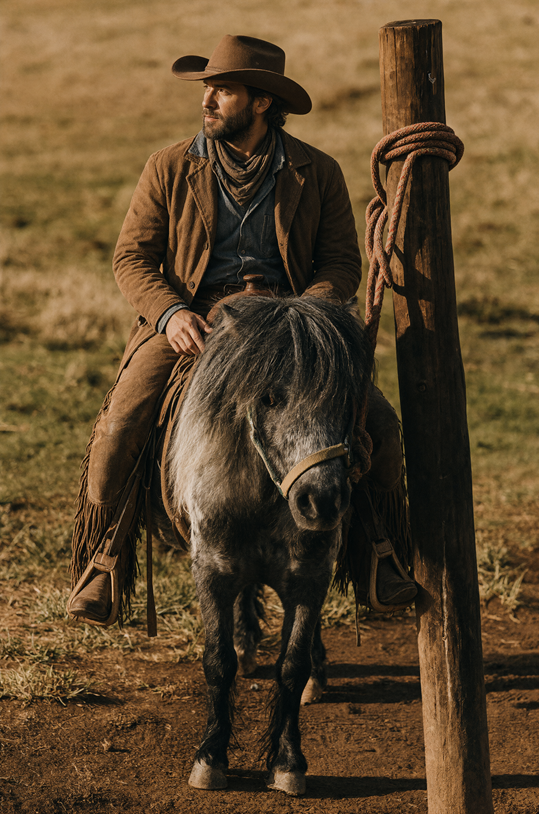
不过,无论圈选还是直接涂抹,标记本身都会覆盖原图中的部分像素。针对需要完整保留原始图像信息的场景,Qwen-Image-2.1 进一步支持将原图和独立掩码作为两张图片分别输入。官方展示的案例中,用户希望生成一名坐在马背上的牛仔,通过原始图片与独立掩码共同约束修改位置后,模型能够只针对指定区域完成内容生成。
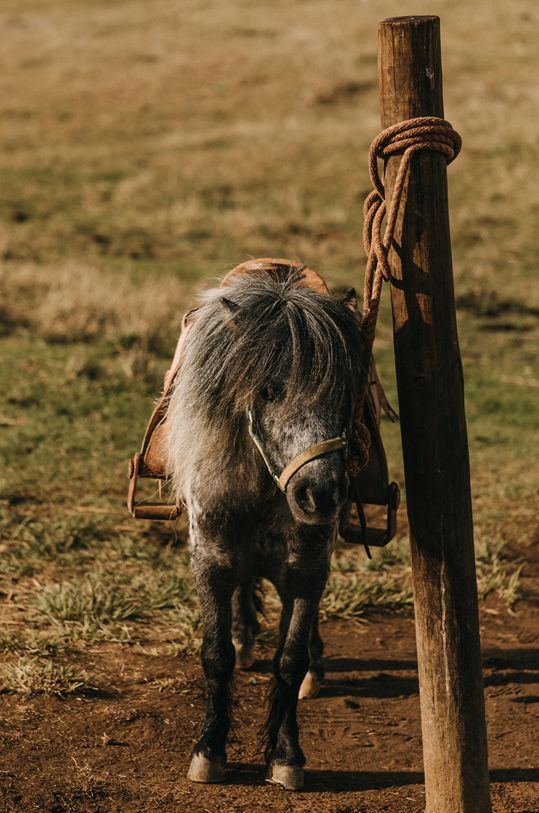
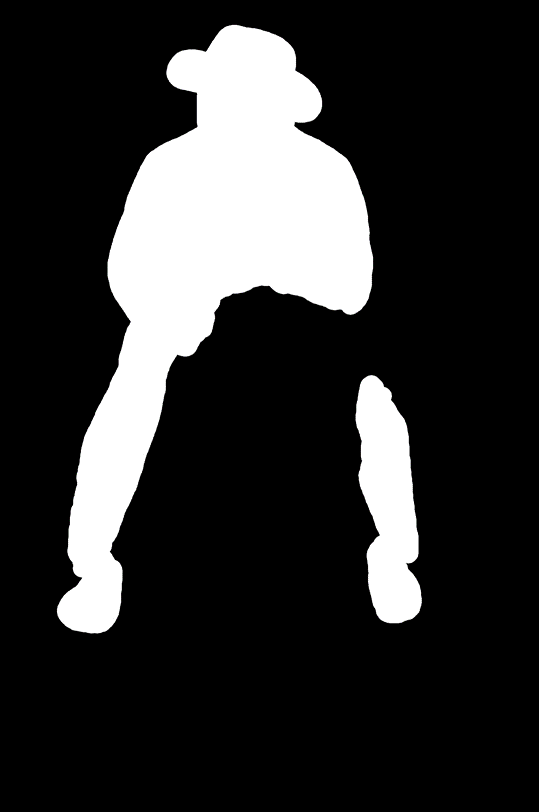
最后,模型根据掩码指定的区域完成图片的编辑,得到一张新的图片:
Qwen-Image-2.1 还重点提升了人物和商品的一致性。
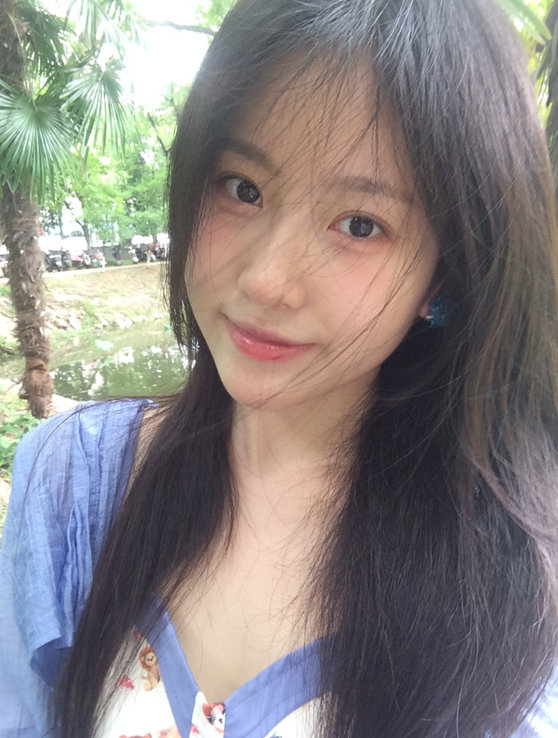
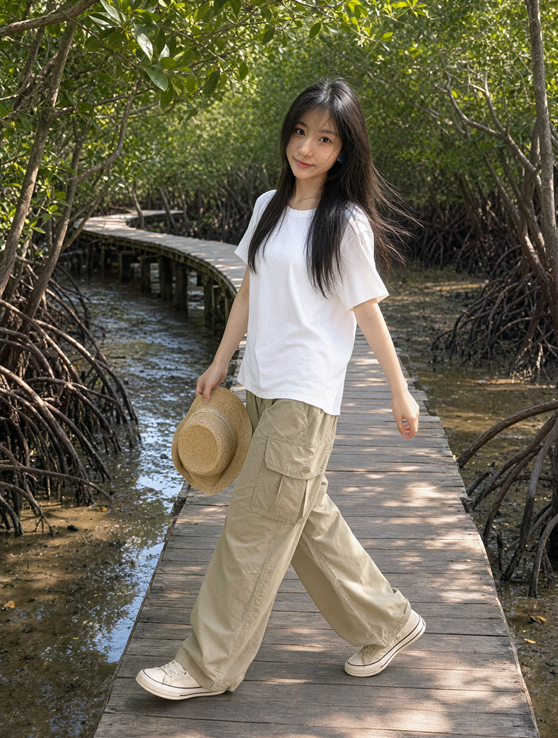
在人像编辑中,模型加强了对面部结构和细节特征的保持能力。在更换服装、背景或其他视觉元素后,人物的五官、面部轮廓以及整体身份特征与修图前的特征保持高度一致,降低连续编辑过程中出现“换了一张脸”的情况。
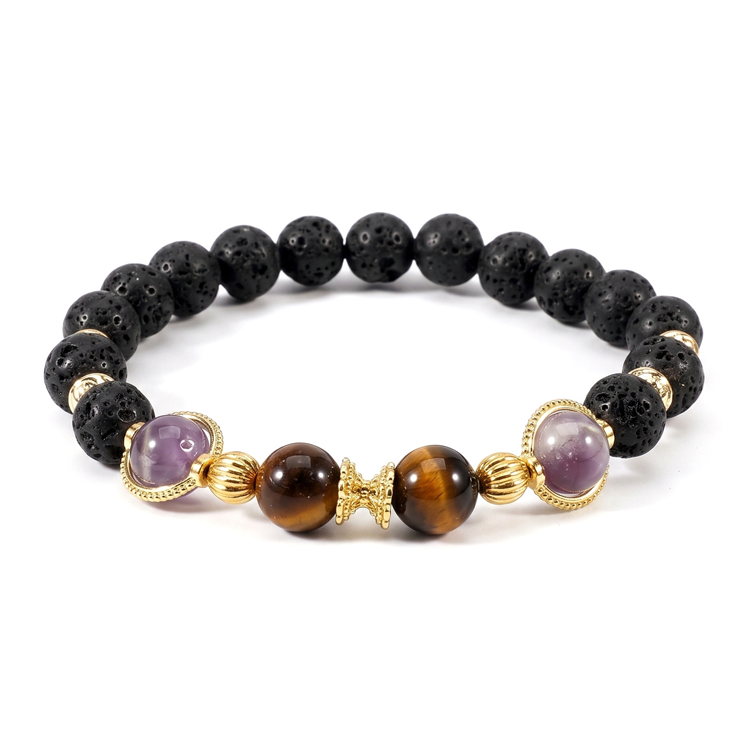
类似能力也被应用到商品编辑场景。模型会尽量保留商品原有的文字、纹理、颜色和形态,使商品被放入新的背景或重新构图后,仍然维持与原始素材接近的视觉特征。
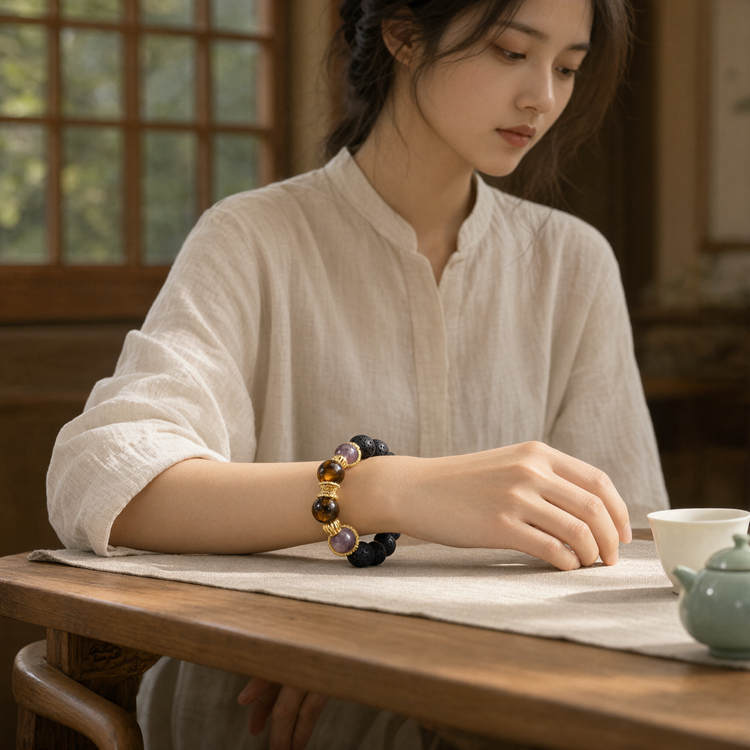
在局部编辑之外,Qwen-Image-2.1 还将生成能力扩展到了全景图、复杂信息图和分镜等不同任务中。
例如,输入一张自拍照后,模型可以向照片之外继续扩展场景,生成完整的全景图。
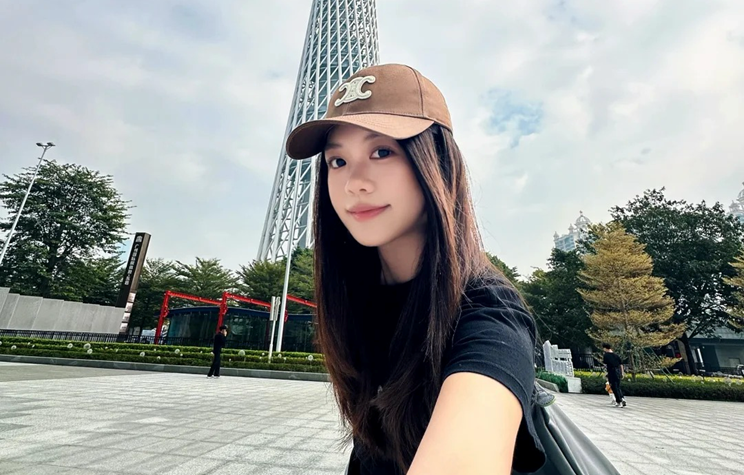
将生成结果导入支持全景浏览的可视化工具后,用户可以从不同方向查看完整环境。
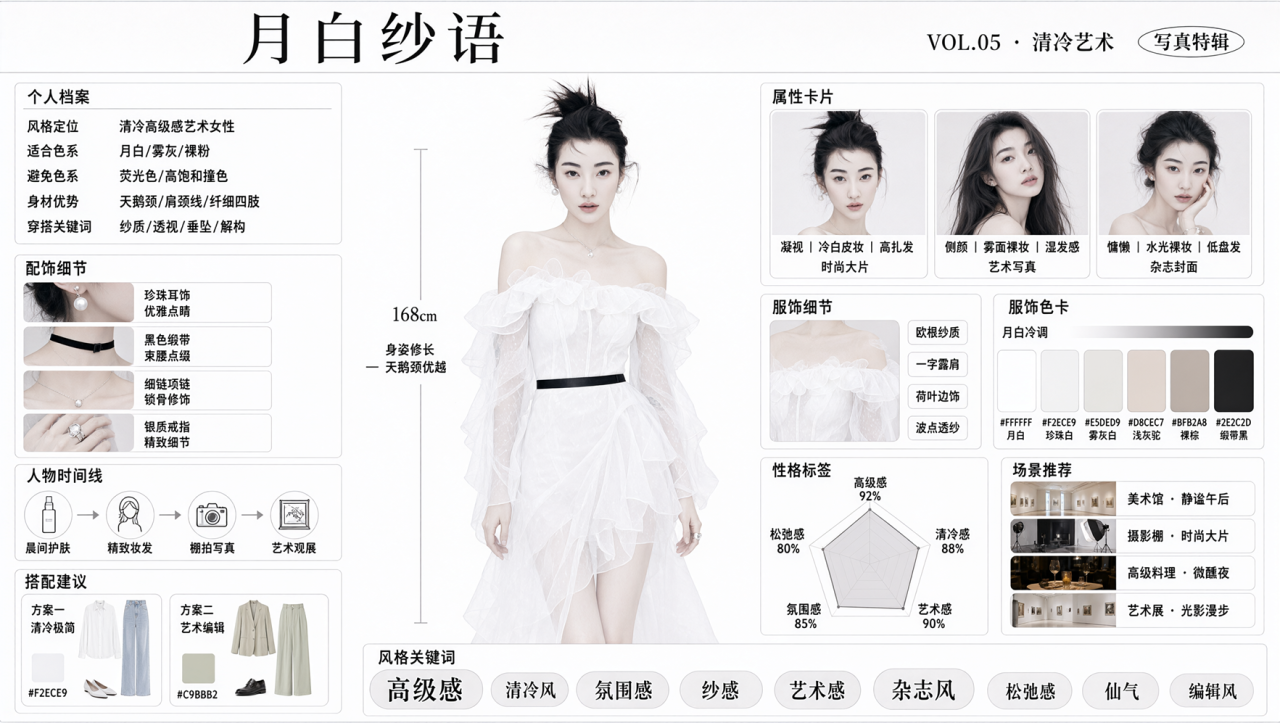
在信息图生成场景中,模型则可以以一张人物或商品照片为核心素材,进一步扩展文字、排版和视觉元素,生成结构更复杂的信息图。
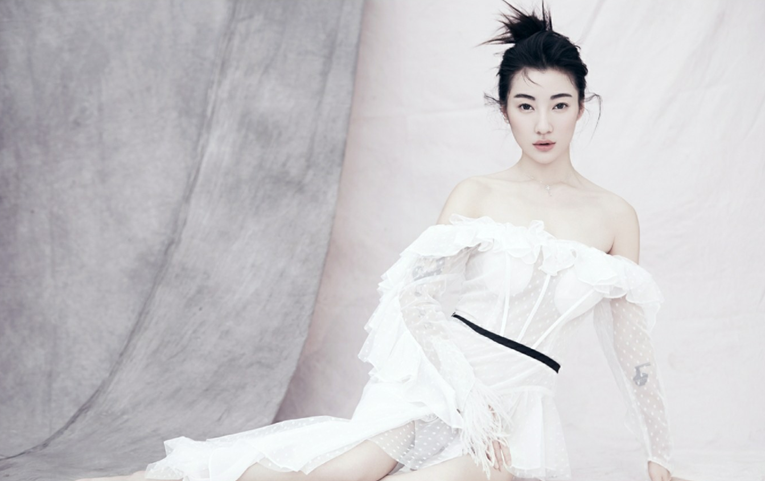
相比单纯生成一张视觉图片,这类任务同时要求模型处理主体、文字内容、布局以及不同元素之间的空间关系。
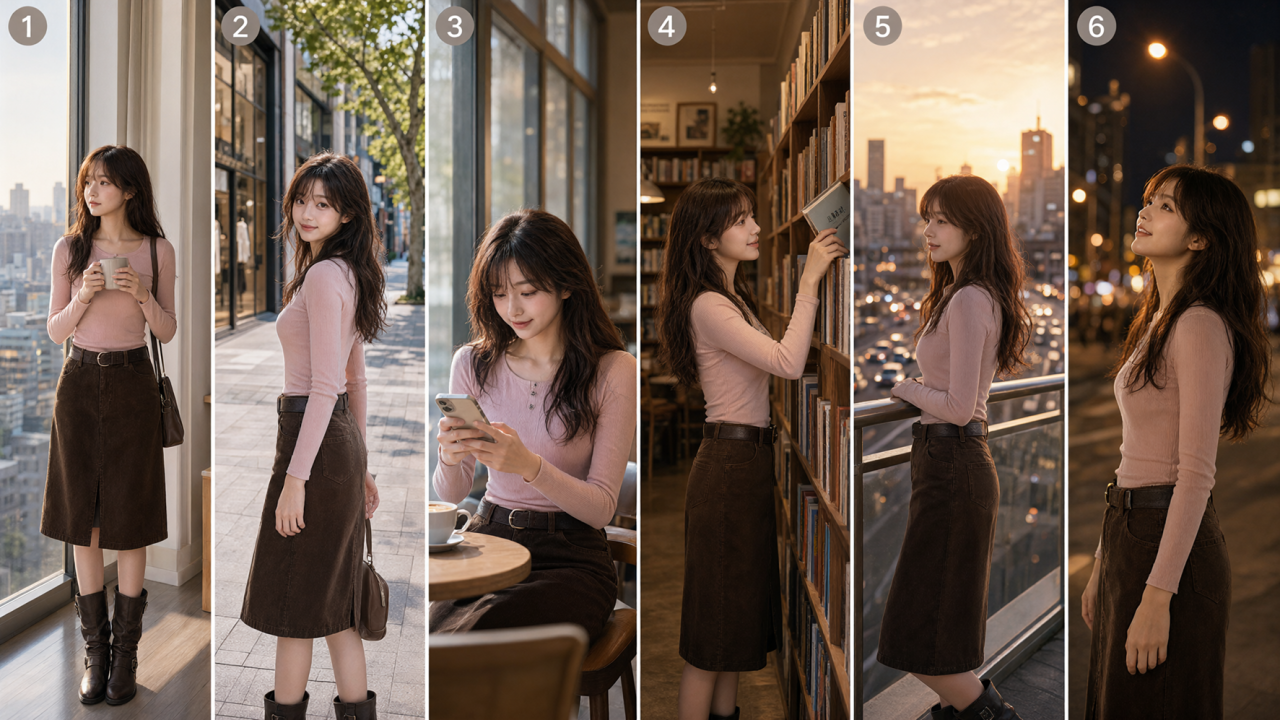
Qwen-Image-2.1 还支持依据人物三视图生成连续分镜。
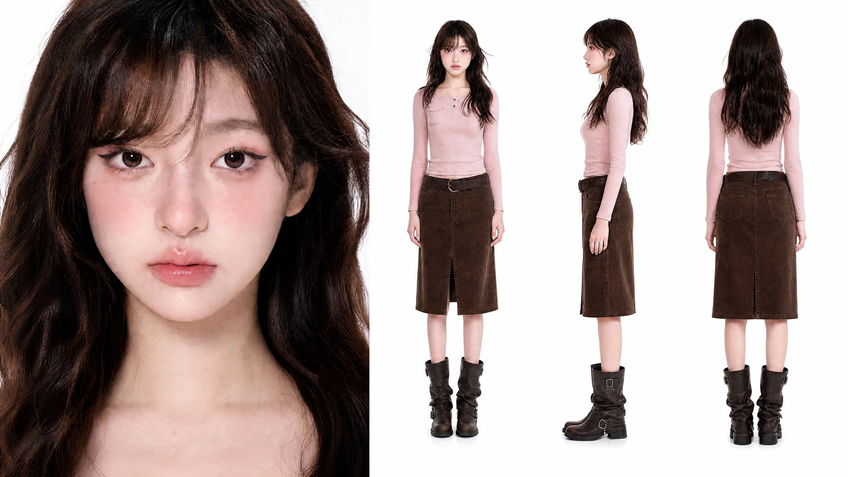
用户提供角色不同角度的参考图后,模型可以在保持角色主要视觉特征的基础上,将人物放入不同镜头和场景中,生成具有连续性的画面。这使其应用范围进一步延伸到漫画、影视预演、广告脚本和视觉叙事等内容生产场景。
生图之外,千问也在补强文字生成能力
长期以来,文字一直是图像生成模型的难点之一。模型即使能够生成“看起来像文字”的图形,也未必能够准确还原具体字符,因此过去不少 AI 生成图片中,经常会出现错字、漏字、字符变形甚至乱码,这也一度成为辨认 AI 生成图片的明显特征之一。
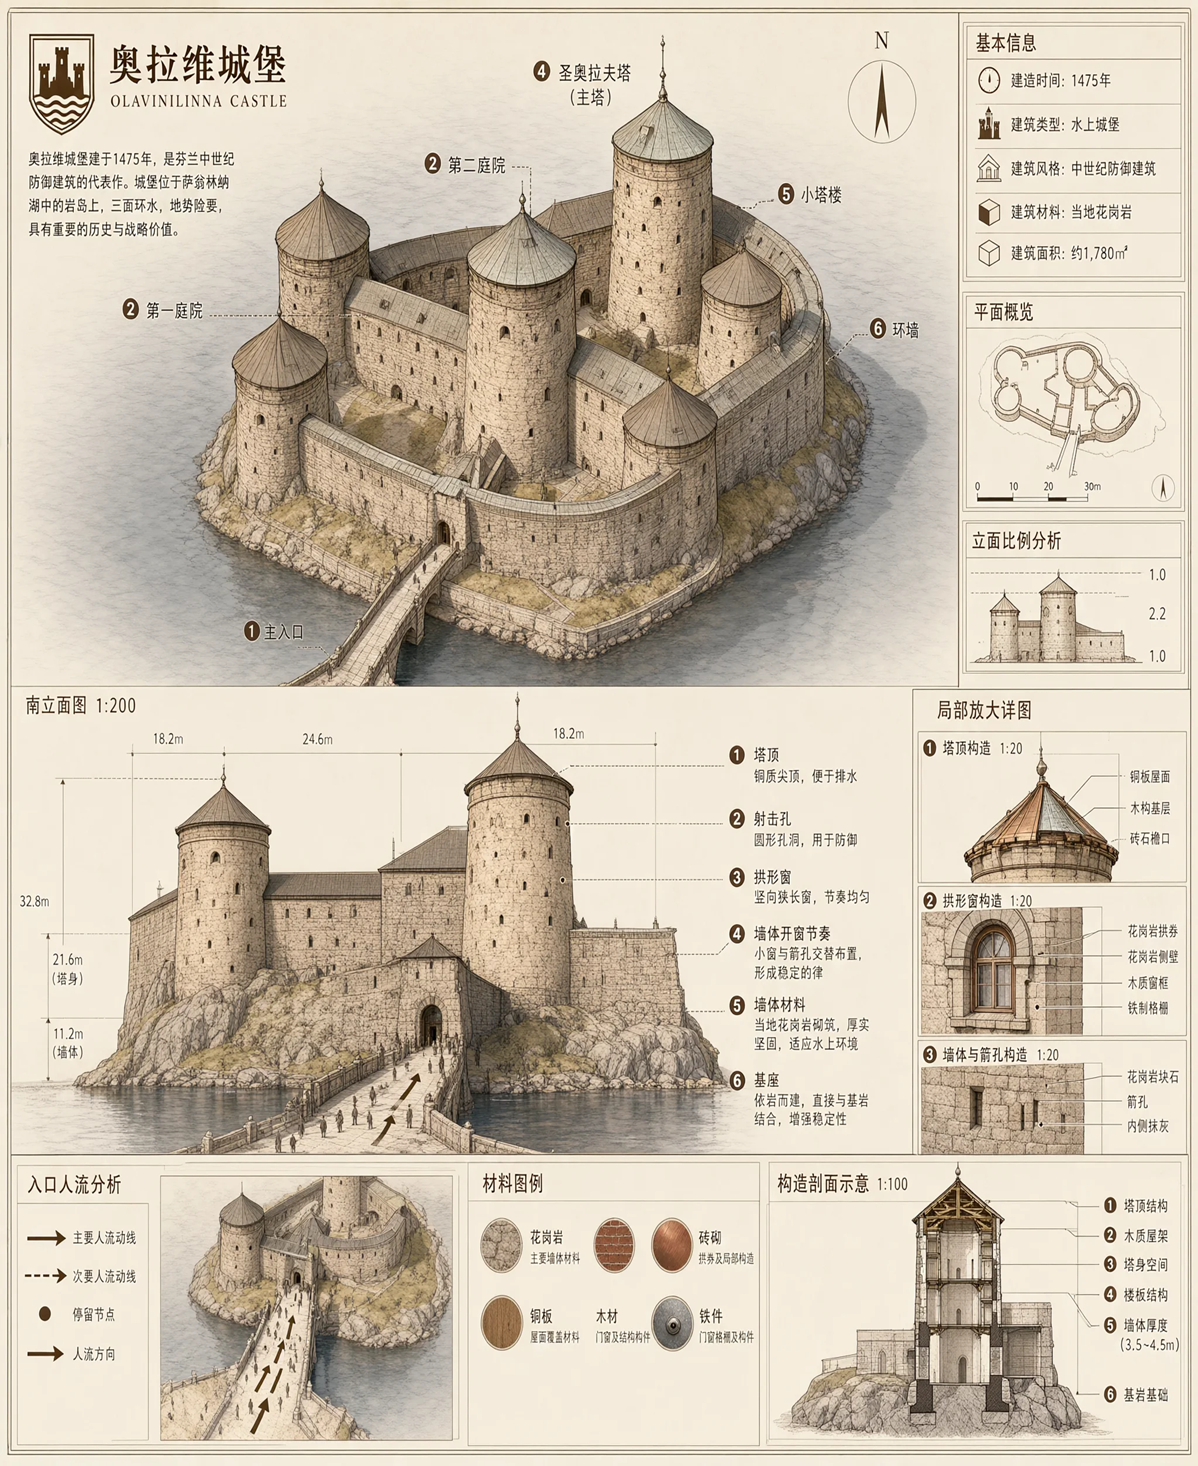
随着模型对文字语义、字符结构和视觉排版的理解不断增强。从 2025 年第一代 Qwen-Image 开始,中文和复杂文字生成就是千问图像模型的重要技术方向。到 2026 年 2 月推出 Qwen-Image-2.0 时,千问进一步强调专业信息图生成,模型可以接收最长 1K token 左右的复杂指令,并直接生成 PPT、海报、漫画等包含大量文字和版式结构的图片。
到了 Qwen-Image-2.1,千问关注的已经不只是“能不能把字写对”,而是进一步向文字生成的专业性推进。一方面,模型继续提升复杂文字内容的准确性;另一方面,千问也对字体风格、文字层级和排版关系进行了优化。文字不再只是被简单地“写”在图片上,而需要根据海报、广告、信息图等不同场景,与人物、商品、背景和其他视觉元素形成更协调的布局关系。
官方展示了不同海报和视觉设计场景下的文字生成案例。
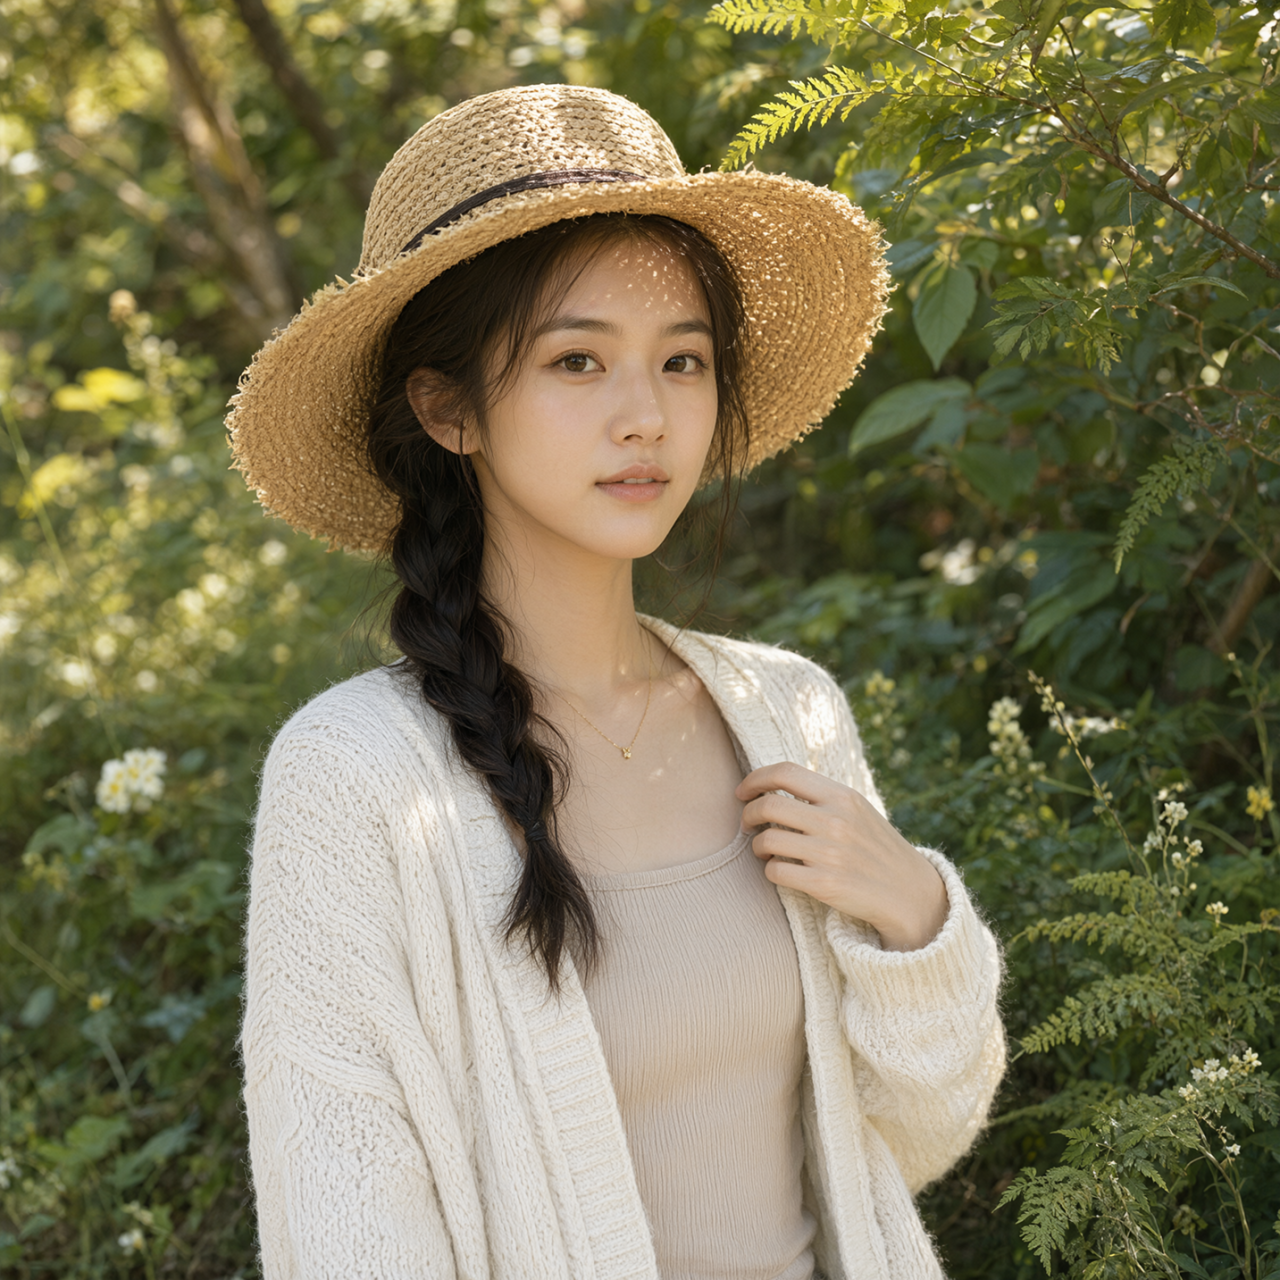
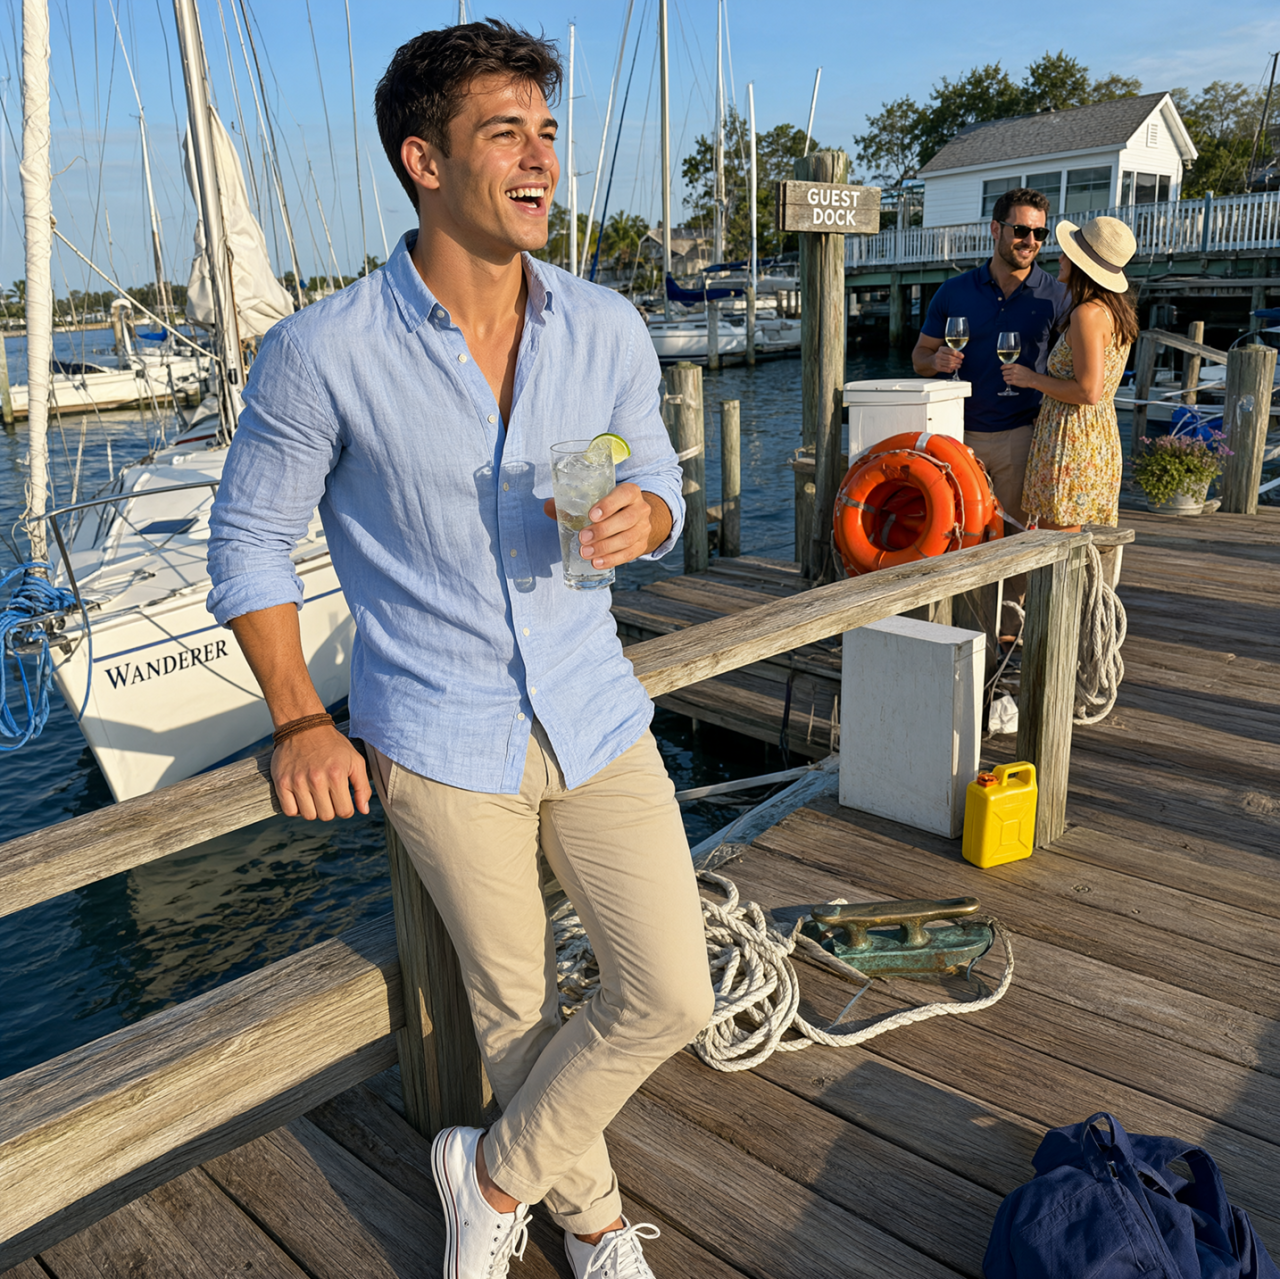
除了提升文字的美学表现,千问还进一步优化了人物图像中的光影、肤质和细节呈现,使人物在不同场景下的明暗过渡更加自然,皮肤质感和面部细节也更接近真实摄影效果。
从文字生成到多图编辑,我们实际测了测
功能列得再多,最后还是要回到一个最实际的问题:这些能力究竟能不能用?尤其是对于图像模型来说,官方 Demo 往往展示的是一次成功生成的结果,但真正进入工作流后,需求通常没有这么简单。设计师不会只要求“生成一张好看的图”,而是会不断提出新的要求。
所以这一次,我们没有把测试重点放在“随机生成几张漂亮图片”上,而是设计了更接近日常内容生产的场景,重点观察 Qwen-Image-2.1 的文字、多参考图以及图像一致性能力。
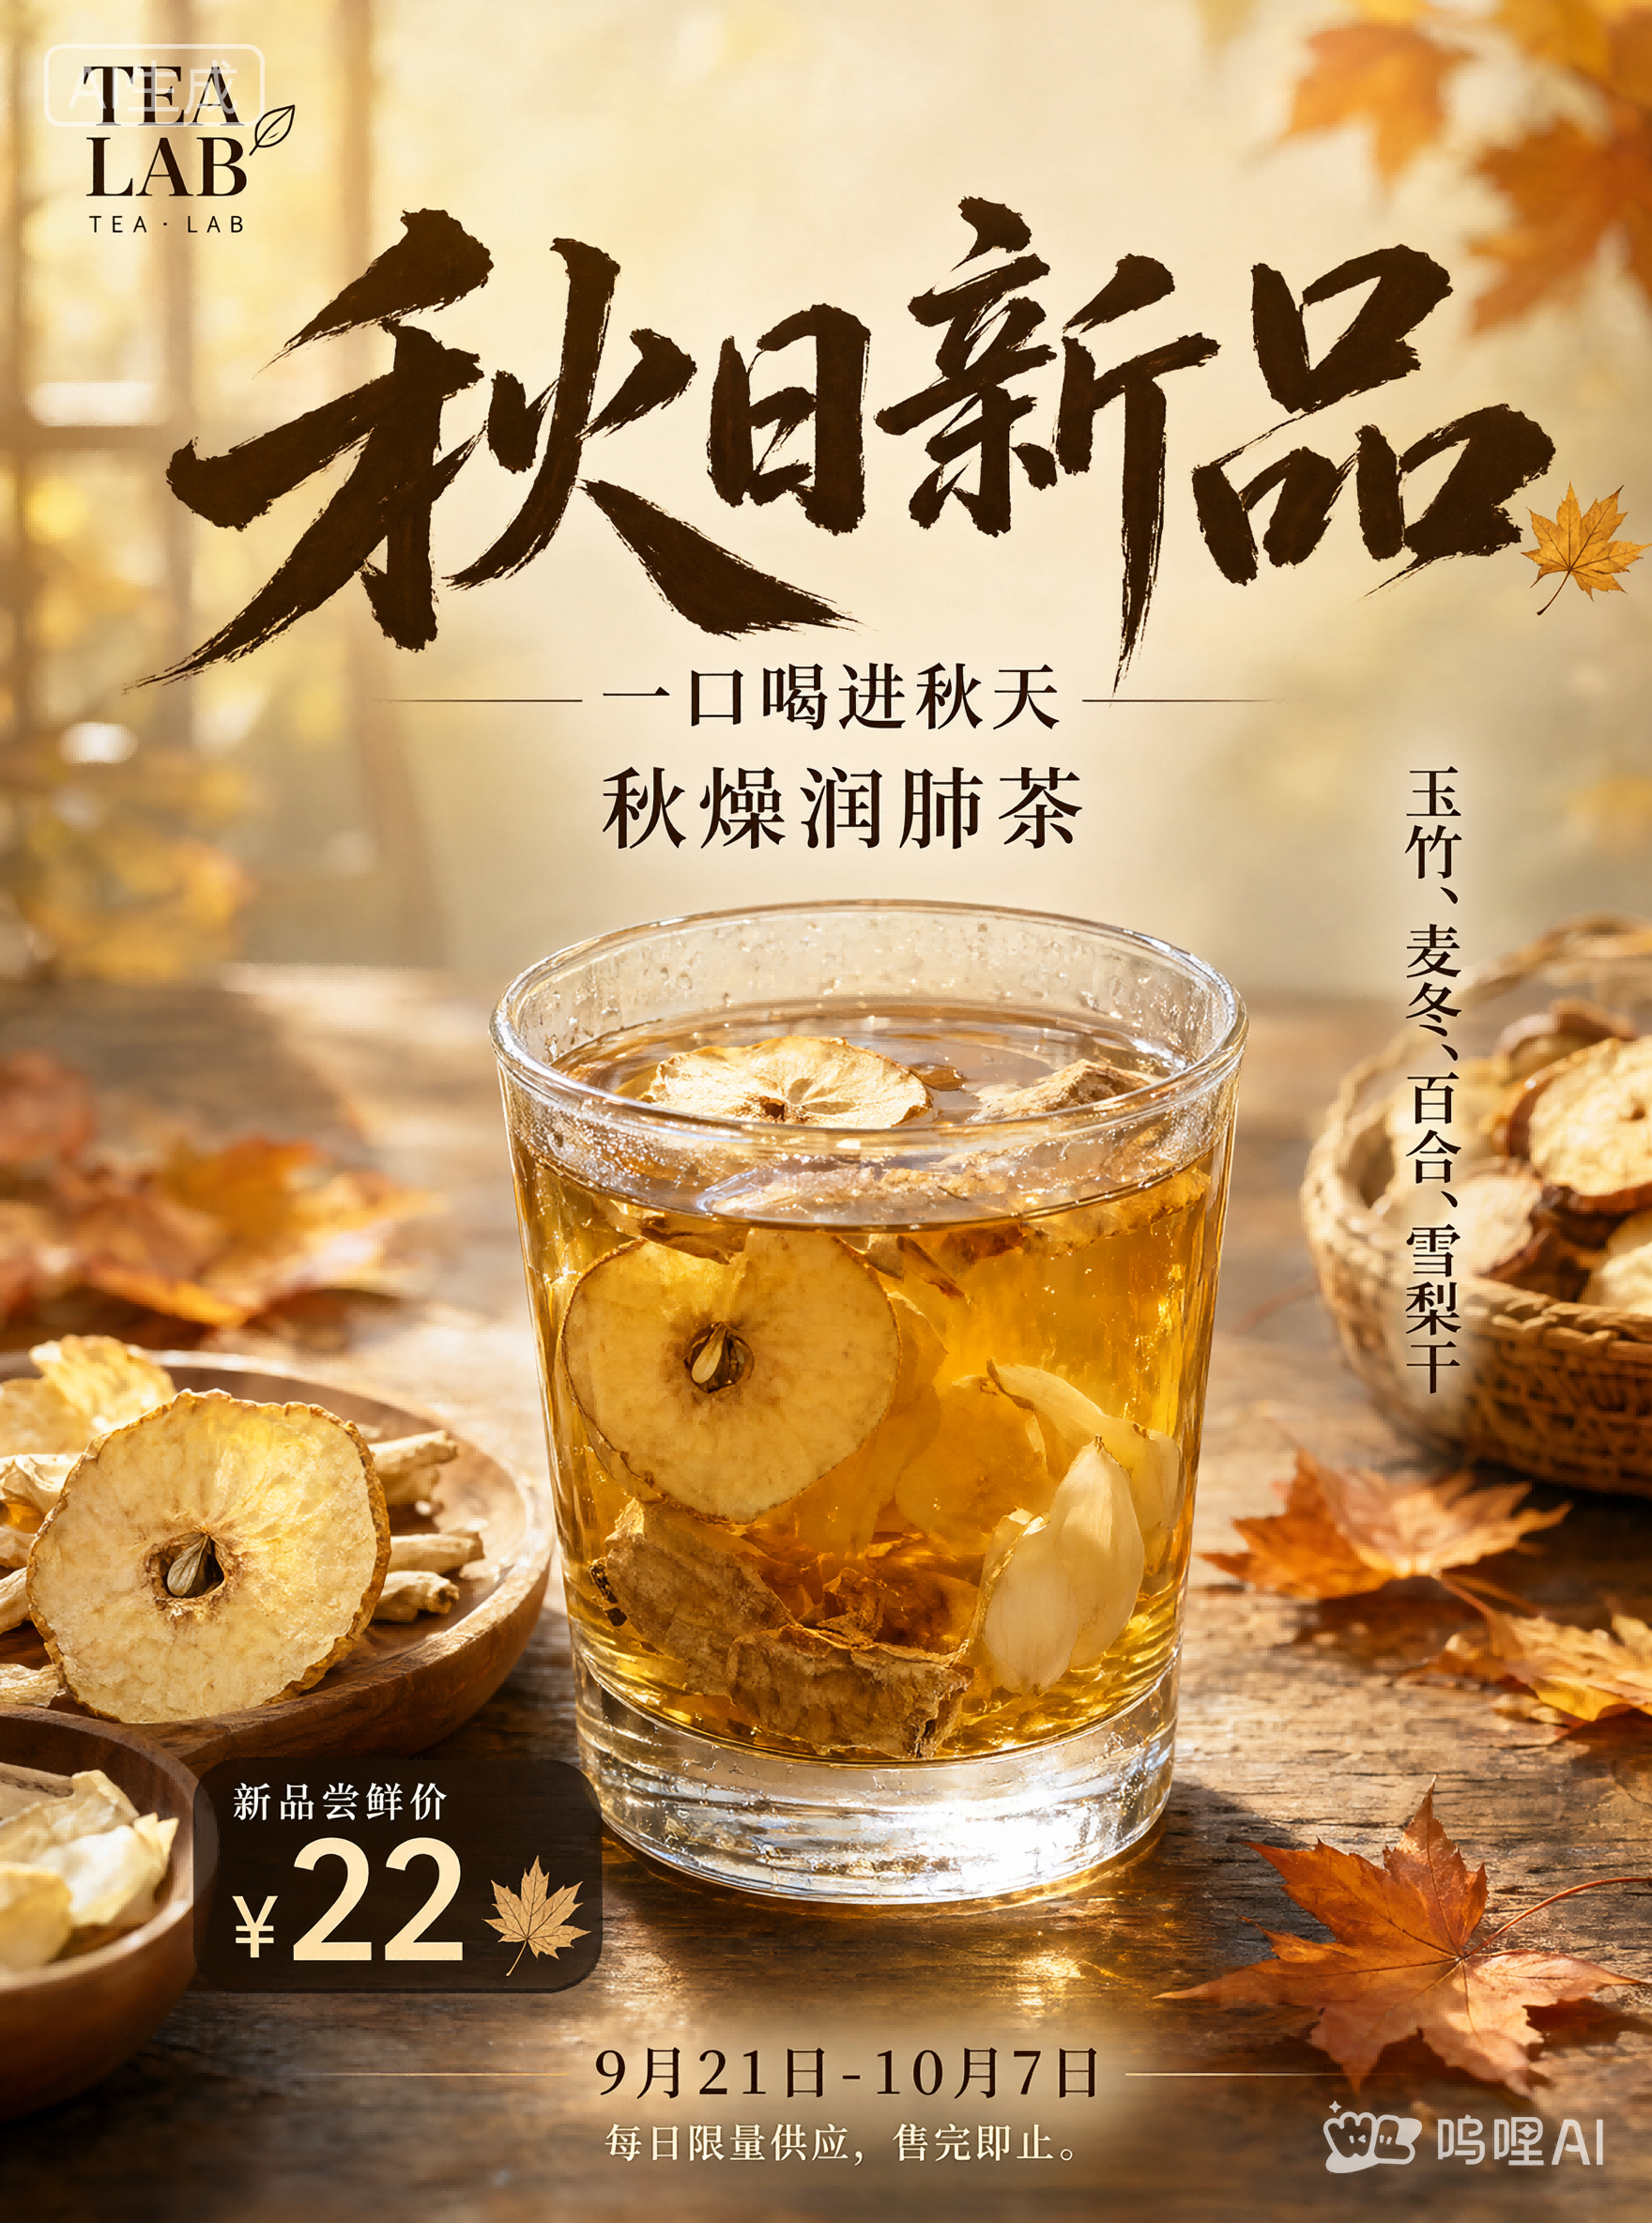
首先,我们给 Qwen-Image-2.1 安排了一项比较典型的商业设计任务——制作茶饮海报。我们给出了以下提示词,需求中同时包含主标题、产品名称、宣传语、价格、配料以及活动日期等文字内容。

我们观察到,整体上生成的文字没有出现错误,标题、副标题和正文具有清晰的信息层级,文字没有遮挡商品并且非常自然地融入画面,而非简单的堆叠。
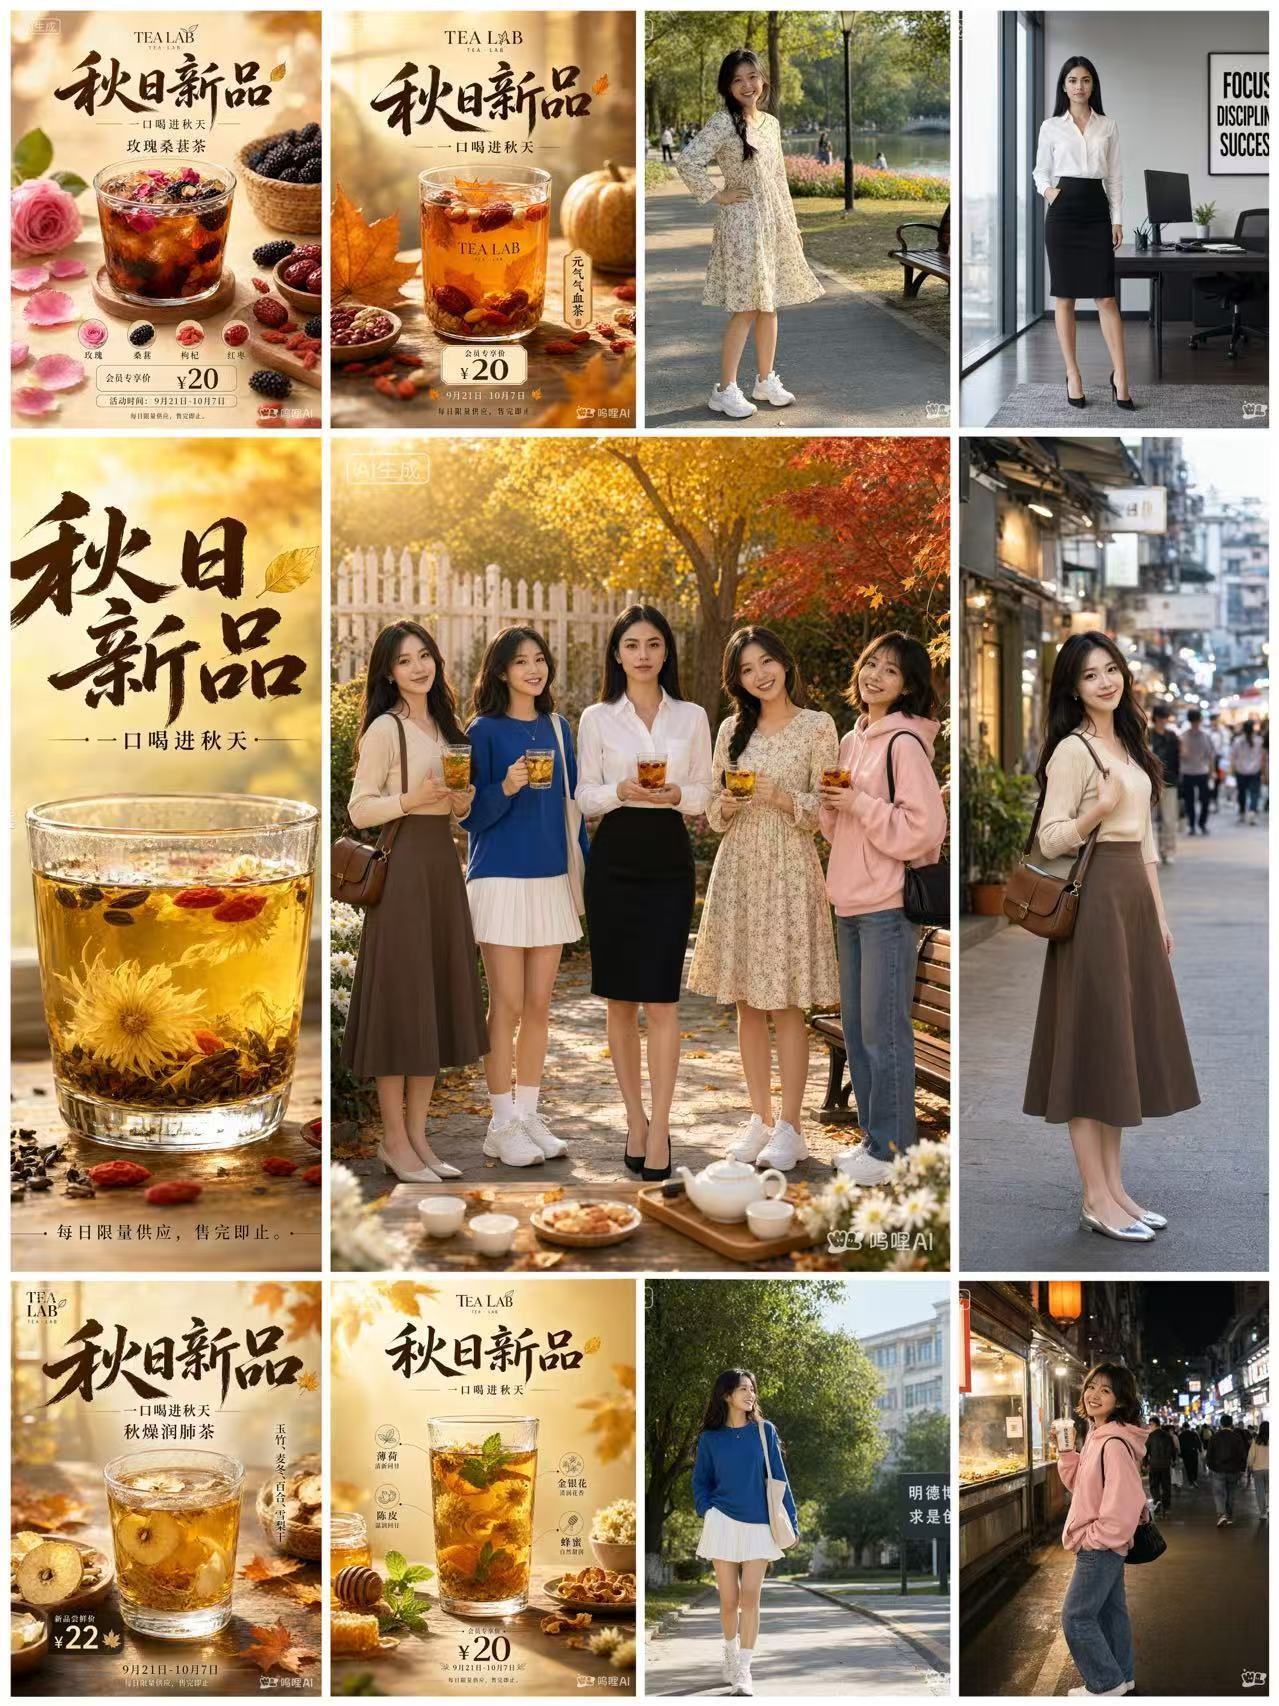
接下来,我们进一步测试 Qwen-Image-2.1 的多图编辑能力。为此,我们先用 Qwen-Image-2.1 一次性生成了 10 张不同的图片,其中包括 5 位女孩和 5 杯不同的养生饮品。随后,我们将这 10 张图片同时作为参考图输入模型,并要求 Qwen-Image-2.1 生成一张广告海报:让 5 位女孩分别拿着不同的养生茶,在花园里享受秋日午后时光。这个测试主要想观察,在同时接收多张人物与商品参考图的情况下,模型能否准确识别不同素材之间的对应关系,并在重新构图后尽量保留人物特征、饮品外观以及整体画面的协调性。
从生成结果来看,整体完成度较高。饮品与对应人物基本能够准确匹配,即使在多主体组合场景下,也保持了较好的一致性。不过,部分细节仍存在偏差,例如个别人物的鞋子与原图不一致,两名女孩手中的饮品出现了重复。此外,多图生成的整体耗时仍然偏长,在生成效率上还有一定提升空间。
一个容易被“开源”二字忽略的问题:这次不是 Apache 2.0
不过,如果企业或者开发者准备将 Qwen-Image-2.1 真正用于产品,还有一个不能忽略的问题:许可证。
虽然千问官方此次将 Qwen-Image-2.1 描述为开放权重模型,模型权重也确实已经公开下载,但其 GitHub 仓库采用的并不是此前 Qwen-Image 使用过的 Apache 2.0,而是新的 Qwen Research License Agreement。
许可证明确将“Non-Commercial”,仅用于研究或评估,并规定当前授权范围为非商业目的。如果希望将 Qwen-Image-2.1 用于商业用途,需要另外向千问申请商业授权。协议同时要求,如果使用该模型材料或输出进一步创建、训练、微调或改进并公开提供其他 AI 模型,应在相关产品文档中注明“Built with Qwen”或“Improved using Qwen”。


