一份 AI 存储榜单,人们通常先看速度。
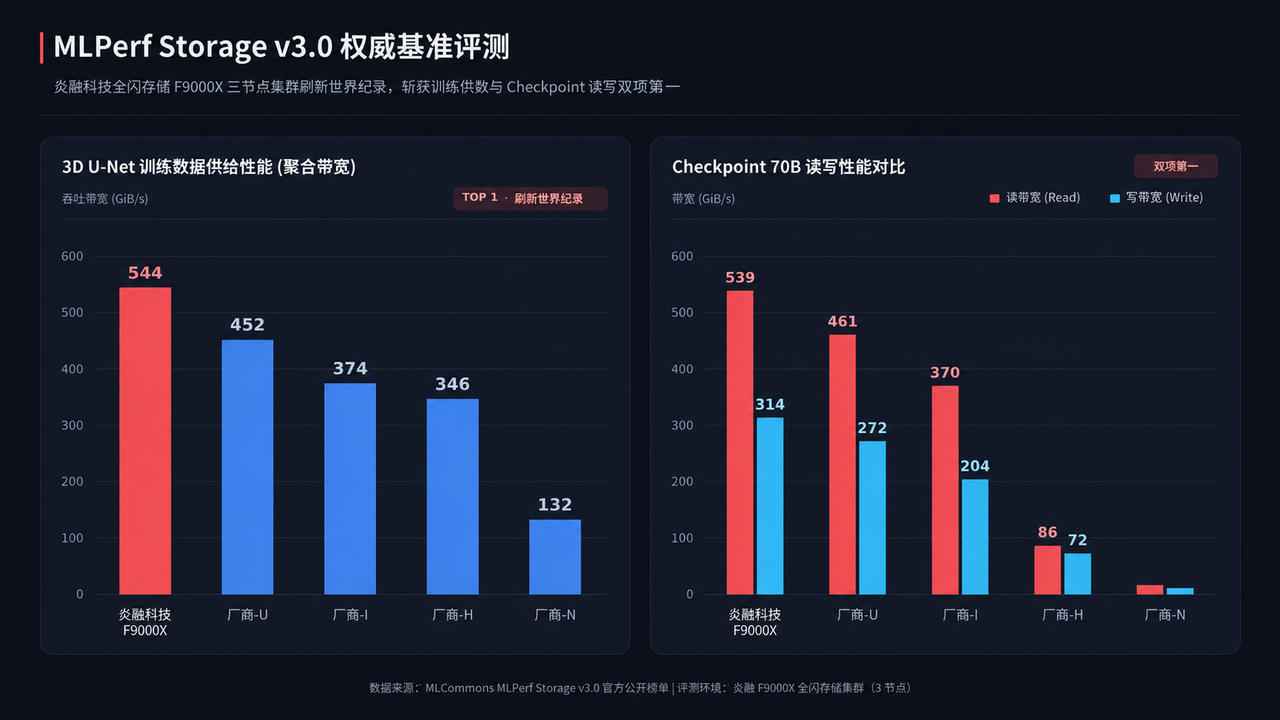
InfoQ 注意到,在日前公布的 MLPerf Storage v3.0 评测结果中,焱融科技 F9000X 三节点集群在 3D U-Net 训练数据供给测试中实现了 544GiB/s 的聚合带宽,并在 Checkpoint 70B 测试中取得读、写带宽双项第一。
但比成绩本身更值得注意的,是这一轮评测开始考察什么。
MLPerf Storage v3.0 新增了 KVCache 测试项,模拟多轮会话中的 KV Cache 整体写入与回读,并报告模拟输出 Token 吞吐、读写带宽和 P95 读取时延。这意味着,存储要处理的对象,从预先准备好的数据集,延伸到了推理过程中产生的运行时状态。
过去,AI 存储的核心任务是持续、稳定地为 GPU 供数——它服务于计算开始之前。而现在,它被要求让一次已经完成的计算继续发挥作用,也就是进入推理过程内部。
焱融从训练存储起步,到推出 AI 原生推理存储系统 YRCache,再到发布共享缓存一体机 ContextBox,恰好为观察这一变化提供了一个具体样本。
一、那些不该有的等待,和“重新算一遍”的浪费
在训练阶段,存储的核心矛盾始终是数据通路。
一方面,数据供给跟不上,GPU 就会被迫空转;另一方面,训练中需定期写入用于容灾的 Checkpoint,写得慢拖累有效算力,读得慢则拉长恢复时间。
高带宽、高并发和低延迟的吞吐性能,因此成为 AI 存储的基本功。
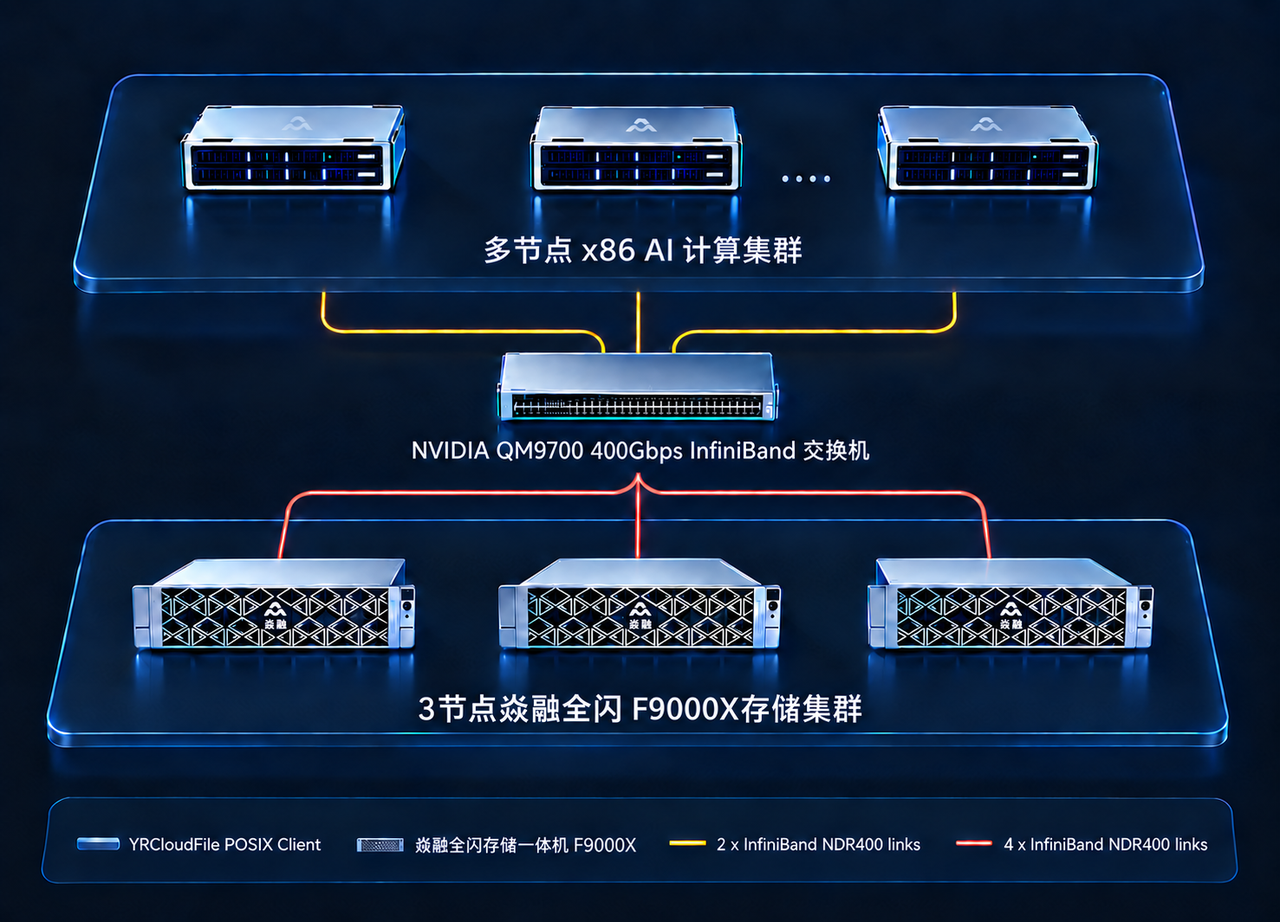
焱融全闪存储 F9000X 跑出的成绩,印证的正是这种极致的数据通路能力,其解题思路也足够清晰:尽可能减少计算对数据的等待。
推理同样需要这些基本功,但它引出了一类性质完全不同的问题。
大模型处理请求时,需先解析输入上下文完成预填充(Prefill),随后逐 Token 生成答案。输入越长、提示词越复杂、对话轮次越多,预填充消耗的算力和时间就越惊人,往往成为推理成本和响应延迟的主要瓶颈。
在 Transformer 架构中,已计算的 Key 和 Value 会被保留为 KV Cache,供后续 Token 生成时直接复用,避免反复计算上下文。若不同请求之间存在相同的上下文前缀(如系统提示词、长文档背景),理论上这部分计算状态也能跨请求复用,省去重复的预填充开销。
但要从“单次生成内部的缓存”走向“跨请求的全局复用”,中间隔着的并非一次简单的数据读取,而是三重相互牵连的系统工程挑战:
首先,内容相同,不等于缓存可用
同一份文档,只要系统提示词微调、Prompt 模板改动或 Token 序列微移,复用前缀就会失效;模型版本、KV Cache 精度格式哪怕稍有不一致,缓存也无法通用。系统复用的是严苛匹配的物理计算状态,而非文本本身。
其次,显存有限,缓存未必留得住
GPU 显存既要容纳模型权重,又要承载并发任务的运行时上下文。未被即时命中的缓存,只能在显存中被动淘汰,或被迫换出至主机内存与本地 SSD,面临更高的二次装载开销。
最后,节点孤立,留得住也未必用得上
首个请求由 A 节点计算并生成了缓存,后续带相同前缀的请求却可能被调度至空闲的 B 节点。若缺少跨节点共享机制与缓存感知的调度能力,缓存留在 A 节点的本地磁盘上便如同孤岛,B 节点依然只能“从头再算一遍”。
至此,推理侧的存储问题已超越单纯的读写速度,转变为一套系统级的权衡:哪些缓存值得存、存在哪里、存多久;后续请求如何高效命中;以及取回缓存的代价,是否真正低于重新计算。
训练的目标是让 GPU 少等数据,推理的目标则是让 GPU 少做重复计算。 单纯提高读写带宽只能加快数据搬运,但若无法解决状态匹配、跨机共享与全局调度,便无法真正释放上下文复用的价值。
二、将 Kv Cache 管起来之后,还要跨节点
将 KV Cache 从显存卸载,是留存更多上下文的最直接手段。
在单机架构中,焱融采用了三级分层:G1 为 GPU 显存,G2 为主机内存,G3 为本地 SSD。层级越往下,容量越大、单位成本越低,但回读到计算端的延迟与搬运开销也越高。YRCache 的首要任务就是统筹这套单机分层:通过内存配额、资源隔离与多盘 NVMe 聚合,在保障低延迟的同时实现缓存的高效换入换出。
但单机内的分层调度跑通,并不意味着问题就此解决。推理系统绕不开的真正瓶颈,是跨节点复用。
设想一个典型场景:A 节点刚完成一次长文档问答,并将生成的 KV Cache 写入了本地 SSD;数分钟后用户追加提问,此时 A 节点正忙,请求被调度器分配给空闲的 B 节点。
系统随即陷入两难:
1、要么把请求重新塞回 A 节点:虽然省去了缓存搬运,但必须忍受排队延迟;
2、要么把缓存从 A 节点拉取到 B 节点:看似合理,却缺乏一条专用的低延迟传输通路。
指望单机本地 SSD 解决跨机共享并不现实。即使持续堆砌单机硬盘容量,也无法提供集群级的服务能力——其他节点既缺乏全局发现与索引机制,也无法规避单机故障、离线导致的缓存丢失。
那么,直接把缓存写入既有的分布式共享存储是否可行?
这笔账同样不划算。传统共享存储面向模型权重、训练数据和 Checkpoint 设计,强调强持久化、高可靠与全局一致性;而 KV Cache 是一种允许丢弃、可重新计算的瞬态中间状态,具有高频访问、毫秒级延迟敏感、生命周期短等特点。传统共享存储的问题不在于“能不能存”,而在于无法以合理成本满足这种短生命周期的低延迟访问。
F9000X 这类高性能存储提供了极致的数据通路,但通用存储并不等同于专用的缓存管理与跨节点复用体系。ContextBox 瞄准的,正是本地 SSD 与传统持久化存储之间的系统空白。
作为一台独立的共享缓存一体机,ContextBox 在焱融的体系中被定义为 G3.5 层。它与计算节点解耦,提供了一个由多个推理节点并发访问的全局缓存池:
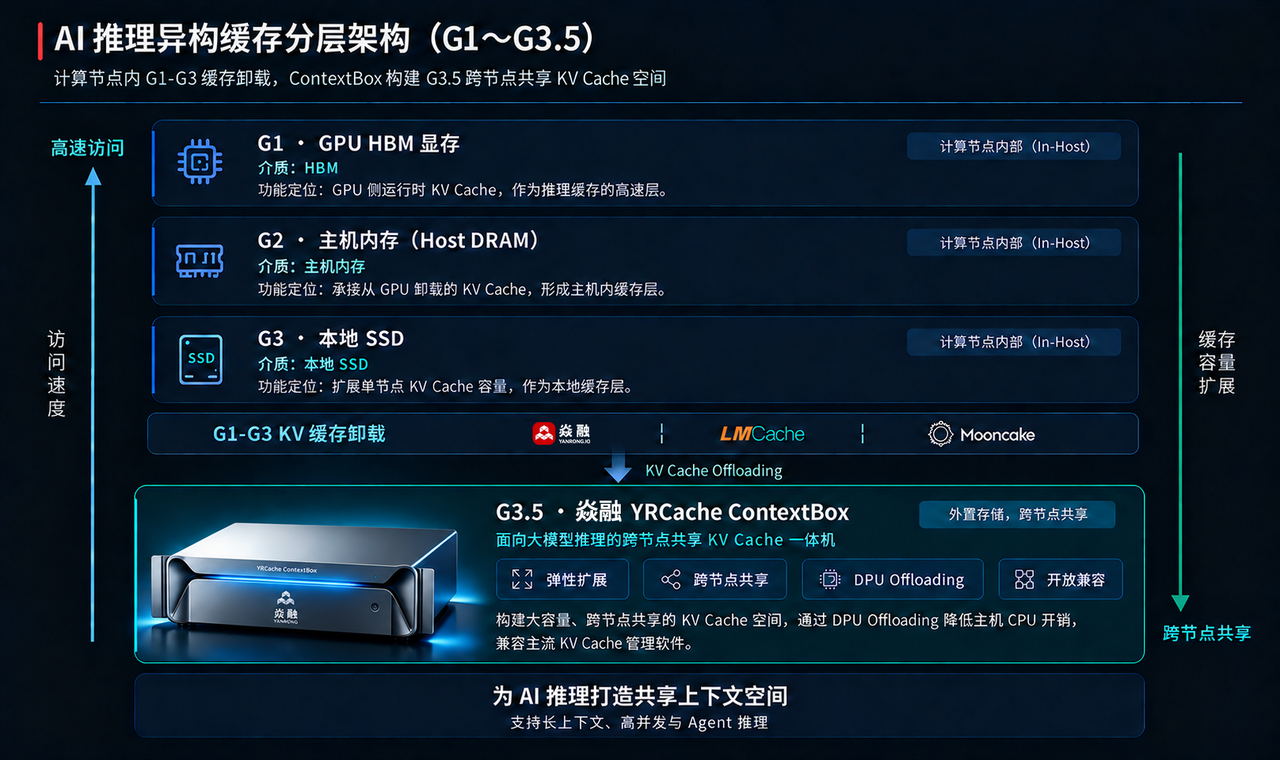
硬件协同:搭载最多 26 块 U.2 NVMe SSD 提供高并发容量池,配置 4 块 NVIDIA BlueField-3 双口 200Gb DPU 卸载数据路径以释放主机 CPU,并通过 RDMA/RoCE 网络提供 120GB/s 实测带宽,单台可支撑 8 节点集群的高并发吞吐。
软硬配合:硬件负责打通高吞吐的共享数据通道,上层则由 YRCache 负责缓存匹配、生命周期管理与跨级流动,同时兼顾兼容 LMCache、Mooncake 等生态。
至此,整套分工与层级逻辑严密闭环:
G1 ~ G3(计算节点内):显存、内存与本地 SSD,消化单机内的高速命中与分层卸载;
G3.5(独立共享层):ContextBox 提供多节点共享的高性能缓存池,打通跨机流转;
G4(持久化共享层):通用分布式存储,继续承载模型、数据集、Checkpoint 以及需永久沉淀的业务数据;
YRCache:作为中枢软件贯穿 G1 至 G3.5 各层,完成全局缓存的寻址、调度与生命周期编排。
回到长文档问答的场景:只要 A 节点生成的缓存已下沉至 G3.5 共享层且尚未失效,B 节点就能以远低于重算的代价直接拉取前缀状态,仅针对用户的新增追问进行计算。
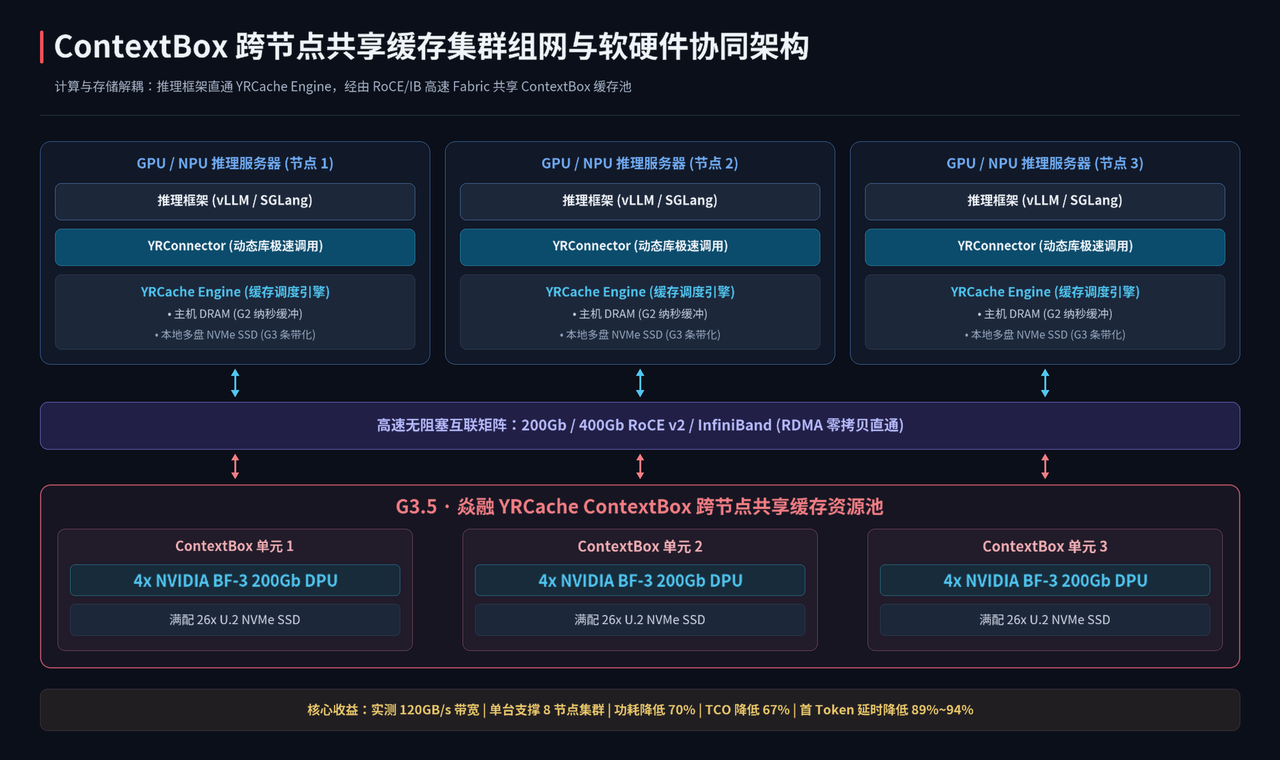
焱融所谓“全栈 AI 存储”在推理侧的意义,正是将这条跨节点的复用链路彻底接通。
三、以存换算,账要算在整套系统上
把计算状态存下来,并非天然比重新计算更划算。
将缓存移出显存虽为 GPU 腾出了空间,却引入了写入、换入、索引以及网络传输的新成本。缓存规模越大,命中几率越高,但元数据检索、排队竞争与存储开销也同步增加。
调度策略同样在深刻左右这笔账的结果:
1、计算向缓存靠拢:将请求调度至已有缓存的节点,省去了网络搬运,却可能因算力排队而牺牲响应时间;
2、缓存向计算靠拢:将缓存推送到空闲节点,摊薄了算力压力,却会瞬间挤占网络带宽。
因此,“以存换算”的成立条件非常苛刻:省下的重复计算算力,必须显著大于保存、寻址、传输与装载缓存的系统总代价。 极短且少重复的输入,重新计算更划算;唯有被频繁访问的长上下文前缀,才能积累出可观的复用红利。
焱融披露的一组企业测试,印证的正是这种长文本场景下的收益:
在 8 卡 NVIDIA H20-3e(单卡 141GB HBM)、运行 SGLang 与 GLM-5.1 的环境下,接入 YRCache 与 ContextBox 后,在 31K 至 129K 的长输入区间内,首 Token 时延降低了 89% 至 94%,Token 吞吐量提升了 3 至 6 倍。
对于长文档问答等强依赖首 Token 体验(TTFT)的场景,这一提升十分显著。但这代表的是特定长上下文负载下的理论上限,不可随意泛化——真实业务中的收益空间,仍高度取决于实际的缓存命中率、并发特征、文本长度,以及基准系统原有的优化程度。
更重要的是,技术性能无法直接等同于商业收益。
焱融曾给出一项测算:在 64K 输入、50% 命中率与 GPU 持续满载的理想假设下,按市面 Token 定价折算,单台 8 卡服务器的月度“等效产值”可从 5.2 万元跃升至 11.9 万元。
但必须厘清的是,“等效产值”是对算力产能的理论换算,既非真实营收,更非净利润。其商业兑现能力,取决于业务端是否有足够饱满的付费流量,以及是否能覆盖新增专用硬件、网络改造成本、能源消耗与运维投入。
对推理服务架构师而言,真正具参考价值的评估公式,应当是在既定服务等级(SLA)约束下,整套系统的单位有效 Token 综合成本(TCO)——既要看吞吐量和长尾时延表现,也要严密测算背后的软硬件、网络与电力总投入。
这笔账还应算上架构解耦带来的弹性红利。当计算与缓存解耦后,沉淀在 G3.5 共享层的缓存不再与单机生命周期绑定。计算节点缩容或故障退出,缓存依然可用;新接入的兼容节点可直接挂载复用,免去了漫长的冷启动预热。
随着 Agent 架构与多轮复杂交互的普及,固定的系统指令、检索文档与历史对话会在多步任务中被反复调用,重复计算的浪费愈发突出;与此同时,动态前缀匹配、多租户安全隔离与缓存失效策略,也将成为新的工程难点。
可以说,评价 AI 存储的标尺,正在从单纯的带宽与 IOPS,向前推进一步:它能否与上层推理框架、调度系统深度协同,让符合条件的计算状态,在正确的时间、正确的位置被高效复用一次。
从这把新标尺来看,焱融的“全栈”路径给出了清晰的工程定位:高性能分布式存储负责让海量数据高效进入计算,YRCache 负责单机内计算状态的精细编排,ContextBox 则将这种复用能力推向跨节点集群。三者结合,构成了存储向推理内核渗透的一次系统性探索。
对底层基础设施而言,真正的代际跨越,正是让“不必重算”从模型单机的微观技巧,彻底蜕变为整个分布式推理集群的一项通用底座能力。


