Skill 越来越多,然后呢?
如果你正在构建或运行 AI Agent,大概率遇到过这样的场景:
一次任务需要调用好几个 Skill,不同任务需要的 Skill 组合完全不同,写代码不需要搜索引擎,做数据分析不需要 PDF 处理,而现在的做法只能把它们全部挂上,让 Agent 每一轮都在几十份说明书里翻一遍,才能挑出真正要用的那两三个;
Skill 会更新、会出错、会被篡改,但你很难知道 Agent 当前用的到底是哪个版本;
Agent 的上下文窗口是有限的。把所有 Skill 一股脑塞进去,不仅浪费 Token,还会让 Agent 挑花眼,选错工具。
说到底,Skill 缺一个治理层。
Agent 需要一个稳定的入口来访问 Skill,但这个入口不能只是一个目录挂载。它得能回答三个问题:当前任务该暴露哪些 Skill?这个 Skill 可不可信?出了问题能不能兜底?
这就是 SkillFS 要做的事。
SkillFS 是什么?
SkillFS 是 ANOLISA 的运行时组件之一。ANOLISA 做的是 Agent 的运行底座,覆盖 Token 优化、运行时增强、Agent 可观测与安全四个方向,SkillFS 负责其中的 Skill 治理这一层:Skill 怎么被看见、怎么被信任、出问题怎么兜底。
SkillFS 是一个基于 FUSE 的虚拟文件系统,它把物理 Skill 目录转换成 /skills/
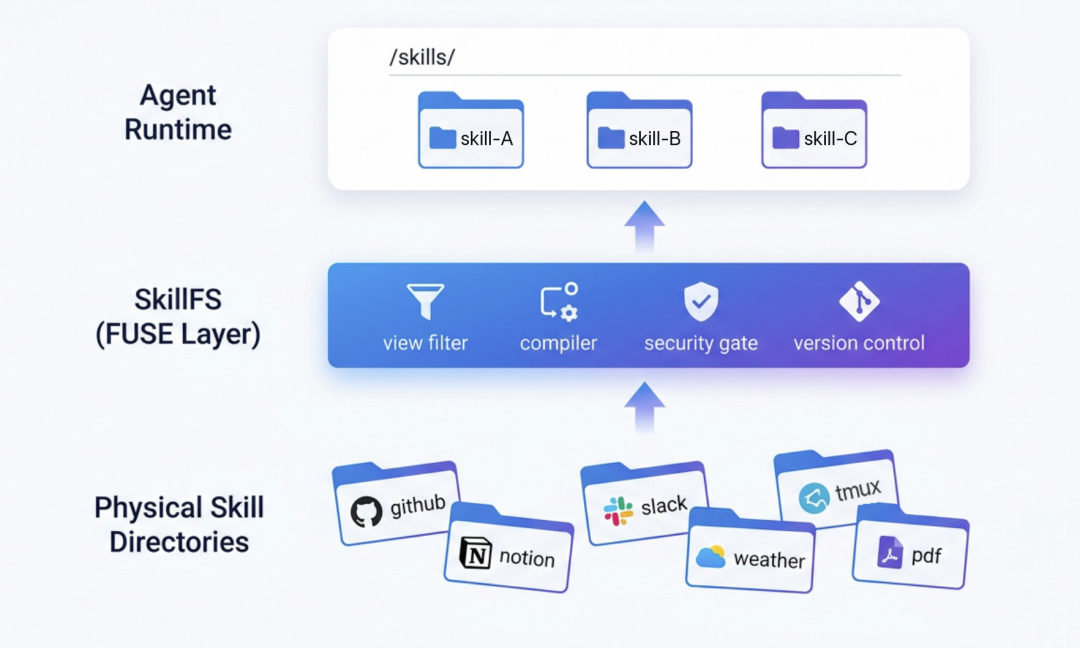
核心体验
视图分类:Agent 不必在所有 Skill 里做选择题
SkillFS 不是把目录换个路径挂出来就完事了,它要做的是把 Skill 集合裁剪到只剩当前任务需要的那几个。
具体来说,Skill 的可见性被分成了几个层次:
默认运行视图(/skills/
):Agent 日常使用的稳定入口,只暴露当前视图配置中的 Skill。这是 Agent 唯一需要感知的路径。 发现视图(/skills/skill-discover):展示可用但不默认加载的 Skill,Agent 按需进入探索。
安装候选入口(/.skillfs-inbox/
):新 Skill 或修复版本的写入通道,未通过决策前不会进入运行视图。 生命周期保留(.staging / .certified / .quarantine / .archive):为后续状态机预留的命名空间,普通视图不可见。
视图由 skillfs-views.toml 配置驱动。按类别组织 Skill(代码、搜索、媒体、写作……),通过配置决定当前任务暴露哪一组。Agent 的 readdir 只会看到当前视图中的 Skill,其他 Skill 安静地待在 discover 视图里。
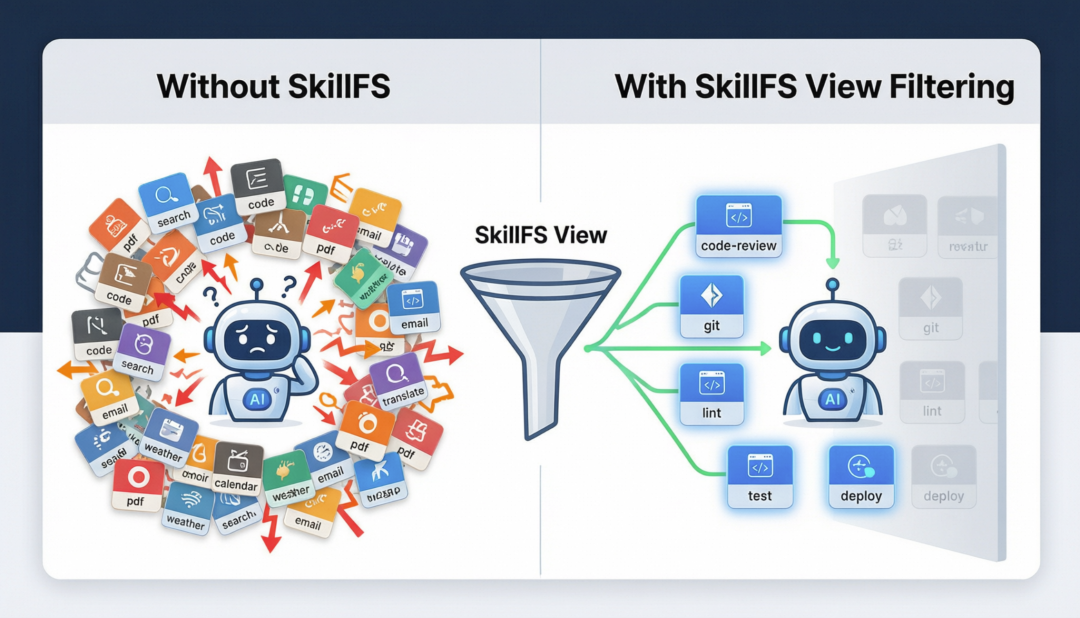
为什么这很重要?
无关 Skill 少了 = Token 省了 + 选错工具的概率低了。
当你的 Agent 面对几十个 Skill 但当前任务只需要 5 个时,视图裁剪让 Agent 不必在所有描述中检索和误选。这不是锦上添花,而是 Agent 在 Skill 数量上规模之后的刚需。
实测数据
我们基于 38 个 Skill(分为 content、analysis、devops、agent、knowledge 五大类)设计了 27 个测试场景,覆盖单分类执行、多 Skill 协同、跨视图自主切换三种模式,每个场景跑 4 轮取平均值:
多数模型上,视图裁剪带来了 7%~21% 的 Token 节省,kimi-2.5 上效果最明显,省了超过两成。这个收益跟模型本身的工具选择策略有关,Skill 检索能力越强的模型获益越大。
费用计算公式:cost_tokens = (prompt_tokens - cached_tokens) × 1 + cached_tokens × 0.2
你装进来的 Skill,凭什么信它?
视图分类解决了“看到什么”,但还有一串更棘手的问题:
一个 Skill 的
SKILL.md被篡改了怎么办?新装的 Skill 还没扫描完就被 Agent 调用了怎么办?
之前可信的 Skill 更新后出了风险,能不能自动回退?
安全动作能不能被审计和解释?
这些问题靠扫描算法解决不了,得在文件系统层做。
安全增强:从“能跑”到“能信”
SkillFS 在安全上提供了一套标准化的扩展接口:你可以自由替换扫描引擎、风险模型或签名方案,只要最终产出的决策符合 SkillFS 定义的协议格式,SkillFS 就在文件系统层忠实执行。
基线版本之后,我们做了一轮安全能力的集中增强,目前已全部开源。
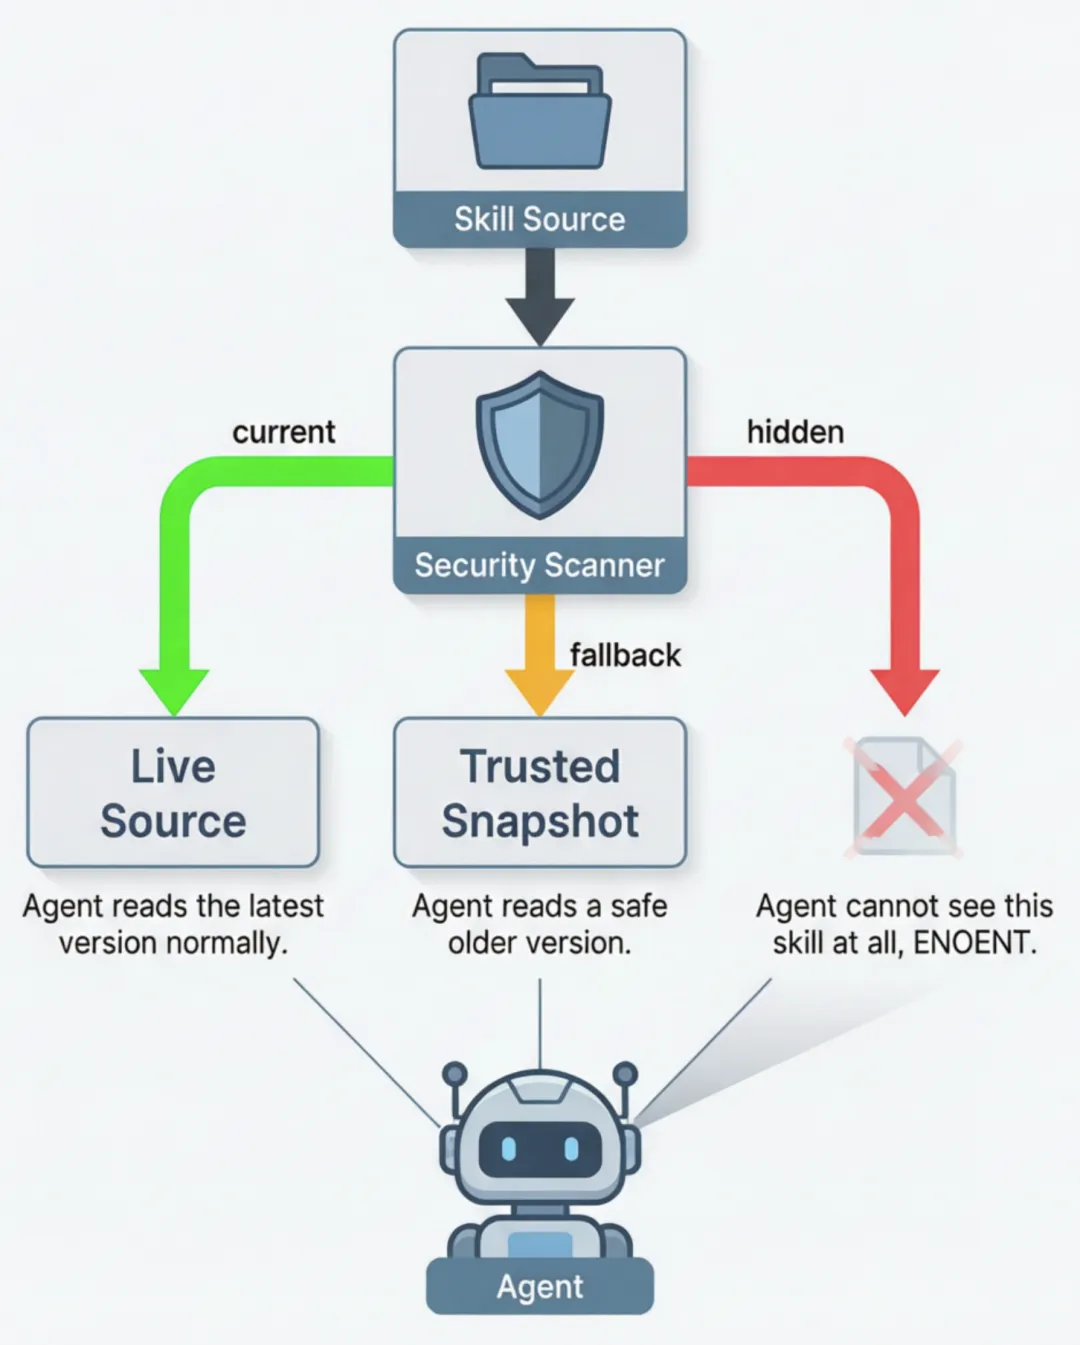
三种状态决策执行
上层的安全策略复杂多变,但到 SkillFS 这里只有决策、行为、典型场景三种结果,接口稳定,两边各自迭代。
Active Mapping 与热刷新
三种状态决策落地靠的是 Active Mapping,一张运行时映射表,决定每个路径背后指向哪里。SkillFS 通过 Source Drift 观察检测源目录变化,通过 External Decision Protocol(scan → resolve 流水线)消费外部安全决策,支持不停服热加载 activation 状态。安全侧随时可以更新决策,SkillFS 即时生效。
句柄级版本固定
还有一个并发问题值得说一下:Agent 打开文件后,如果后台正好切换了版本,后续 read 该读哪个版本?做法是 open 时把当前目标快照到文件句柄,后续所有读操作始终从固定目标读取。一次打开,内容始终自洽。
安全元数据保护与安装隔离
.skill-meta/ 目录存放 activation 状态、扫描结果等安全元数据,普通用户写操作一律返回 EACCES,只有认证的 Trusted Writer 才能写入(含 PID + starttime 防重用攻击)。同时,/.skillfs-inbox/ 提供了安装候选的隔离通道,新 Skill 先进 inbox,扫描决策通过后才进入运行视图。
审计与可观察性
安全动作不能是黑盒。JSONL 审计日志、Source Drift 事件、Activation 状态变更记录、Reconcile 可观察性,确保"这个 Skill 为什么不见了"随时可以追溯和解释。
POSIX 兼容:让安全真正“用得上”
如果 SkillFS 连 vim 都跑不起来,安全能力做得再好也白搭。
用户会在安全能力发挥作用之前,就因为编辑器报错、安装脚本失败、构建工具异常而绕过 SkillFS。所以我们花了大量精力在 POSIX 兼容性上:
完整的 open / read / write / create / mkdir / rename / unlink 主路径
chmod / chown / utimens / truncate 等元数据操作
受控的 symlink(仅 relative same-skill)和 hardlink(仅 same-skill regular file)
user.* xattr passthrough
PATH_MAX fallback 和 open-after-unlink 支持
通过 pjdfstest 外部 POSIX harness 做持续回归验证
道理很简单:用户得先愿意走这条路,安全治理才有施加的对象。
写在最后
SkillFS 要回答的问题是:
当 AI Agent 开始大规模使用外部 Skill 时,谁来治理这些 Skill?
做法是加一个文件系统治理层,把 Skill 的物理存储和 Agent 的运行视图拆开,让视图分类、安全策略、版本回退、审计这些事都卡在 Agent 访问 Skill 的必经之路上。
视图分类、POSIX 兼容、安全骨架,以及三态决策、activation、热加载等安全能力增强,目前均已开源。SkillFS 可以单独装、单独跑,不需要先引入 ANOLISA 的其他组件。它是一个独立的 Rust 工程,cargo build --release 之后用 skillfs mount
欢迎 Star、Fork、提 Issue,也欢迎一起聊聊 Agent Skill 治理这件事怎么做。


