10 月 29 日,在腾讯全球数字生态大会上,腾讯正式发布天籁语音大模型 Tenlai,包括天籁语音理解大模型 Tenlai-ASR v1.0、天籁语音生成大模型 Tenlai-TTS v1.0、天籁同声传译大模型 Tenlai-LiveTranslate v1.0。
三大模型分别面向语音理解、语音生成和实时跨语言交流,并已在腾讯会议、元宝、搜狗输入法、企业微信、ima、QQ 浏览器、腾讯地图、QQ 音乐等多款腾讯 AI 产品上应用,累计服务数亿用户。目前,天籁语音大模型 Tenlai 已正式通过腾讯云对外开放,为企业与开发者提供领先语音技术支撑。
语音理解:能力全面升级,让 Agent 真正读懂每一场会
天籁语音理解大模型 Tenlai-ASR v1.0,能够精准实现多讲话人区分,多模态上下文理解能力、实时音频流和超长音视频转录识别能力大幅提升,进一步推动沟通交流上下文被完整、准确地沉淀,为大模型、Agent 快速理解和调用。
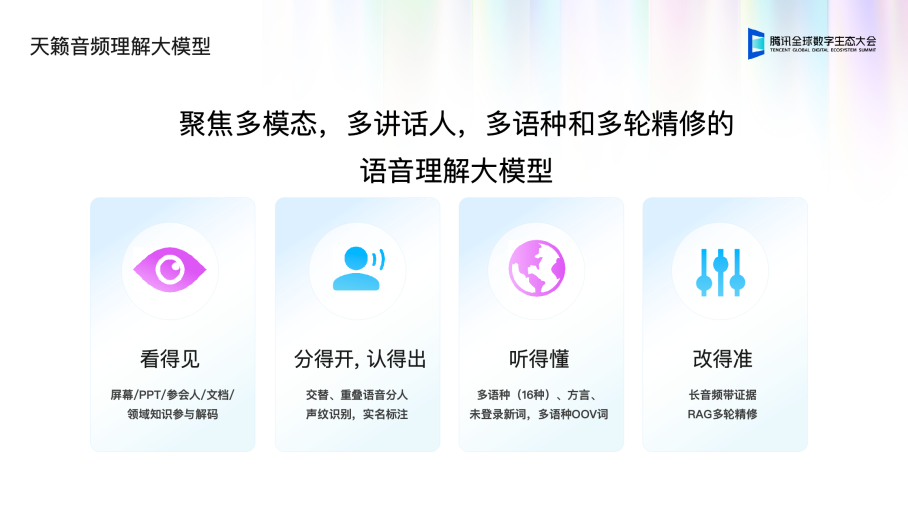
相比独白、语音指令等发言人单一、发言时间较短的场景,会议 ASR 面临更密集的技术挑战:多人讨论时的重叠发言与插话,交流中出现的相近音色、多个人名、专业术语、缩写等,以及不同的拾音距离等。因此,会议语音理解不仅要提高单句转写准确率,还要保持内容、说话人与上下文在整场交流中的一致性。
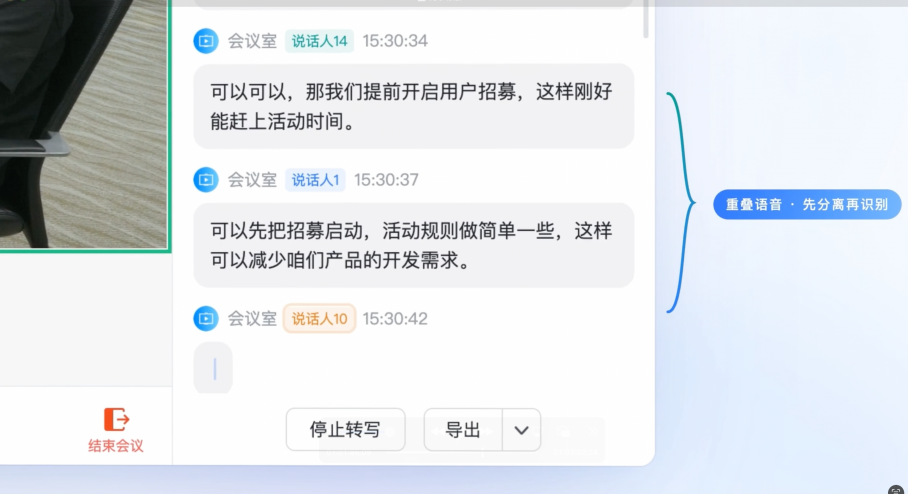
在区分多发言人方面,Tenlai-ASR v1.0 通过特征匹配,将同一说话人的音频精准分组;针对重叠发言,通过时频域变换分离并还原交叠语音,提升区分效果。在相关公开测试集上,同时评价内容识别与说话人归属的 CpWER 较行业基准降低 30%;说话人日志错误率 DER 由行业主流方案的 24%降至 10%以下。声纹识别进一步确认具体身份:企业版用户朗读文本录入并授权声纹后,系统在区分发言人的基础上,通过声纹匹配具体成员,准确率达 97%,支持一端录入、多端识别。
多模态上下文理解是 Tenlai-ASR v1.0 的重要能力。在获得用户授权后,模型可识别会议共享屏幕中的文字,提取与当前讨论相关的人名、产品名称和项目代号,并结合会议主题、对话历史、领域词库及用户自定义热词辅助转写。通过视觉信息、语音信号与文本上下文的交叉验证,模型能够提高专业词汇的识别准确率。内部评测显示,多模态视觉辅助能力促使专业词汇识别召回率相对提升约 30%—40%、WER 相对降低 10%—20%。
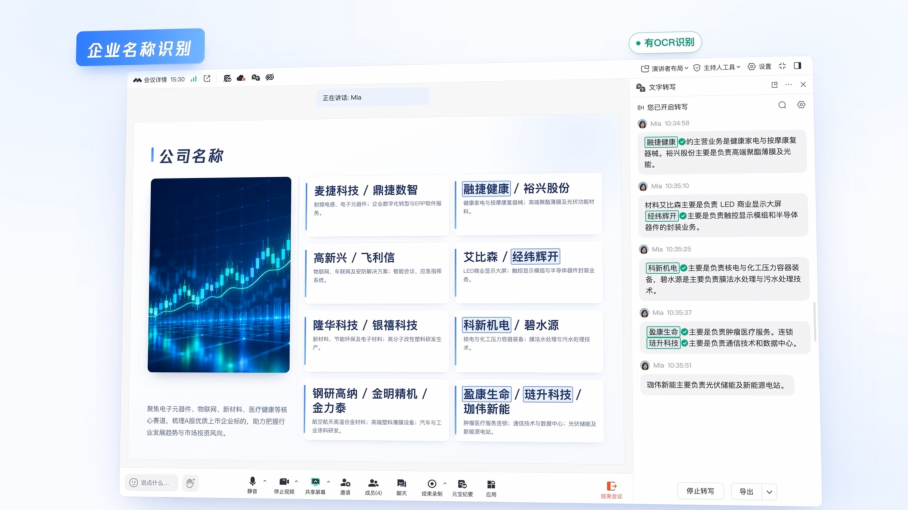
针对长音频内容,Tenlai-ASR v1.0 采用多轮精修机制:模型首先理解整场内容,再定位存在歧义的片段,结合原始音频与前后文进行复核,并据此更新转写结果。在三个会议长视频集合的内部评测中,多轮精修使多人讨论会议的词错误率(WER)由 2.42%降至 1.92%,相对下降约 20.7%;使专业知识密集型长视频 WER 由 2.33%降至 1.64%,相对下降约 29.6%。
语音生成:从读出文字到自然表达,让合成语音兼具表现力与辨识度
语音生成的难点,不只是把文字读对。同一句回应,用怎样的语气、在哪里停顿,都会影响听者的理解。Tenlai-TTS v1.0 重点提升自然语音生成与音色复刻能力:一方面提供可直接使用的高品质音色,使合成语音具备更自然的情绪、语气、停顿和节奏;另一方面可在获得授权后复刻目标说话人的音色,使生成的语音能容高度匹配说话人的个性音色表达。
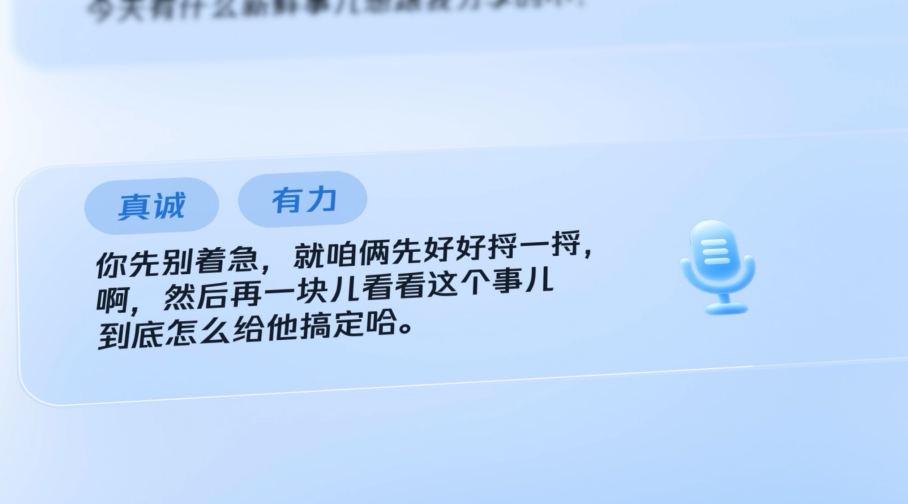
在生成自然语音上,模型能结合文本语义呈现情绪、语气与节奏,让安慰、鼓励、讲述等不同表达自然显现相应听感,使声音更接近日常交流;面向故事、古诗词等长文本,则通过韵律与重音变化呈现内容层次。模型还支持方言、中英混读以及公式、化学式等复杂文本朗读,为 Chatbot、客服、教育和有声内容提供更贴合场景的超自然语音表现能力。
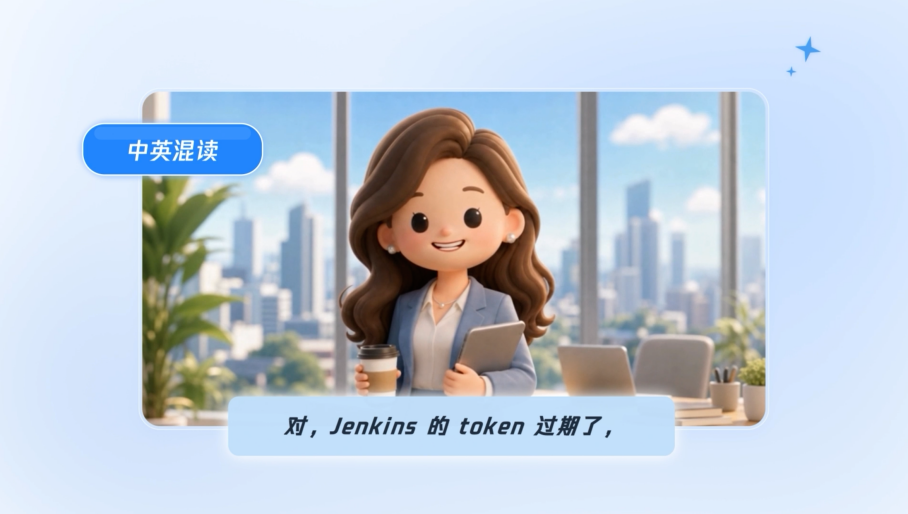
音色复刻则在获得声音使用授权的前提下,保留参考声音的音色特征,并支持以同一音色进行中文、英文等跨语言输出,让个性化声音不只复述已有录音,也能表达新的内容。这些能力背后,天籁将语音表征学习、内容生成与声音还原纳入端到端联合优化,使发音准确性、情绪表现与音色还原共同参与训练,而非仅依靠各环节分别优化后再拼接。
同声传译:边听边译、保留音色,让跨语言交流更流畅
天籁同声传译大模型 Tenlai-LiveTranslate v1.0 面向实时跨语言交流,支持中英、中日实时互译。模型采用端到端架构,在持续接收语音的同时生成译文语音,核心能力包括低时延处理和零样本音色复刻,旨在减少跨语言交流中的等待,并保留说话人的声音特征。
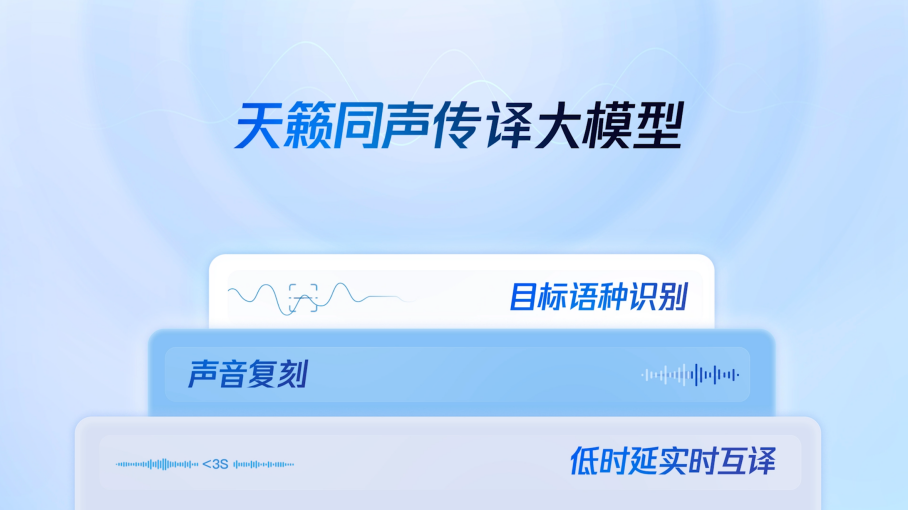
跨语言讨论中,等待时间与翻译质量都将影响沟通体验。传统语音翻译通常需要依次完成语音识别、文本翻译和语音合成。而 Tenlai-LiveTranslate v1.0 将源语理解、语义翻译和译文语音生成置于同一模型中协同完成,边听边译,并根据已接收的语义信息判断译文语音的输出时机,从而减少多阶段处理带来的信息损失和等待时间。基于 RealSI 公开评测集,在腾讯会议完整线上链路的内部测试中,模型中译英、英译中的首字时延缩短至 3-4 秒(时延受到网络影响)。
在音色复刻方面,模型无需针对目标说话人开展额外训练,即可根据发言语音生成保留其音色特征的译文语音,并在语速、停顿和重音等方面延续原说话人的表达特征。以中文发言、英文译音为例,听者接收到的译文仍保留原说话人的声音辨识度,使跨语言表达更接近由发言人本人完成。内部测试显示,译文语音与说话人原声的音色相似度(SpkSim)在中译英、英译中方向分别为 73.8 和 76.9。
让用户自然表达,让 Agent 更好理解和回应
此次三大模型发布,进一步将语音技术的价值从内容识别与生成,延伸至 AI 时代沟通质量与协作体验的提升。在人与人的交流中,准确的转写与发言归属有助于保留讨论中的观点和语境,使沟通成果能够被后续查阅和复用;低时延同传与音色保留,在降低跨语种交流障碍的同时延续个人表达特征,让跨语言协作更接近直接交流。
在人与 AI 的交互中,语音不仅是表达需求的入口,也是连接真实沟通与智能服务的重要纽带。语音理解将会议与对话沉淀为准确、完整的上下文,为 AI 理解需求、处理任务提供依据;语音生成则让 AI 以更符合日常表达习惯的方式回应用户。两者共同为人机交互从单次指令问答向基于上下文的持续协作拓展提供支撑,让技术更好地适应人的沟通方式。
通过与腾讯多款产品的 Co-design,天籁语音大模型已为会议协作、智能客服、内容生产及跨语言沟通等应用提供扎实的语音能力支持,并走向更广泛的行业场景,助力企业和开发者构建更自然、更贴近用户需求的智能语音交互体验。


