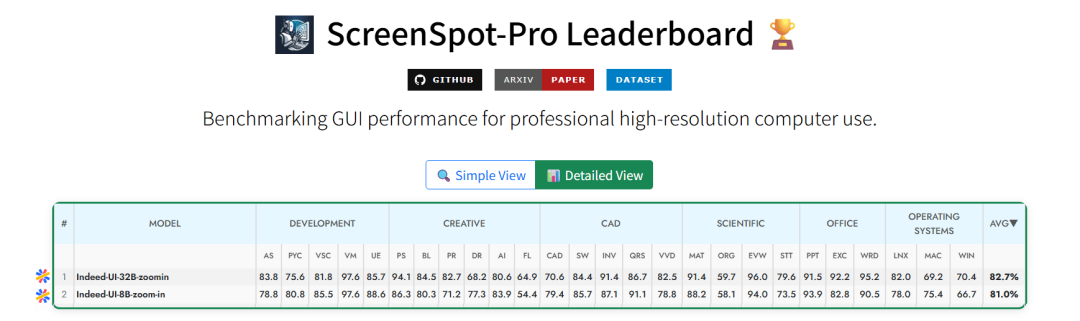
2026 年 9 月 9 日,全球公认最难考的 GUI 定位基准 ScreenSpot-Pro 榜单更新。实在智能 Indeed-UI-32B,以 82.7%的任务成功率,登顶全球第一。Indeed-UI-8B,以 81%的成绩紧随其后,位列全球第二,同参数量级模型第一。
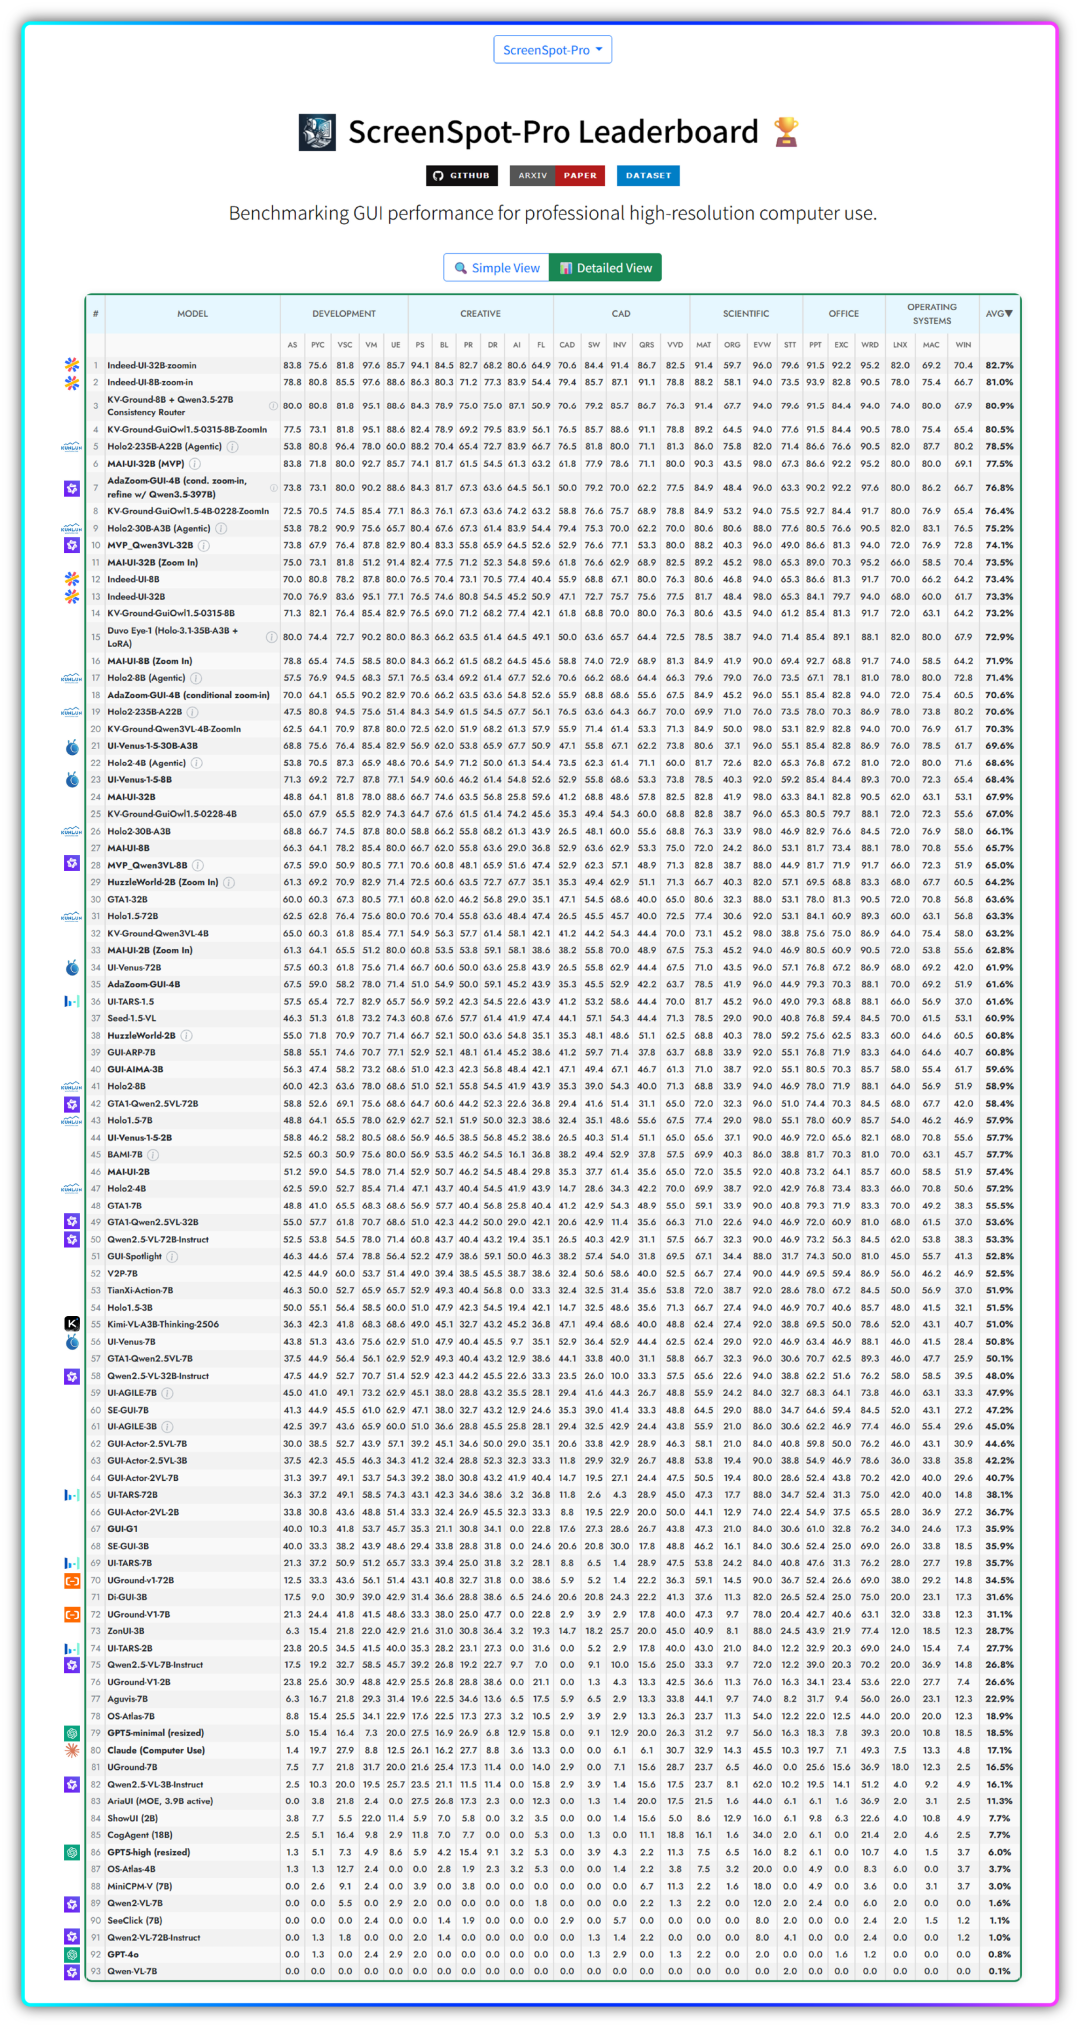
这不是一场内部比赛。GPT、Claude、Gemini、Qwen……全球最强的模型都在榜上。而我们,包揽了冠亚军。
但比起排名,我们更想认真跟你聊聊:这件事,对企业到底有什么用。
01 全球 GUI 定位的“金标准”
ScreenSpot-Pro 由新加坡国立大学、华东师范大学、香港浸会大学等高校联合研究团队提出,相关论文已被 ACM Multimedia 2025(CCF A 类会议)正式收录。
它考察的核心问题很简单:AI 能不能像人一样,在复杂的软件界面中,精准找到并定位到该点击的按钮、菜单或输入框?
打个比方,如果说“在 Photoshop 中批量导出多张设计稿”是一项完整任务,那 ScreenSpot-Pro 考的就是——模型能不能准确找到那个“导出图层”的按钮在哪里。
它的测试难度极高:
整屏、高分辨率的真实专业软件截图
覆盖 26 款真实专业应用,横跨开发、创意、CAD、科学、办公 5 大类
覆盖 Windows、macOS、Linux 三大操作系统
1581 条测试指令,全部由资深专业人士标注
2025 年基准发布时,全球最好的模型 GPT5、Claude、Qwen 也只有不到 20%任务成功率。一年后,我们把分数推到了 82.7%。
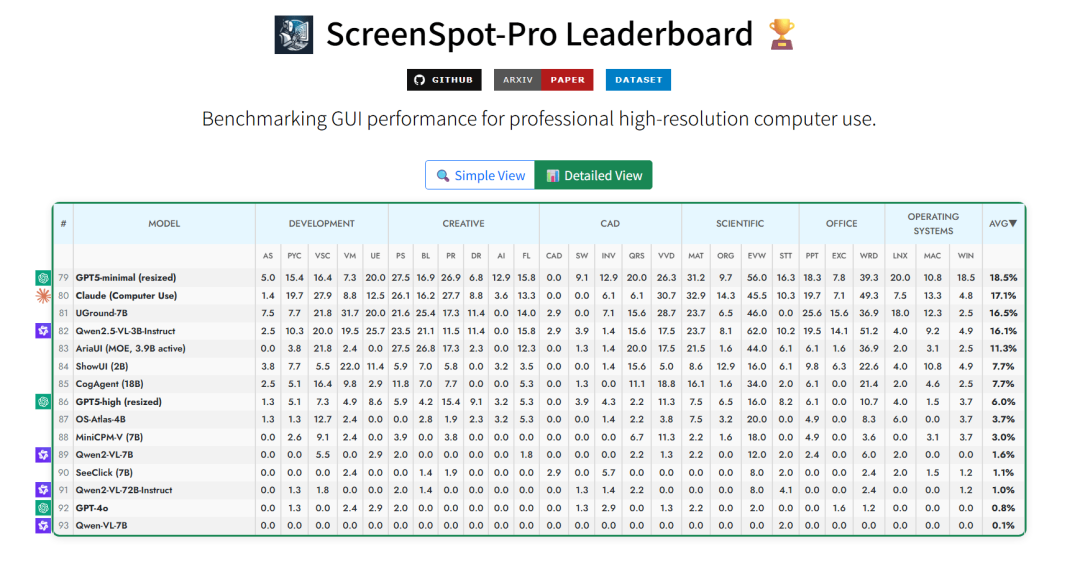
ScreenSpot-Pro 已入选 Hugging Face 官方基准测试体系,是全行业公认的 GUI Grounding 能力评估标准。在这个“魔鬼考场”上,我们包揽了冠亚军。
02 性能登顶,成本落地
根据 ScreenSpot-Pro 官方榜单:
32B 模型证明技术上限。Indeed-UI-32B 在办公软件测试中取得了 93%的平均成绩,几乎把企业办公软件测试“打穿”;在开发与编程类软件测试中更是达到 97.6%,接近满分。
8B 模型证明落地能力。Indeed-UI-8B 在同级参数量模型中位列第一,超越了包括更大参数规模在内的多个竞品。
这意味着实在智能不仅在绝对性能上登顶,更在效率维度上展现出领先优势——以更小参数实现高精度,为企业低成本部署提供了切实可行的路径。
如果说 32B 模型是证明我们技术深度的“F1 赛车”,那 Indeed-UI-8B 就是真正能让每家企业开回家的“家用轿车”。
我们来算一笔概念账:
过去要上一套能真正看懂复杂界面的 AI,动辄需要采购几十万的 GPU 集群才能跑得动大模型;而现在,在屏幕定位这一核心能力上,一台万元级的工作站就能达到可用的效果。部署门槛从“只有大厂玩得起”降到了“普通企业换台电脑就能试”。
更关键的是——数据不出企业内网。
与闭源 API 方案相比,8B 模型可以完全本地部署,从根源上解决数据安全与合规问题。财务数据、客户信息、生产排产表,全部留在你自己的服务器上,不用送给任何第三方。
而在 ScreenSpot-Pro 办公软件场景下,Indeed-UI-8B 的实测表现,也超过或者持平多个更大参数量的开源模型。别人需要顶配服务器才能跑的精度,我们用一台万元级工作站就能达到。
当小模型也能精准完成复杂界面定位时,AI 才真正具备大规模进入企业系统的条件——这正是实在智能大小模型同步领先的核心价值:不是让企业选“最强”还是“最省”,而是让“又强又省”成为现实。
03 看得准是入场券,能落地是真本事
ScreenSpot-Pro 登顶,证明的是 AI“看得准”的能力。但在企业真实场景中,“看得准”只是起点。
以制造业为例,一张客户订单从接单到最终回款,完整链路要连续穿越七八套甚至十几套业务系统:CRM 接收客户订单,OMS 完成订单拆解,APS 做生产排产,MES 落地车间执行,WMS 负责仓库出入库,SRM 对接供应商物料,ERP 完成成本核算,财务系统完成对账回款。
这其中有大量系统是 CS 架构的封闭软件——没有开放 API,没有标准化接口,甚至没有文档。
遇到这种场景,市面上绝大多数 AI Agent 只能望而却步。它们能聊天、能写文案,但面对一个 20 年前的 MES 系统界面,连第一个按钮都点不准。
为了打通这条“断头路”,实在智能花了 8 年磨了一套 Harness 工程底座。你不需要记住 ISSUT、CUA 这些拗口的名字,只需要记住它的三个“不要”:
1. 不要 API 接口。你的老 CS 软件没接口?没关系,AI 直接模拟鼠标键盘去操作,像人一样“硬控”界面。甭管是新的 BS 网页,还是几十年前的客户端,都能看懂、都能操作。
2. 不要人工盯着。遇到弹窗报错、页面改版、接口限流,它会自动重试、自主切换兜底路径,不会一卡就死给你看。超长复杂任务,AI 自己循环纠错,保障整条生产链路稳定跑通。
3. 不要数据出网。整套体系支持完全本地部署,屏幕语义理解、操作执行全部在内网完成,审计合规一次过。
这套体系,才是 82.7%榜单成绩背后的真正护城河——精准的 GUI 定位能力让 AI 点得准第一个按钮,Harness 工程底座则让 AI 从第一个按钮出发,一路跑通十几套系统的全链路闭环。
如果 ScreenSpot-Pro 考的是“看得准”,那 OSWorld 考的就是“做得完”。此前,实在智能已在 OSWorld 上取得全球第一。两个榜单,一个指向 GUI 定位,一个指向端到端任务执行,都是国际公认的权威评测。
接连登顶,说明实在智能在 AI 操作电脑的核心链路上,已经形成从感知到执行的体系化能力——不是单点冒尖,而是整条链路都跑通了。
04 登顶是起点,企业价值是终点
82.7%的全球第一,是实在智能在 GUI Grounding 这一核心能力上的阶段性成果。接下来,Indeed-UI 系列模型将持续迭代优化,在图标定位、复杂嵌套界面、跨分辨率场景等高难度方向上持续突破。
对企业来说,榜单分数的每一次提升,都意味着 AI 在真实业务中少犯一次错、少兜一次底、少一次人工干预。这些进步将直接转化为企业的三重价值:
更低的部署门槛。随着模型精度提升,8B 级别模型将能够覆盖更多复杂场景。万元级工作站跑通核心自动化,不再是概念,而是正在发生的现实。中小企业也能用得起、用得好。
更高的业务自主率。定位精度越高,AI 能自主完成的操作比例就越大。当模型从“大部分能做、关键步骤需人兜底”进化到“全链路自主跑通”,企业才能真正实现从“AI 辅助”到“AI 主导”的跨越。
更强的跨场景泛化。ScreenSpot-Pro 覆盖 26 款专业软件、三大操作系统。模型在这些高难度场景上的持续进步,意味着面对企业内部更加多样、更加老旧、更加非标的业务系统时,AI 同样能精准操作、稳定运行。
从 OSWorld 全球第一到 ScreenSpot-Pro 包揽冠亚军,我们的目标从来不是榜单排名。而是让每一家企业都能拥有一支“看得准、做得稳、跑得通”的数字员工军团,让 AI 自动化成为企业基础设施级的能力。
别人卷参数,我们卷落地。
参考文献:


