随着 HarmonyOS 7(API 26)的更新,系统在算法加速方面提供了新的能力。对于开发者而言,文件列表排序、数字信号处理等看似基础的功能,往往涉及复杂的底层算法实现与性能优化。如何在保证计算结果准确的同时,减少开发成本、提升运行效率,是实际应用开发中值得关注的问题。
FAST Kit(算法加速服务)为这些场景提供了新的实现方式。通过将部分底层算法封装为系统级能力,开发者可以直接调用相关接口,减少自行实现和优化算法的工作量。不过,这些能力在实际应用中表现如何?接入过程有哪些需要注意的地方?相比既有方案,又能带来多大变化?
带着这些问题,本文选取了两个具体场景进行实践:文件列表的自然语言排序,以及基于 FFT 的频谱分析。通过同一工程中的两个小型实验,分别验证 FAST Kit 的接入方式、运行效果与使用限制,并与既有方案进行对比。
本文全部代码与测试数据均来自同一可复现工程,运行环境为 DevEco Studio 26.0.0.851、HarmonyOS 26.0.0 Release SDK,以及 Mate 90 Pro 模拟器(HarmonyOS 7.0.0.107)。
实验总览
FAST Kit 是 HarmonyOS 7 的算法加速服务,将部分实现复杂、对性能敏感的底层算法封装为系统级能力。本文选取其中两项进行实验:
实验一 · 自然语言排序(
libfast_utils.so):只有 Native C 接口,必须写 NAPI 桥接;实验二 · FFT 数字信号处理(
libfast_dsp.so):同样 Native C 接口,4096 点实数 FFT。
两个实验共用一个 Demo 工程(Native C++ 模板),从 DevEco Studio 一键运行到模拟器:
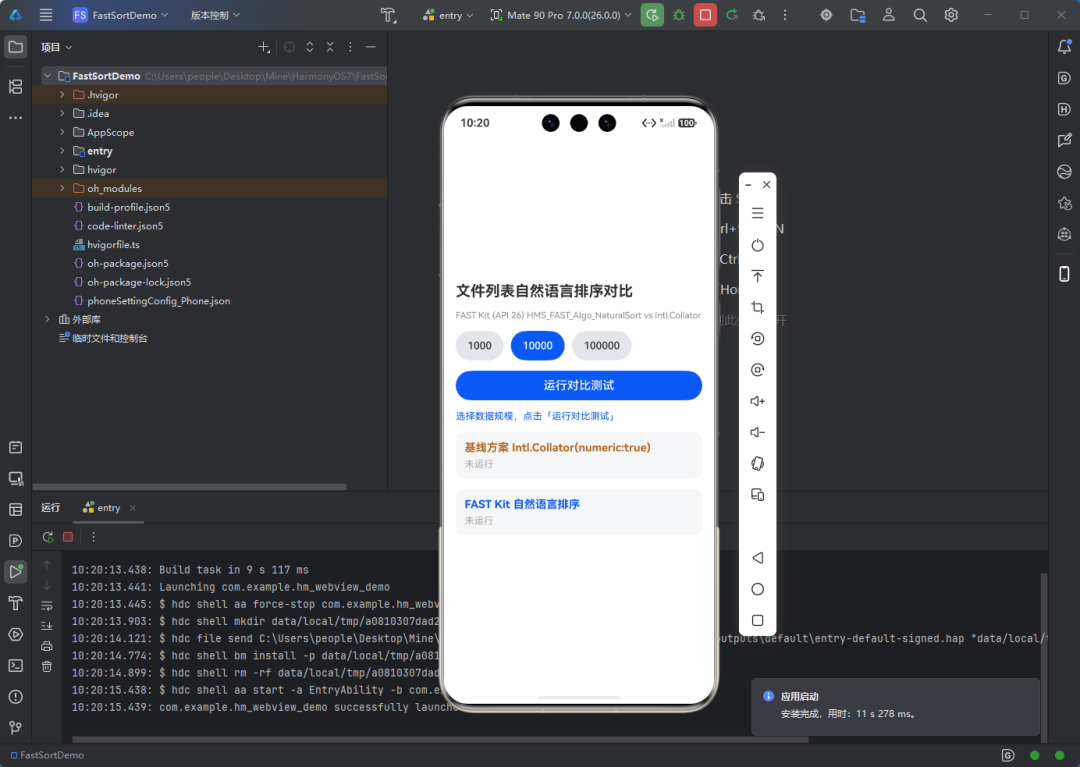
工程结构如下:Native 层封装 HMS_FAST_* 接口,ArkTS 层用 taskpool 调用并绘制 UI,两个实验各一个页面。
FastSortDemo/entry/src/main/├─ cpp/│ ├─ napi_init.cpp # naturalSort + fftSpectrum 两个桥接函数│ └─ CMakeLists.txt # 链接 libfast_utils.so + libfast_dsp.so(链接配置见 2.3)└─ ets/pages/ ├─ Index.ets # 实验一:排序基准对比 └─ FftPage.ets # 实验二:频谱分析 + Canvas 绘图实验一:文件列表自然语言排序
场景
文件管理器、通讯录等应用都需要处理一个问题:排序结果应符合用户的阅读习惯。file1, file2, file10 应按数值排成 1、2、10;"北京、成都、上海"应按拼音排。根据文中引用的性能口径,FAST Kit 的 HMS_FAST_Algo_NaturalSort 相比第三方国际化排序库,在热点列表场景下性能可提升 60%~70%。本实验进一步观察其实际表现。
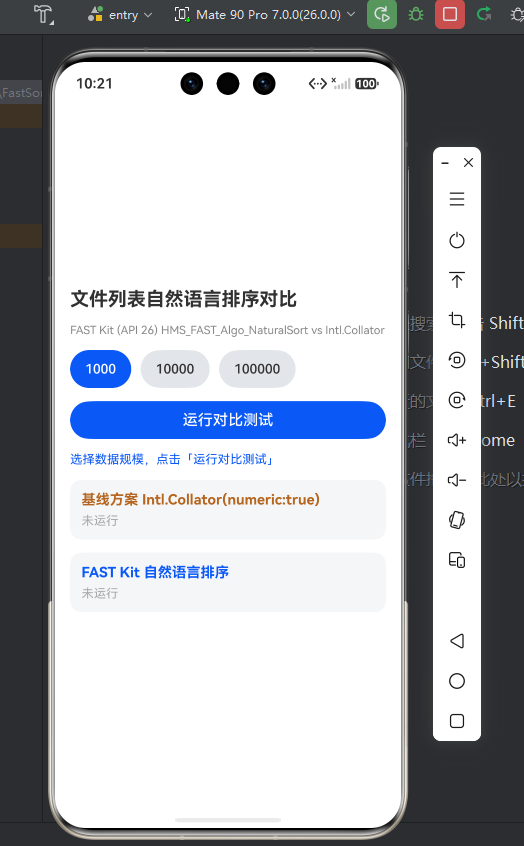
应用首页提供三档数据规模(1 千 / 1 万 / 10 万条),一键对比 FAST Kit 与基线方案 Intl.Collator:
适用条件
API 26 起步:接口标注
@since 26.0.0,SDK 与运行系统都有硬门槛;仅 Native 接口:
@kit.FASTKit的 ArkTS 侧只有调度优化和数理预测,排序必须走 C 接口 + NAPI 桥接;输入为 UTF-8 字符串数组:
HMS_FAST_SortData描述符的sizeOf必须等于sizeof(char*)。
接入过程:两个需要注意的问题
Native 桥接的基本流程是将 ArkTS string[] 转换为 char* 数组,调用接口后再转换回 ArkTS 数据:
HMS_FAST_SortData sortData;sortData.sizeOf = sizeof(char *);sortData.length = len;sortData.data = ptrs.data(); // UTF-8 字符串指针数组 FAST_ErrorCode code = HMS_FAST_Algo_NaturalSort(&sortData, /*ascend=*/1);// 成功后 ptrs 已按自然语言序原地重排实际接入时,有两个构建配置问题需要注意:
问题一:SDK 版本格式。 API 26 起 compatibleSdkVersion 必须写新点分格式 "26.0.0",沿用旧格式 "X.Y.Z(NN)" 直接报 00308018。hvigor 插件源码 version-regex.js 中可以看到对应的匹配规则:newDotSeparatedVersion = /^([2-9][0-9])\.[1-9]?[0-9]\.[1-9]?[0-9]$/。
问题二:HMS sysroot 链接。 libfast_utils.so 在 HMS sysroot 而非 OpenHarmony sysroot,且目录名是 GNU 三元组而非 ABI 名,直接使用 -lfast_utils 会出现无法找到库的问题:
# ABI → sysroot 三元组映射(arm64-v8a→aarch64-linux-ohos,x86_64→x86_64-linux-ohos)set(FAST_UTILS_SO ${HMOS_SDK_NATIVE}/sysroot/usr/lib/${SYSROOT_TRIPLET}/libfast_utils.so)target_link_libraries(entry PUBLIC ${FAST_UTILS_SO})运行效果
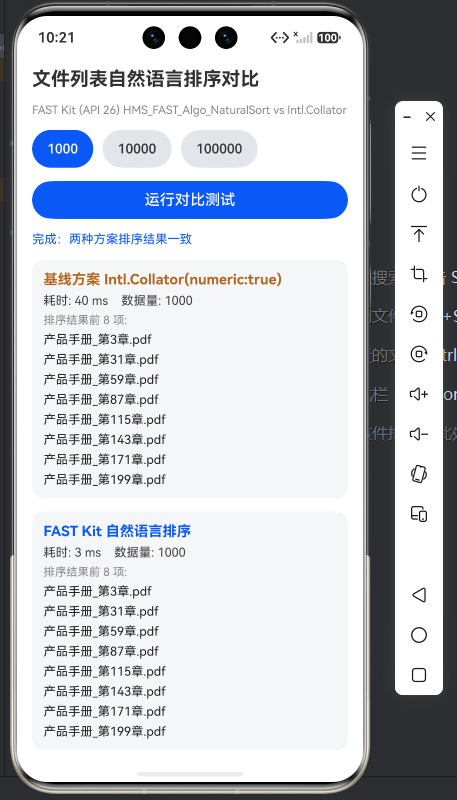
1000 条数据的结果页——两方案耗时、排序前 8 项、哈希校验同屏:
三档规模的实测汇总(DevEco 一键运行):
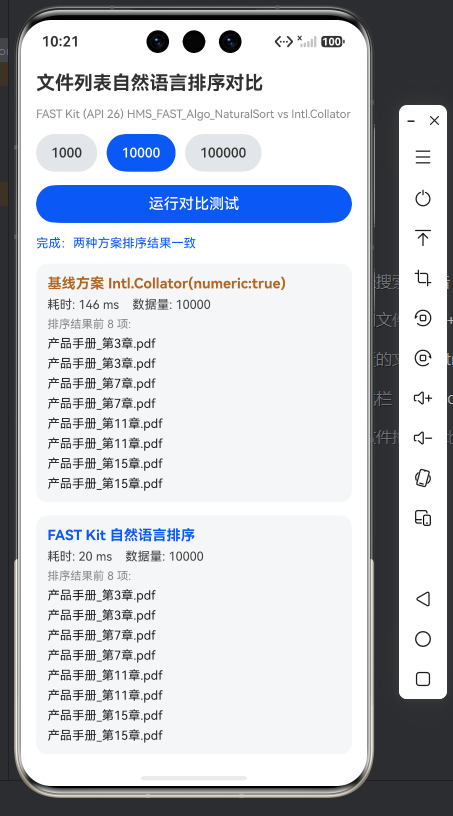
在本次测试中,1 万条数据的排序耗时从 146 ms 降至 20 ms;数据量增加至 10 万条时,两种方案的耗时差距进一步扩大:
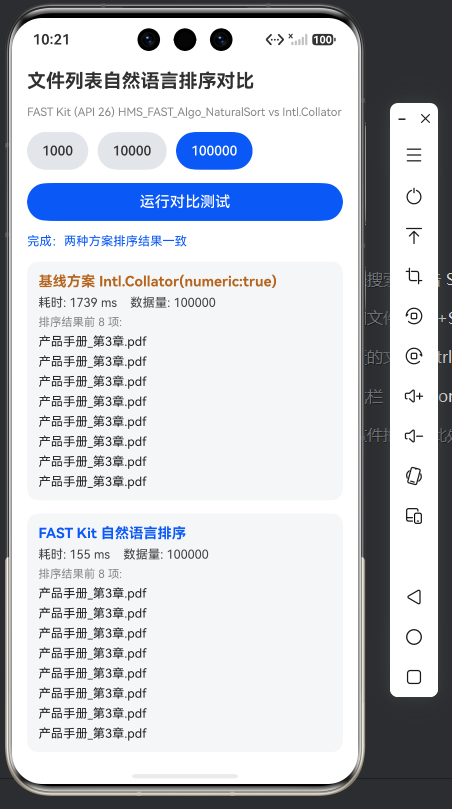
复现性:另一轮通过 hdc CLI 独立部署的运行测得 51/262/2381ms 对 4/30/203ms(加速比 12.75x/8.73x/11.73x),量级一致。所有轮次两方案排序结果哈希全部一致——性能对比建立在结果等价之上。
如何理解这组数据:本次实测加速比为 7.3~13.3 倍,但这一结果不能直接与前述 60%~70% 的性能提升数据比较。两者采用的基线方案不同:本实验使用 ArkTS 层的 Intl.Collator,还涉及不同实现路径的开销。数据也显示,性能收益需要结合绝对耗时和数据规模判断:1,000 条时两者相差 37 ms,而在万级及以上列表中,绝对耗时差距更明显。
实验二:FFT 频谱分析
场景与接入
频谱分析是音频处理和传感器数据分析中的常见环节。FAST Kit 的 DSP 功能域提供基于 ARM NEON 优化的 FFT(libfast_dsp.so),单精度支持最大 2¹⁶ 点。实验设计:生成三种模拟信号(双音+谐波 / 含噪复合信号 / 方波谐波簇),4096 点采样(fs=4096Hz,分辨率 1Hz/bin),执行 FFT 后用 Canvas 绘制时域波形与频谱图。
Native 侧桥接的核心代码如下:
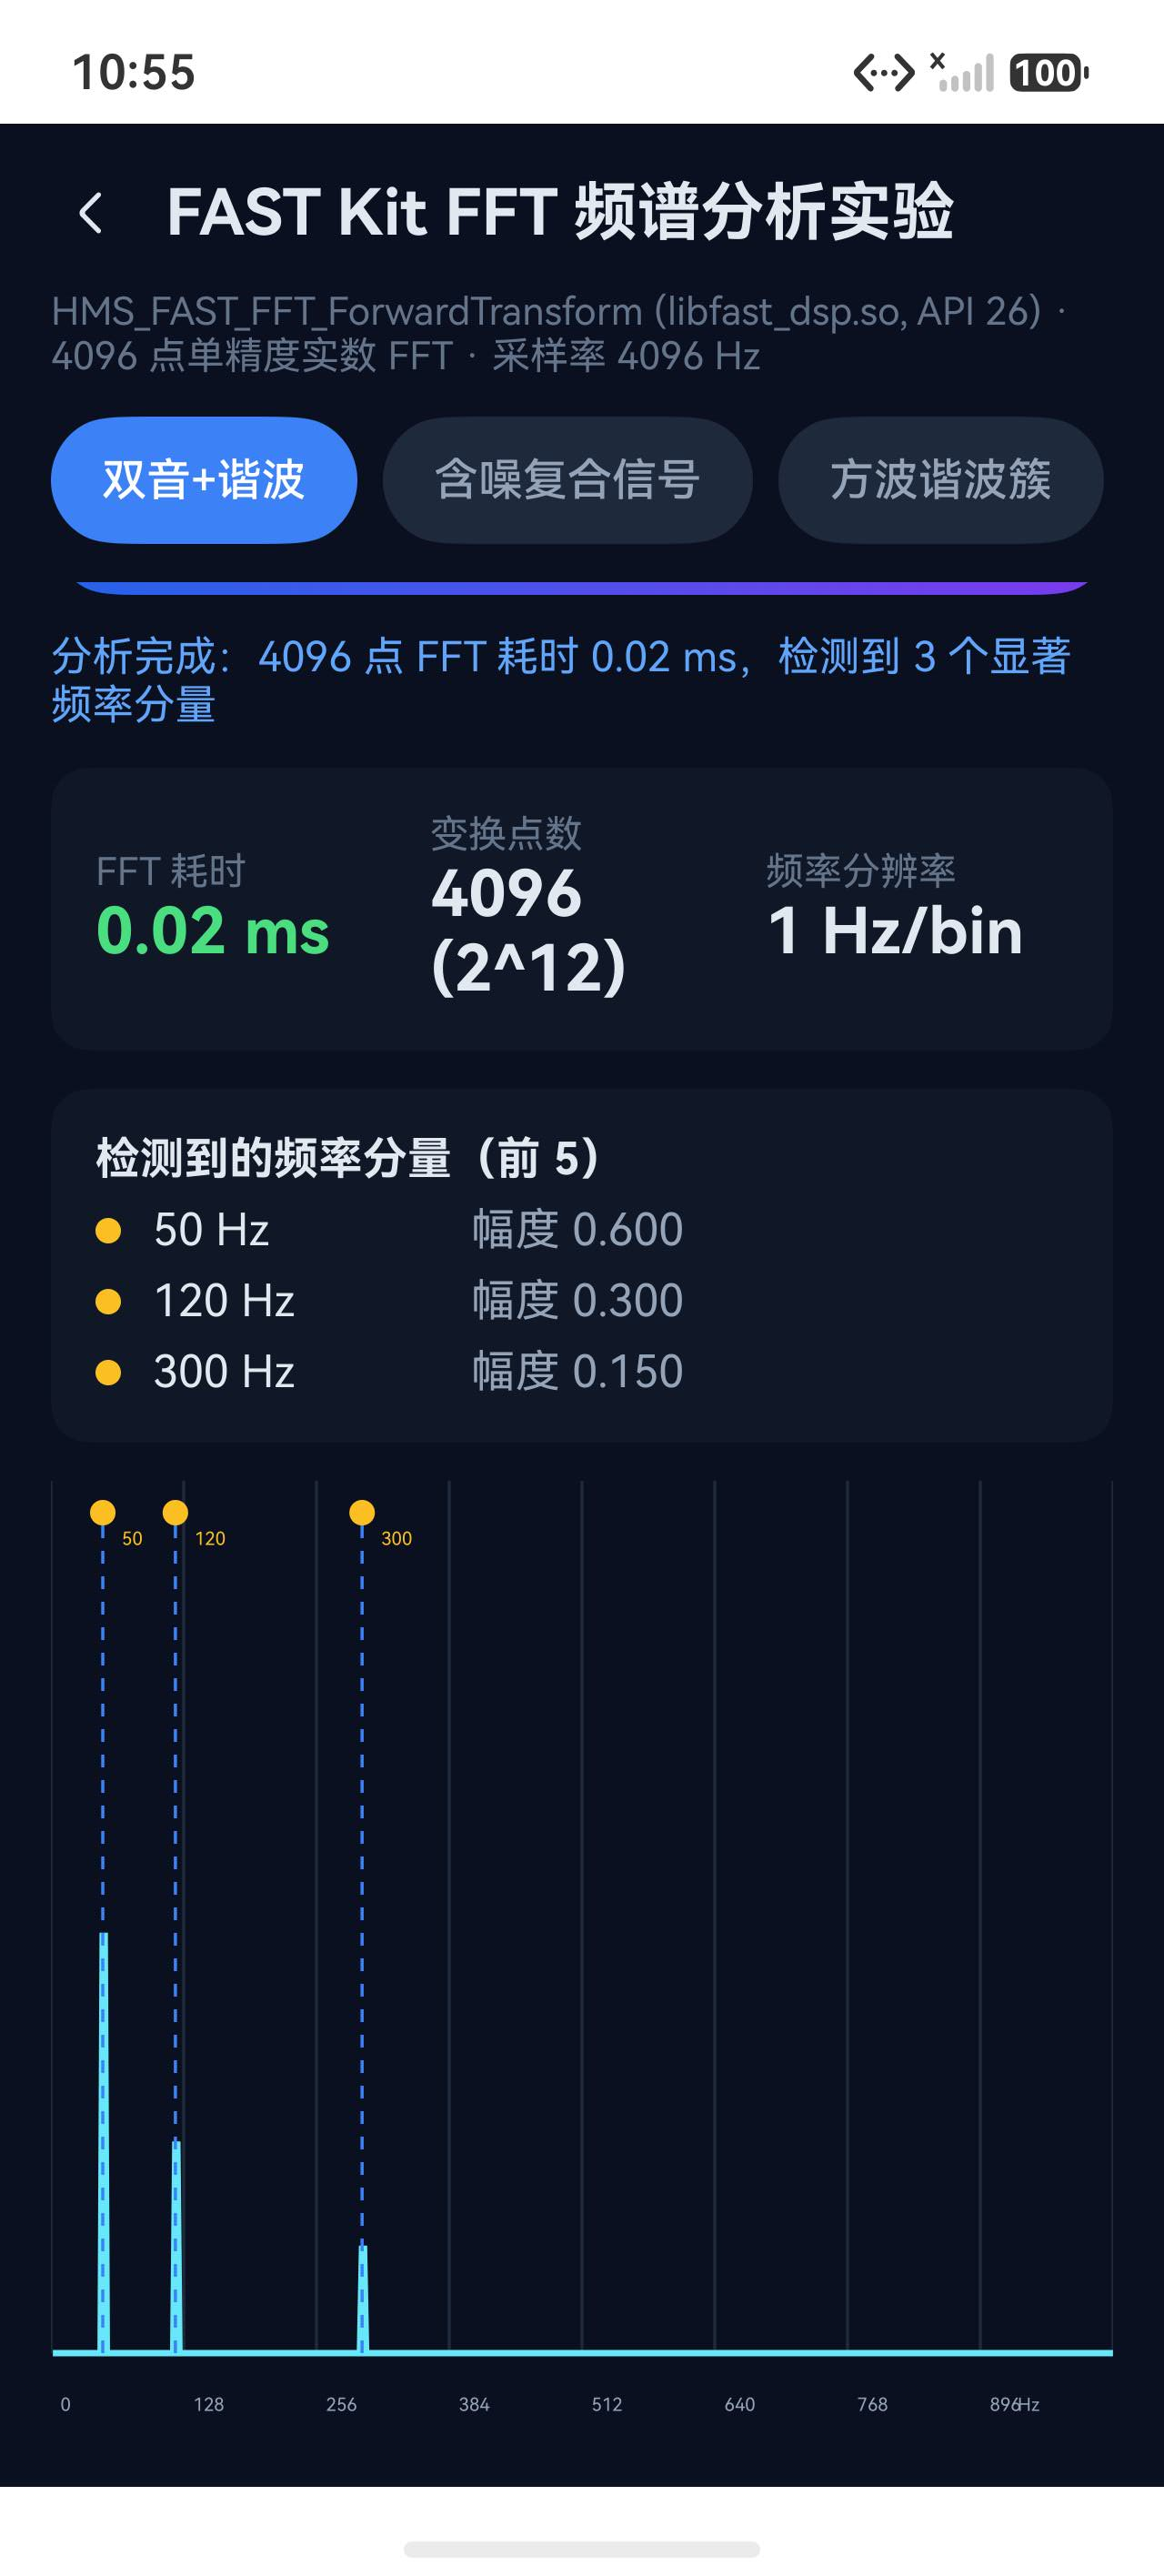
FAST_FFTConfig *config = nullptr;HMS_FAST_FFT_CreateConfig(&config, /*log2n=*/12); // 2^12 = 4096 点 auto t0 = std::chrono::steady_clock::now();HMS_FAST_FFT_ForwardTransform(config, len, in.data(), re.data(), im.data()); // 实数→复数频谱auto t1 = std::chrono::steady_clock::now(); // 单边幅度谱:mag = sqrt(re² + im²) × 2/N,输出 N/2+1 个 binArkTS 侧在 taskpool 中执行 FFT(避免阻塞 UI),返回幅度谱后用 Canvas 绘制渐变频谱柱并自动检测显著频率分量。点击「双音+谐波」,即可查看分析结果:
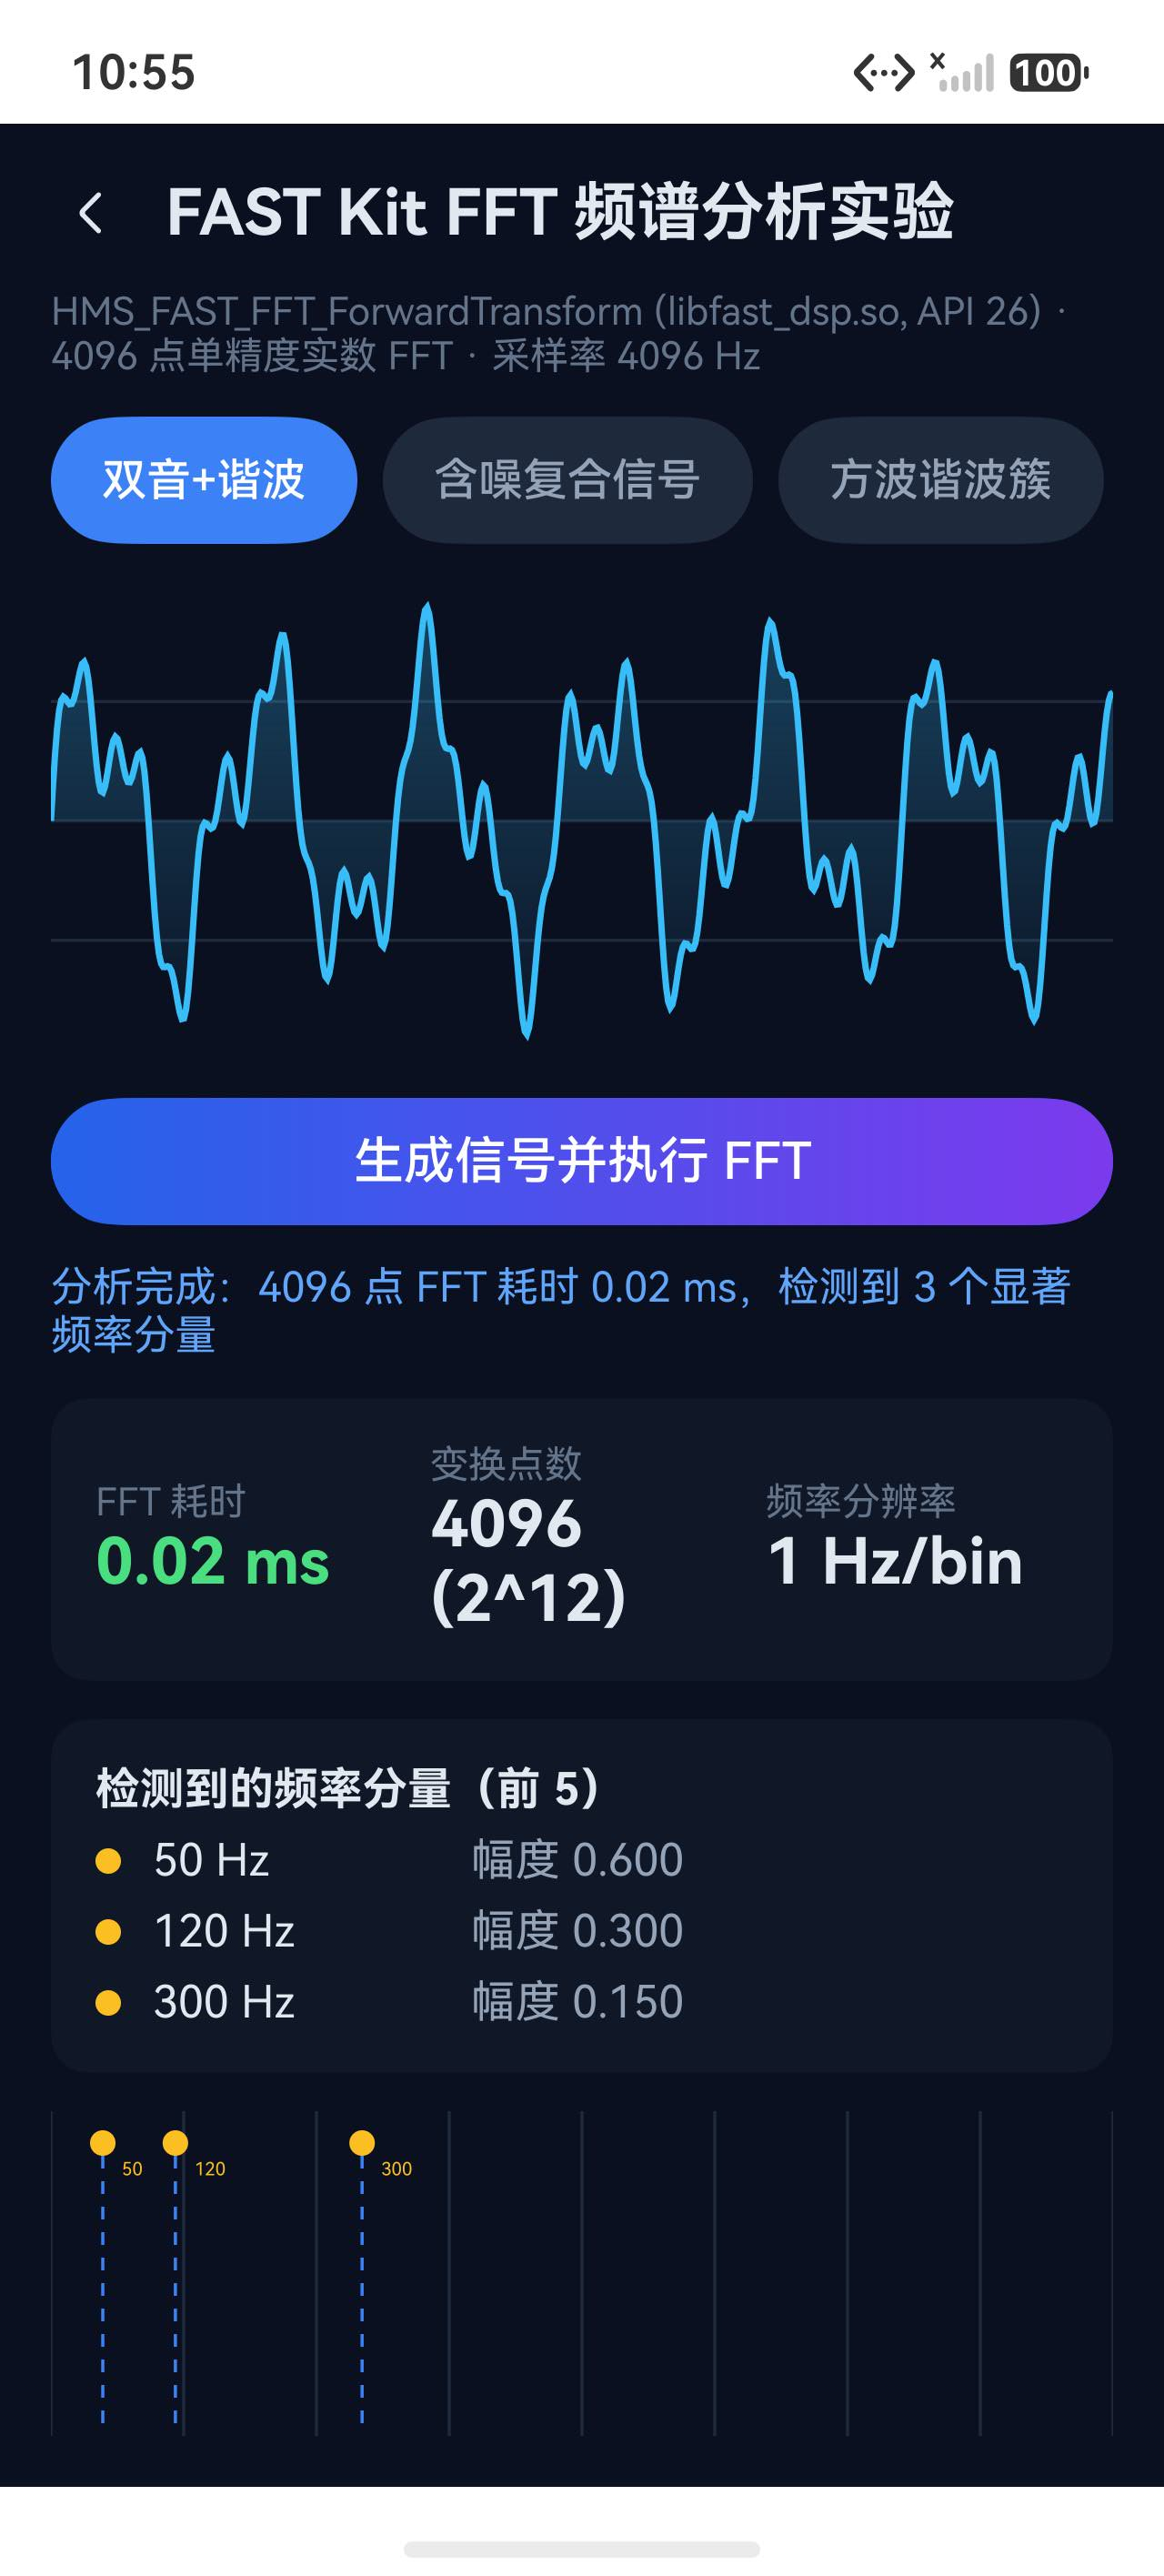
幅度校准结果与设定值一致:生成时三种正弦的振幅是 0.60 / 0.30 / 0.15,检测结果 0.600 / 0.300 / 0.150。在频谱区域,三根谱线的幅度比为 2:1:0.5:
频谱绘制中的问题:为什么不加窗会“看不到”谱线
第一版频谱图曾出现只有网格线、没有谱柱的情况:峰值检测已经识别出 50/120/300 Hz,但柱状图仍然为空。原因在于:信号频率恰好落在整数 bin 上(50Hz × 1s 采样 = 恰好 50 个整周期),矩形窗的旁瓣在所有其他整数 bin 上严格为零。而柱状图按步长采样,恰好全部采在零点上——谱能量浓缩在一个 bin 里,采样点全落在"谷底"。
针对这一绘制问题,可以在 FFT 前加 Hann 窗。主瓣展宽,让峰值附近的谱线更容易被当前绘图采样方式捕捉到,谱线变成可见的峰,代价是幅度需补偿相干增益(×2):
@Concurrentfunction fftTask(signal: number[]): FftResult { const n: number = signal.length; for (let i = 0; i < n; i++) { signal[i] = signal[i] * 0.5 * (1 - Math.cos(2 * Math.PI * i / (n - 1))); } return fftSpectrum(signal);}这也提醒我们:当 FFT 的可视化结果与峰值检测不一致时,应先检查窗函数与绘图采样方式,再排查算法库本身。
更多信号:噪声底与谐波梳
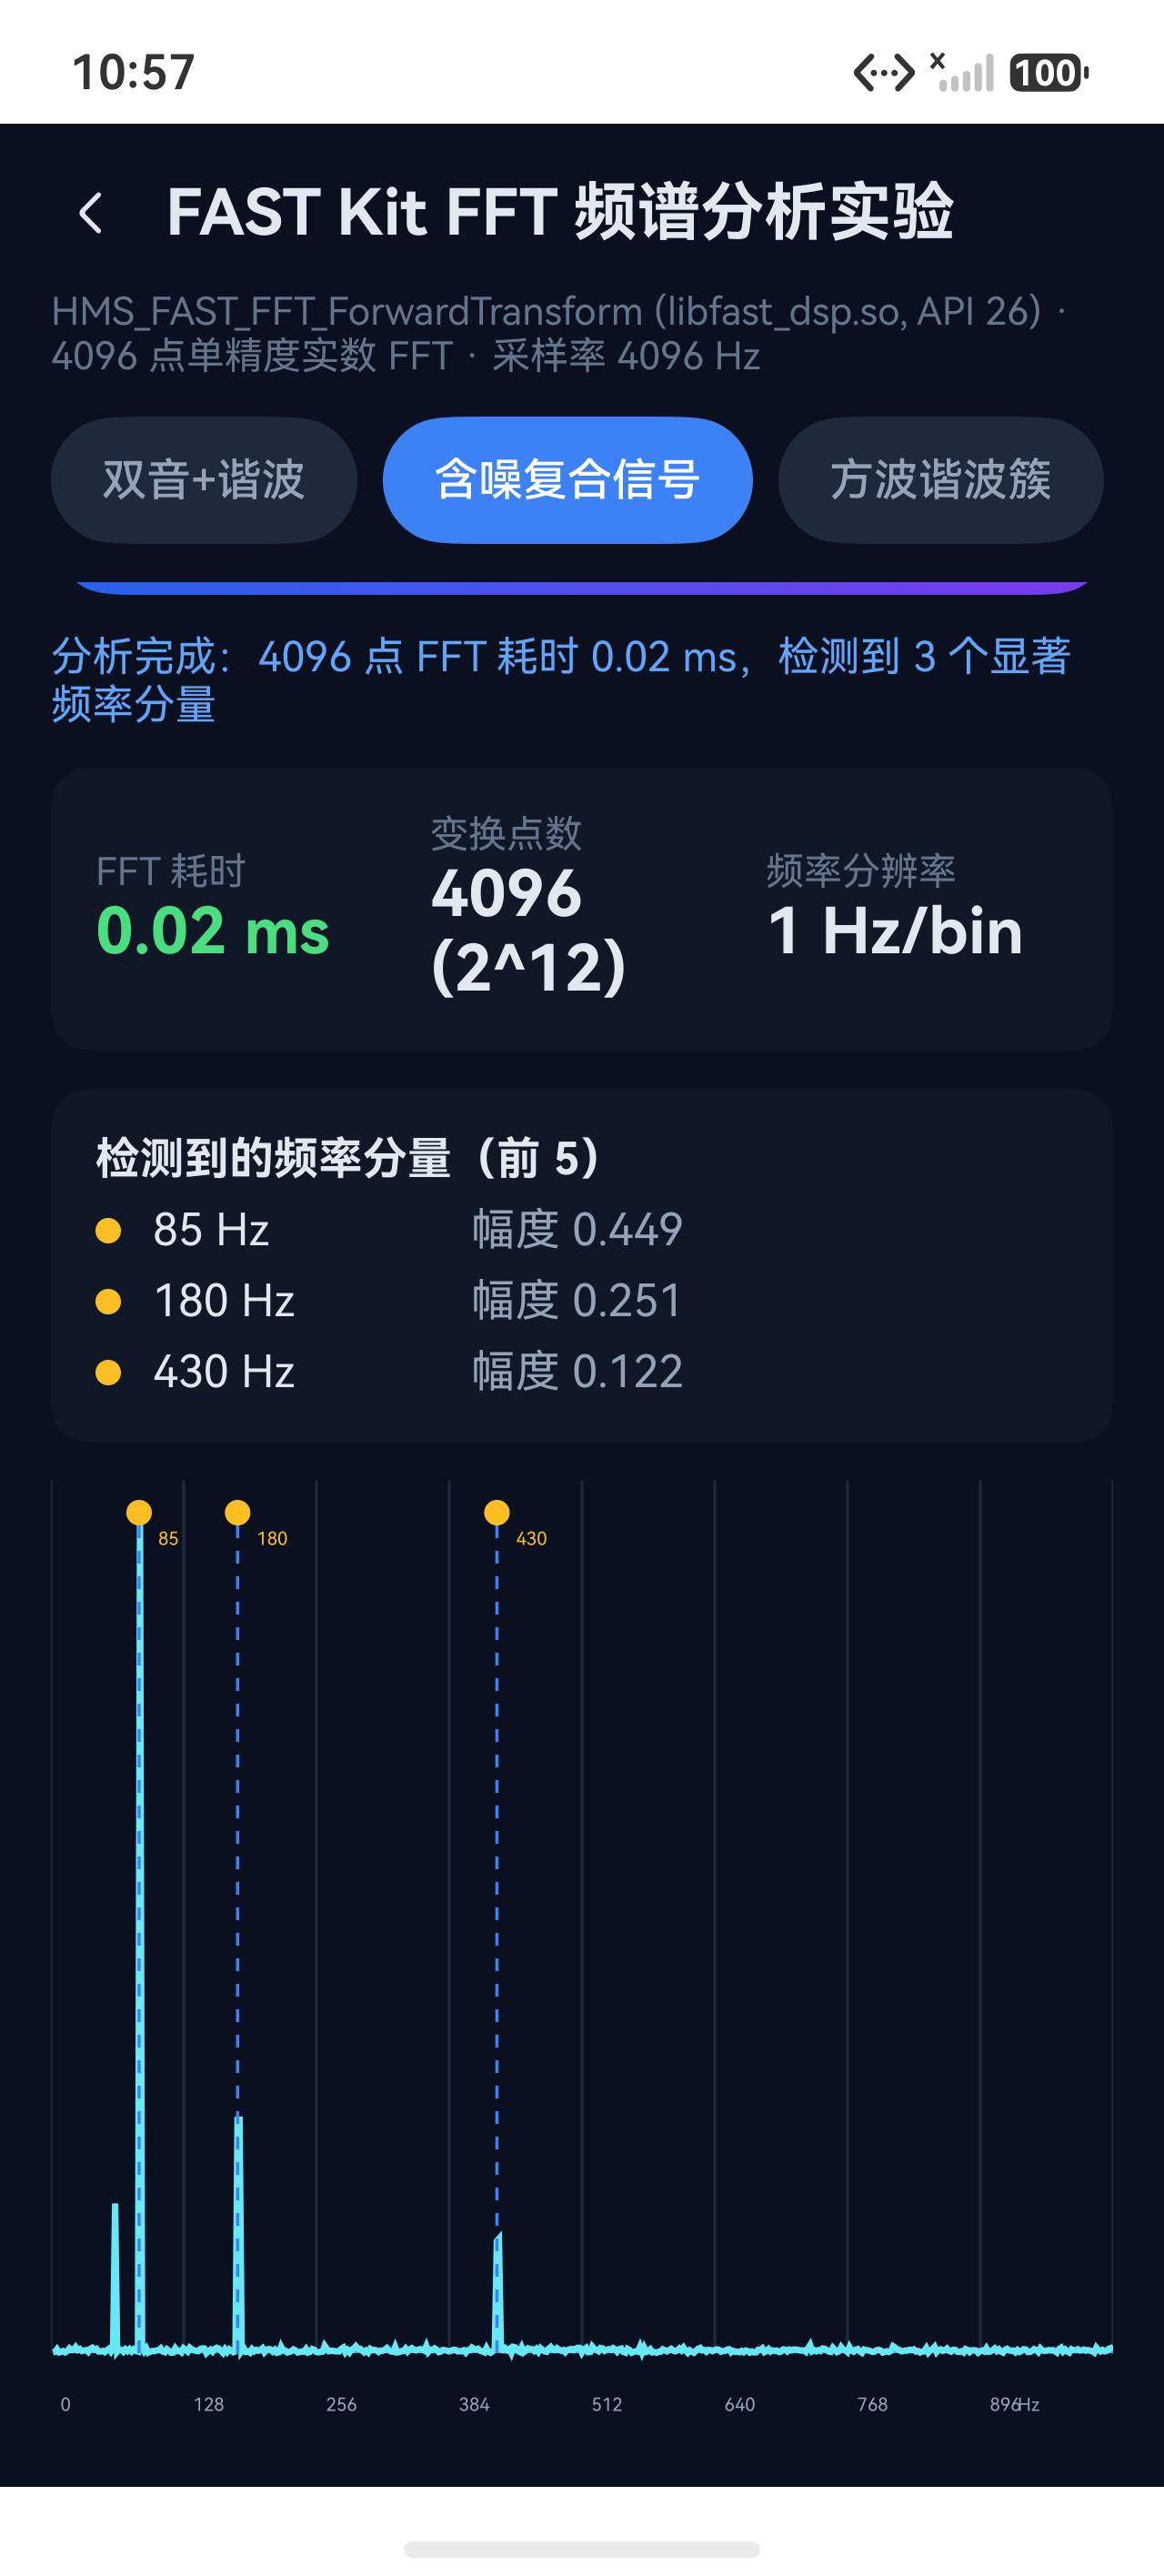
换成含噪复合信号(四个正弦 + 随机噪声),频谱中既能看到清晰的主峰,也能观察到连续的噪声底。自动检测得到的主要分量为:85Hz/0.449(生成振幅 0.45)、180Hz/0.251、430Hz/0.122:
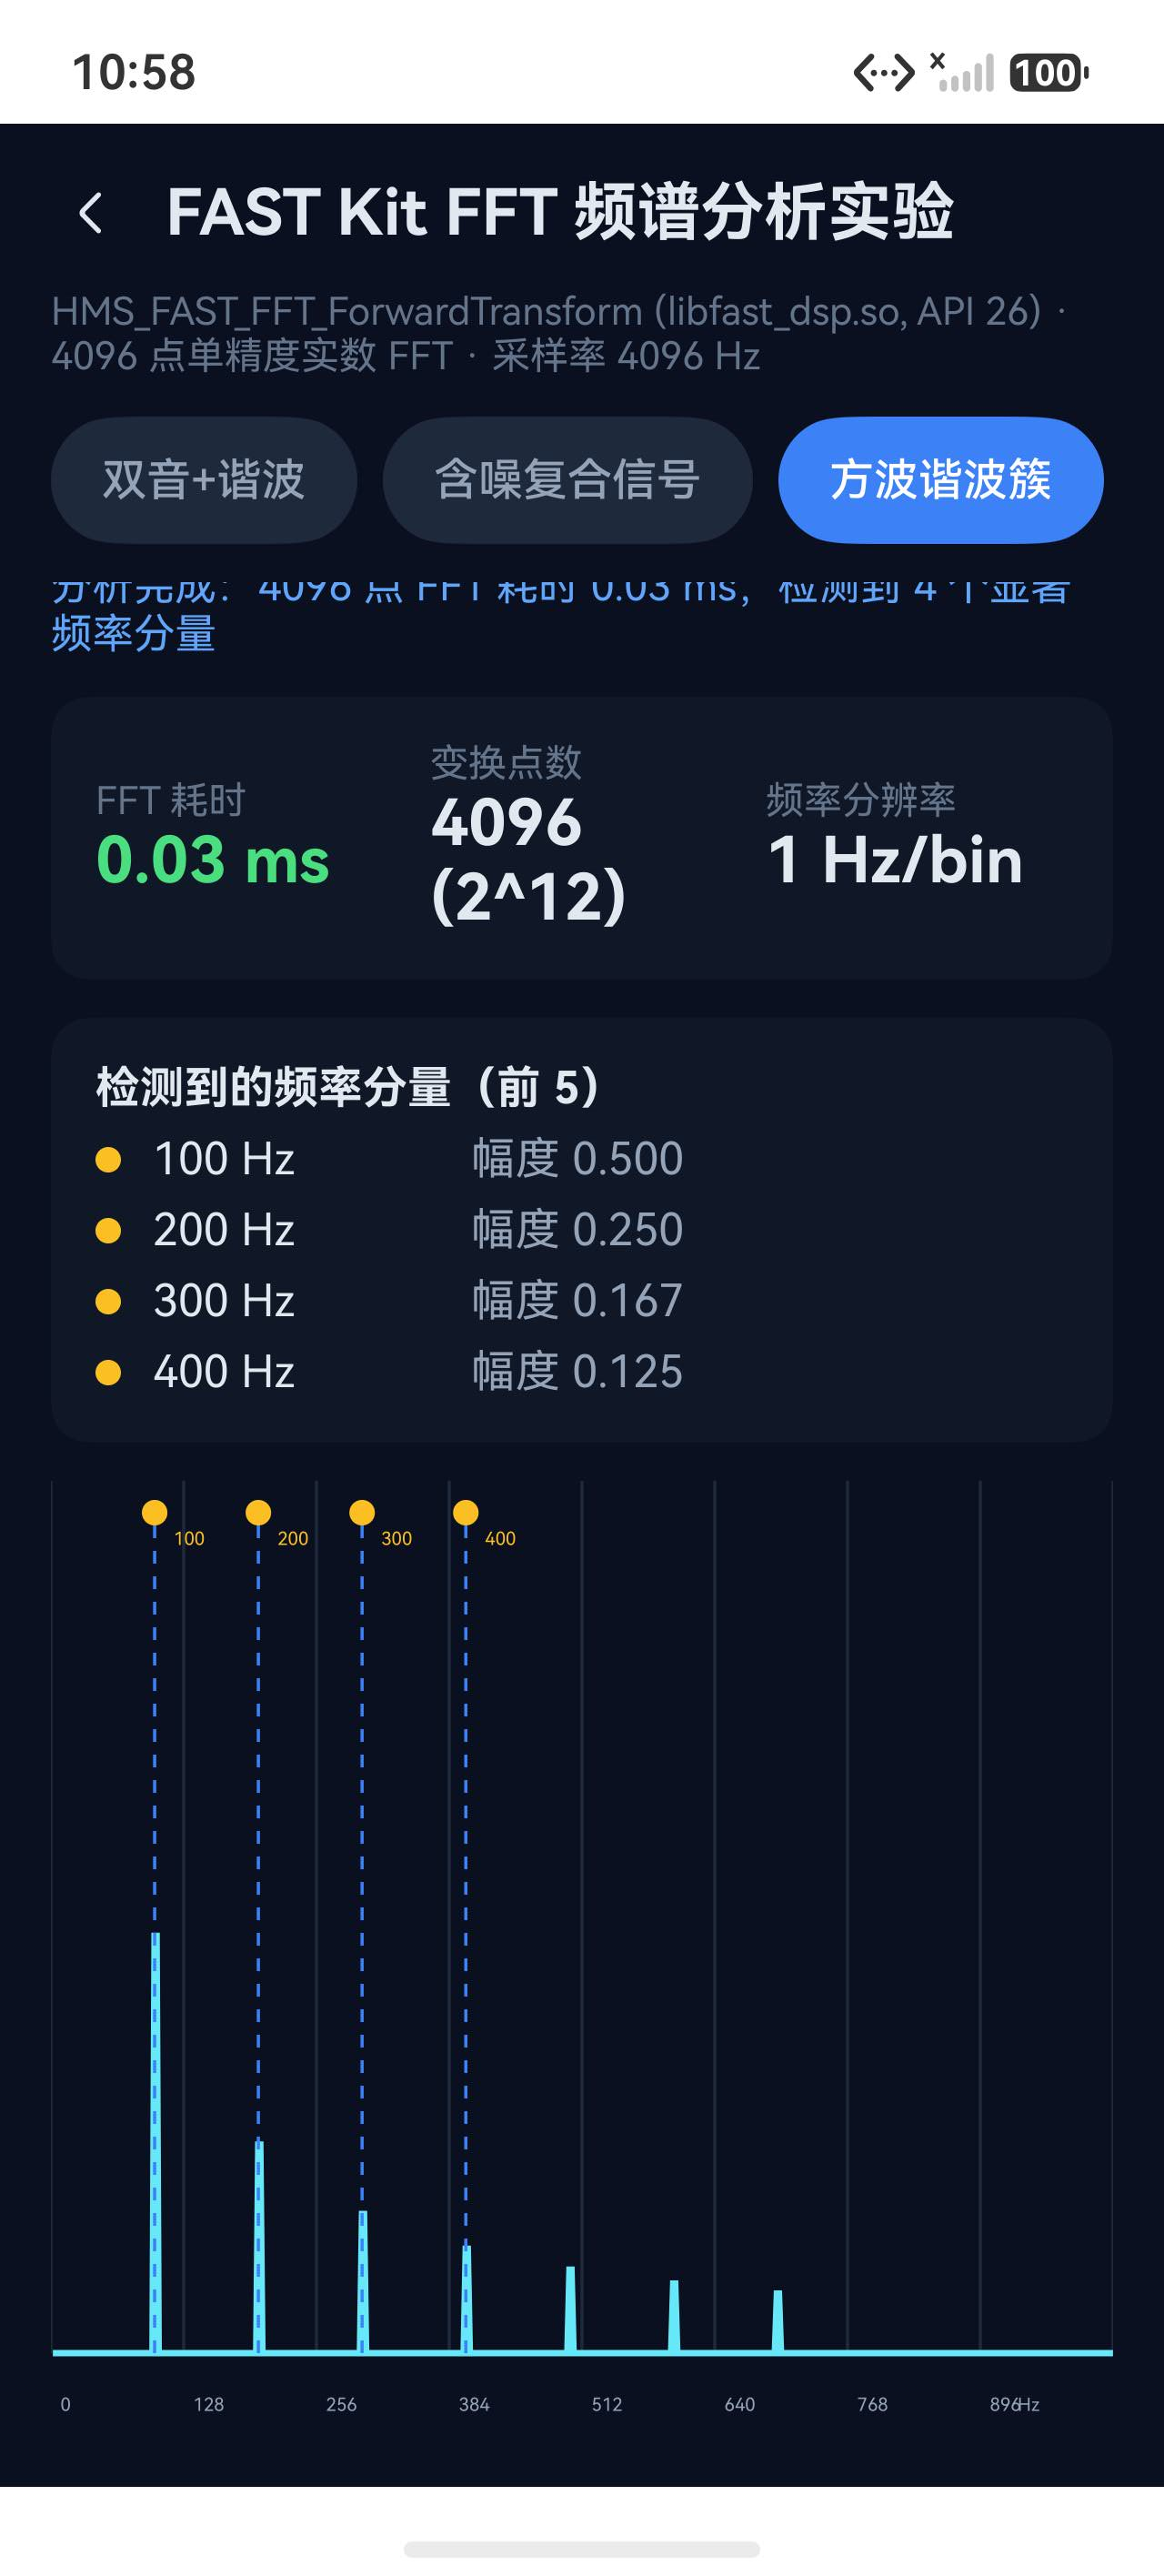
再看方波谐波簇实验:实验中构造了多个谐波分量,频谱呈现梳状结构,幅度按 1/k 递减——实测 100Hz/0.500、200Hz/0.250、300Hz/0.167、400Hz/0.125,与本实验设定的幅度比例接近:
实验二数据小结
对独立开发者而言,这组数字的含义是:在本次模拟器环境下,4096 点 FFT 的单次计算耗时较低,为实时音频可视化、传感器频域监测等端侧场景提供了参考。不过,整体性能仍需结合数据传递、绘制和真机环境评估。
与既有方案相比,变化是什么
算法能力的提供方式变了:排序、FFT 等能力可以通过系统提供的库调用,减少应用自行实现或维护相关底层算法的工作。
调用路径变了:在本次实验中,相关处理由 ArkTS 侧调用转为经 NAPI 桥接到 Native 层执行。与此同时,应用需要承担 NAPI 桥接与工程配置成本。
结果校验仍然必要:自然语言排序规则、FFT 幅度等细节需要在具体输入下验证。本实验分别通过排序结果哈希和幅度还原对接入结果进行了检查。
替换过程可以量化评估:借助可复用的基准对比框架,先确认结果是否一致,再衡量性能收益,为是否采用 FAST Kit 提供依据。
使用限制与实践建议
仅 Native 接口:两个实验的能力都没有 ArkTS 入口,纯 ArkTS 工程接入等于为一次调用引入 native 模块,对于小数据量场景,需要结合收益与接入成本权衡。
API 26 起步 + 版本串新格式:
compatibleSdkVersion必须写"26.0.0"。库不由应用打包:
libfast_utils.so、libfast_dsp.so由系统运行时提供,不进 HAP。低版本设备上动态库加载会失败,上线前务必在最低支持版本的真机验证,并准备降级路径(排序回退Intl.Collator,FFT 回退软件实现)。输入约定严格:
sizeOf必须等于sizeof(char*)、FFT 长度必须是 2 的幂、内容必须合法——桥接层要做完整校验。FFT 要自己加窗:库只提供变换本身,窗函数、幅度标定、单边谱换算都是应用层的事。本文遇到的“谱线消失”问题就与此有关。
版本兼容性:FAST Kit 在 Beta2 引入、正式版开放,API 面还在扩展。正式项目接入前锁定 SDK 版本并做回归测试。
结语
通过自然语言排序与 FFT 频谱分析两个实验,可以更直观地看到 FAST Kit 在不同场景下的实际表现,以及系统级算法能力带来的性能收益:
排序:在本次万级以上长列表测试中,FAST Kit 表现出明显的耗时优势;对于小数据量,仍可根据具体需求选择
Intl.Collator;FFT:4096 点 FFT 在本次模拟器测试中耗时约 0.02~0.03 ms,但窗函数、幅度标定等信号处理细节仍需要应用自行处理。
两个实验也说明,接入系统级算法库的工作不只在于完成接口调用。SDK 版本配置、sysroot 链接以及窗函数与幅度标定等环节,同样影响最终效果。对于准备接入 FAST Kit 的开发者而言,先验证结果正确性,再在目标设备上评估性能,可能比单看接口调用耗时更有参考价值。


