NVIDIA Personal AI Router(PAIR)推出了测试版,让你可以整合本地网络中多台计算机的推理能力,并自动在它们之间分配 AI 请求。该技术主要针对本地多代理 AI 工作负载而设计。在该场景下,多个独立的模型调用可能会导致单个 GPU 不堪重负。
NVIDIA 表示,采用广度优先策略来分配智能代理任务正变得越来越普遍:由主代理将子任务分派给子代理,或者多个代理协同工作以完成更复杂的任务。然而,当本地 GPU 接收的请求过多时,这种方法可能会造成瓶颈。
为了应对这一挑战,NVIDIA PAIR 通过将单个推理请求分配到可用系统中,最大限度地利用本地可用的 AI 计算资源。它能与 Ollama 和 LM Studio 等流行的本地推理服务无缝集成,不需要更改底层架构或代理框架。
智能代理可以通过它所熟悉的本地接口发送请求。PAIR 通过其代理接收请求,识别其引擎和模型要求,并选择一个符合条件的节点。该节点从头到尾执行该请求,并通过 PAIR 将响应发回。智能代理仍然只能看到一个连接,而 PAIR 则在后台处理任务调度。
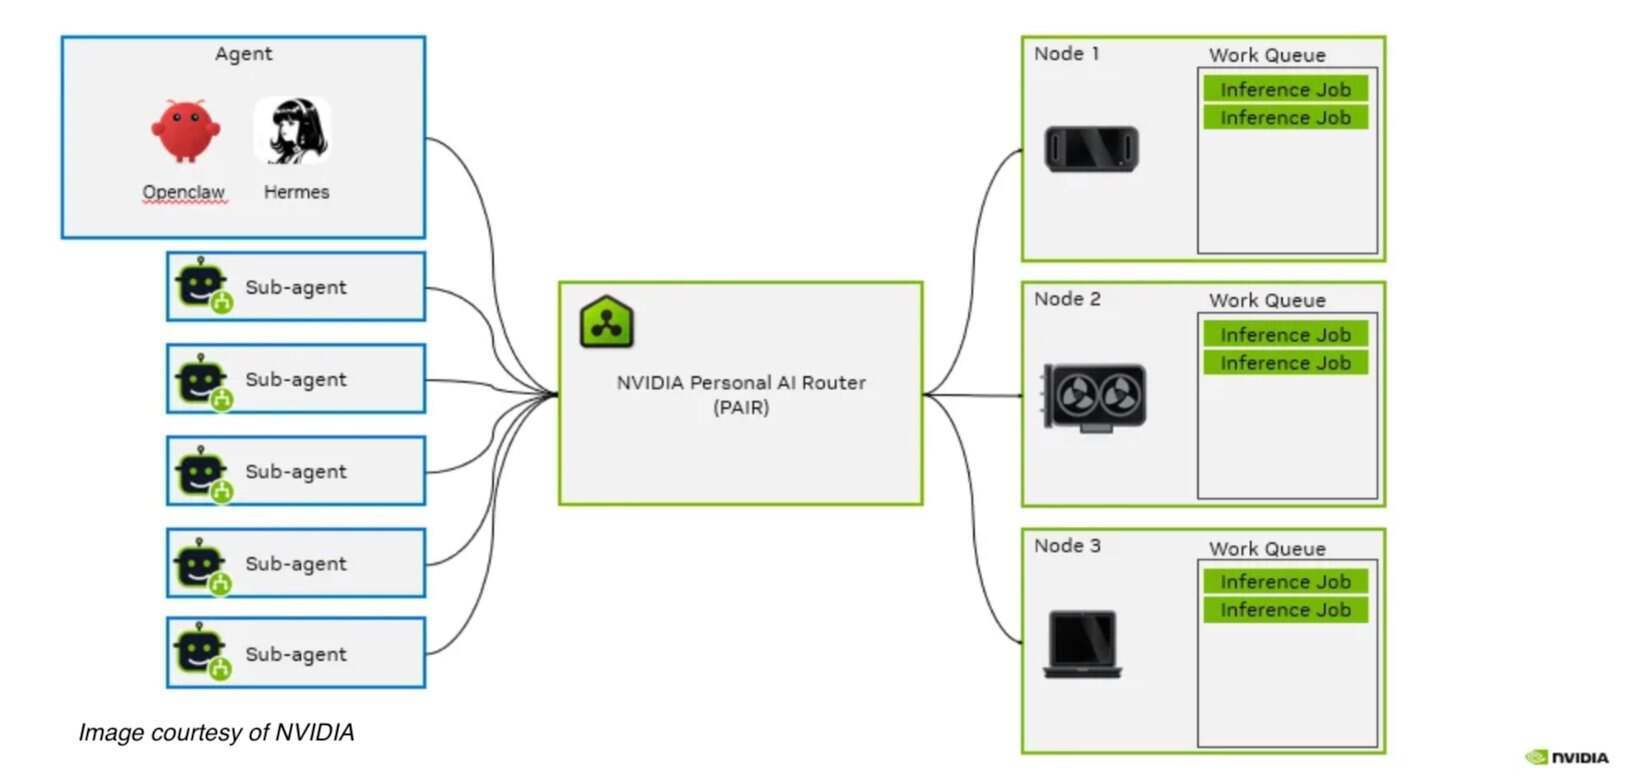
为了展示 PAIR 的功能,NVIDIA 发布了一个将 Hermes Desktop、Ollama 和 PAIR 结合使用的演示,结果显示:通过 PAIR 将 RTX Spark、DGX Spark 和 RTX 5090 组合使用时,与在单台 RTX Spark 笔记本电脑上运行相同的工作负载相比,完成时间大约缩短了一半。在这个演示中,Hermes 将任务分解为五个独立的专项分析,将其分配给相应的节点,整合分析结果,并合成最终计划——涵盖今晚、本周、稍后或无需执行的各项任务。PAIR 负责将这些推理请求分配到可用的节点上,而 Ollama 则在 PAIR 选定的节点上运行模型。不过,NVIDIA 指出,不要将该演示看作是性能保证,因为结果取决于多个因素,包括工作负载并行性、模型、引擎设置、硬件、网络以及节点可用性。
NVIDIA PAIR 可以在 Windows 11、Linux 和 macOS 上使用,同时支持 x64 和 arm64 系统。它还可以将运行不同操作系统的节点配对,仅在确认所需模型或引擎与特定节点兼容时,才会将任务分配给该节点。NVIDIA 明确指出,PAIR 不会“将 GPU 合并或将 VRAM 整合成一个更大的加速器”。相反,它会将单个推理请求分配到可用的系统上。
尽管有这些免责声明,NVIDIA 的公告仍然在社交媒体上引发了一些困惑,部分用户将 PAIR 解读为一种与第三方共享可用计算资源的解决方案,或是通过组合性能较低的计算资源来运行复杂模型的方案。
Reddit 用户 Vegetable-Warthog81 描述了其使用 PAIR 将推理任务分配给三块运行 Qwen 3.8 27B(通过 Ollama)模型的 RTX 5090 显卡时所获得的良好体验:
PAIR 让在三台机器之间分配任务变得相当轻松。对于那些需要长时间重复执行的“苦力活”,我更注重稳定性以及确保所有 GPU 保持满负荷运行,而非追求每秒最大令牌生成量,PAIR 的表现出乎意料地出色。
PAIR 可以从 GitHub 平台下载。要了解关于它的分步使用指南,可以查阅入门指南文档获取详细说明。
如果你正在寻找一个能够让多个参与方通过网络共享 GPU 计算资源的平台,不妨看看 Petals 或 Mesh LLM。Mesh LLM 还支持使用 Skippy 将过大而无法在单台机器上运行的模型进行拆分。
原文链接:https://www.infoq.com/news/2026/09/nvidia-pair-ai-task-router/


