Uber 开发了一种自动化服务依赖关系映射方案,用于梳理下游故障在服务网格中的传播方式。该系统利用 RPC 中间件来关联生产请求中的调用方和被调用方故障,将依赖关系分类为 fail-close(故障关闭)、fail-open(故障开放)或 unknown(未知)。Uber 表示,该方案已为关键 API 编目了依赖关系,并索引了服务网格中的大多数 fail-close 异常。
Uber 工程团队在 LinkedIn 帖子中阐述了项目的设计初衷:
请求发生失败时该如何定位真正的故障根源?在 Uber 的业务规模之下,这件事会迅速变得错综复杂。成千上万的服务与依赖互相交互,传统的链路追踪往往无法让工程师快速拿到完整的故障视图。
在微服务架构中,请求会经过多层嵌套的异步服务调用,很难判断究竟是哪一项依赖引发故障。Uber 将 fail-close 依赖定义为故障能够持续导致其调用方失败的依赖。fail-open 依赖则可以在不导致调用方失败的情况下发生故障。如果采集到的证据不足,就归类为 unknown。这样的分类可以应用到整条调用链路上,以此判断故障会如何向源头 API 传播。
Uber 最初考虑使用分布式追踪来建立这些关系,但发现对罕见故障的采样速度太慢。Uber 表示,超过 99.9% 的请求都能无错误且在可接受的延迟范围内完成。如果采样率为 0.01%,服务可用性 99.9%,那么一条出错请求被采样捕获的概率仅为千万分之一。因此,以每秒 500 个请求的速度捕获一个失败请求可能需要 5 小时 33 分 20 秒。
Uber 工程师 Deepanshu Mehndiratta、Alok Srivastava 和 Shivam Jindal 表示,该方案是在单个请求可见性和更快的依赖分析之间做出的权衡。
我们需要反馈速度更快的方法,于是我们开始通过日志识别依赖关系。
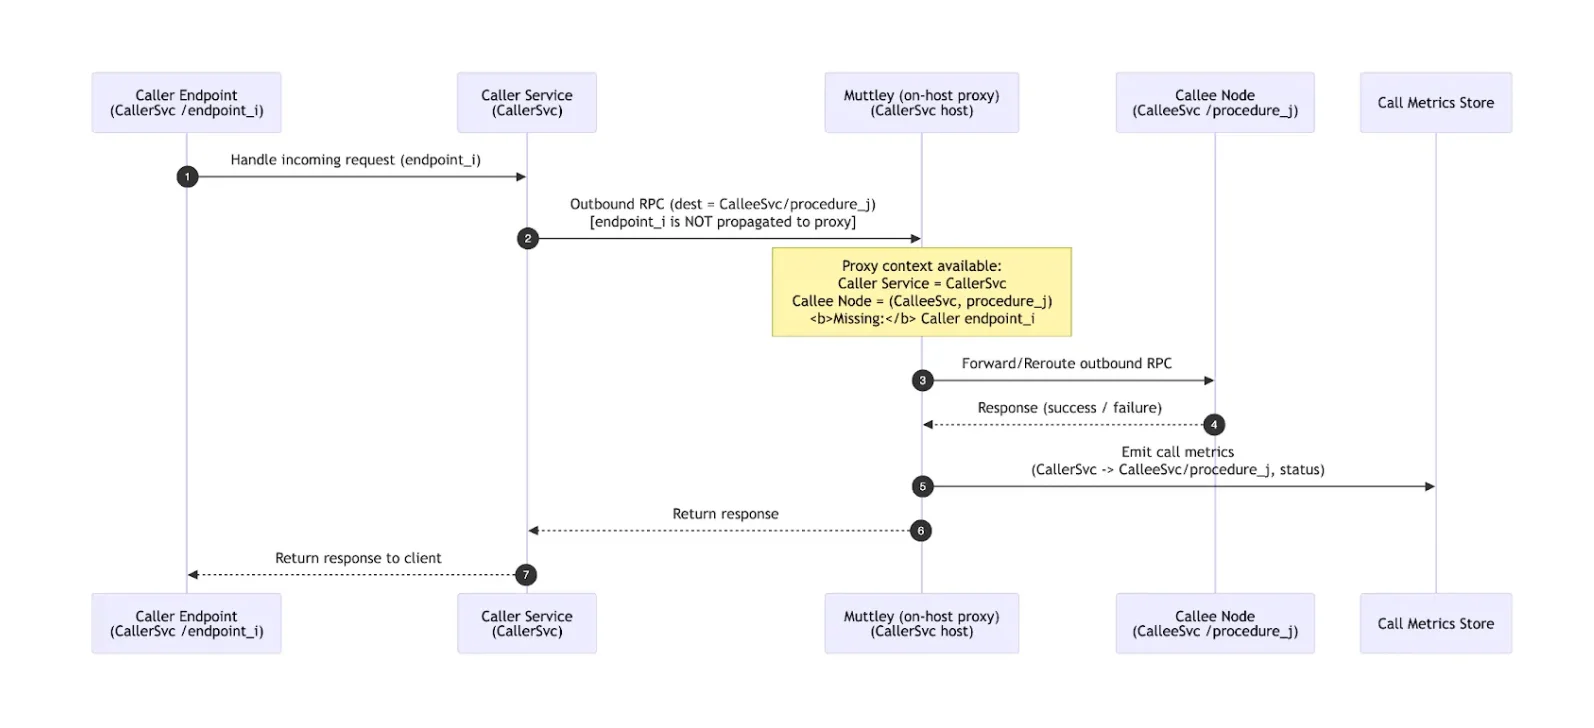
Uber 通过 Muttley 路由服务间的请求,Muttley 是一个用于路由和遥测的主机内代理。但 Muttley 无法获取调用方端点上下文,无法进行精确的依赖关联。Uber 将分析功能添加到 YARPC(其用于 Go 语言和 Java 的 RPC 框架)中,依靠入站、出站中间件实现核心逻辑。
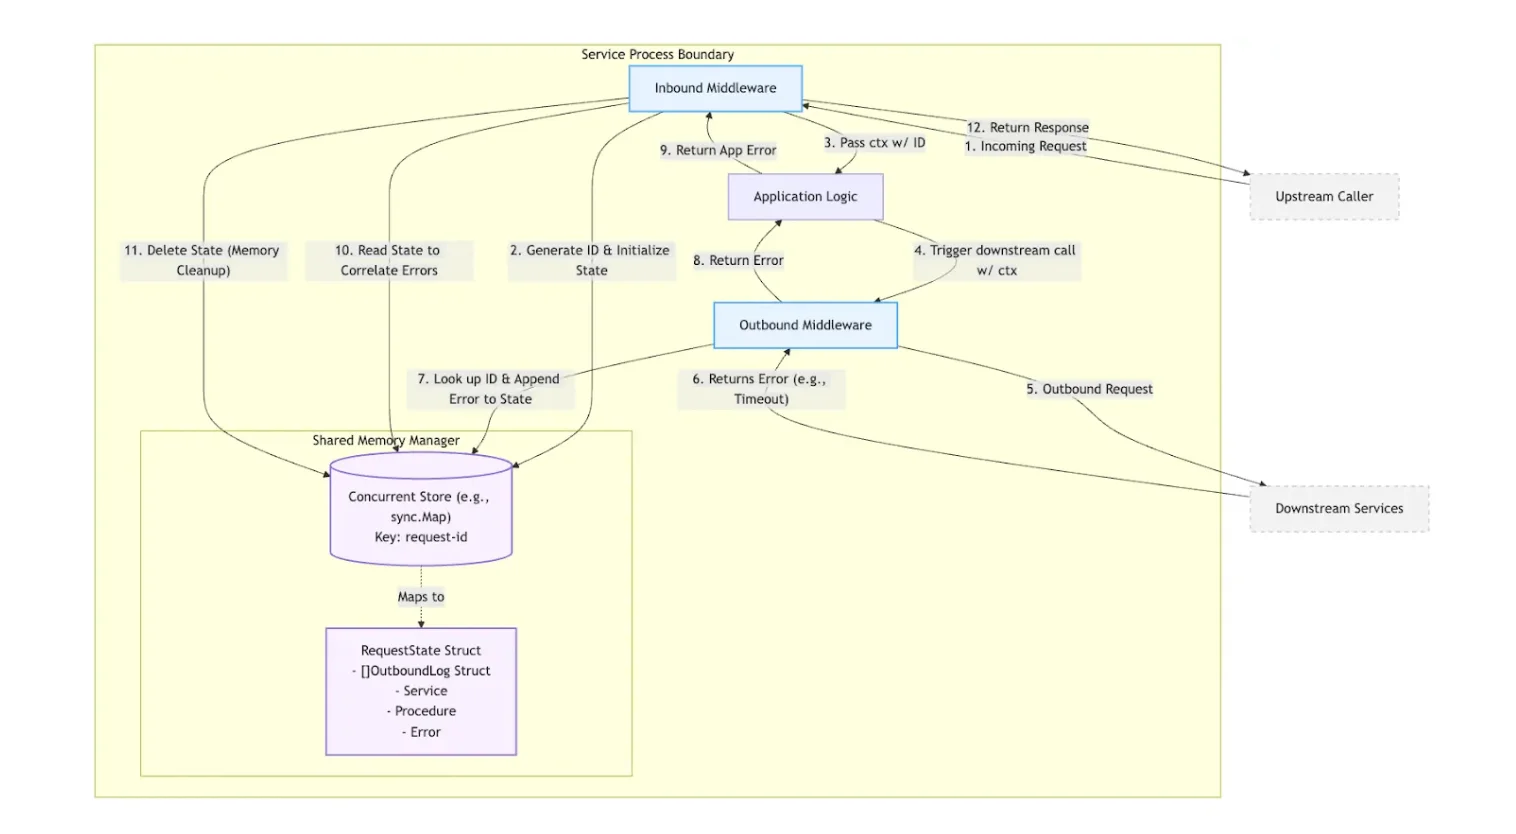
入站中间件生成一个请求 ID,并在内存组件 RequestTracker 中记录调用方服务和端点。该 ID 通过 Go 的 context 对象进行传播,使出站中间件能够记录下游服务、端点和调用结果。在请求完成时,中间件会发出捕获调用方和被调用方故障状态的指标。
Uber 根据观察到的调用方和被调用方结果计算每个调用方依赖的故障关联概率。值 ≥0.8 被分类为 fail-close,≤0.2 被分类为 fail-open,中间值则归为 unknown。重试操作单独处理,避免将其判定为独立的依赖。与使用 OpenTelemetry 构建的分布式追踪管道(可以通过尾部采样基于错误或延迟保留追踪)不同,Uber 使用中间件指标来捕获生产故障,无需存储和评估单个追踪的额外开销,以请求级别的细节换取更广的覆盖范围。
查看英文原文:https://www.infoq.com/news/2026/10/uber-automated-dependency/


