本原创文章帖发布在华为开发者联盟社区,欢迎开发者前往访问评论交流,更多与该内容相关讨论,请点击原帖查看:运维态高效处理应用冻屏-华为开发者话题 | 华为开发者联盟
1.1 运维态应用冻屏分析流程
应用冻屏是应用性能优化的重要问题,本文档介绍在运维态下如何通过 APMS 平台进行应用冻屏事件的标准化排查、分析、定位和修复闭环流程。
1.1.1 标准化排查流程
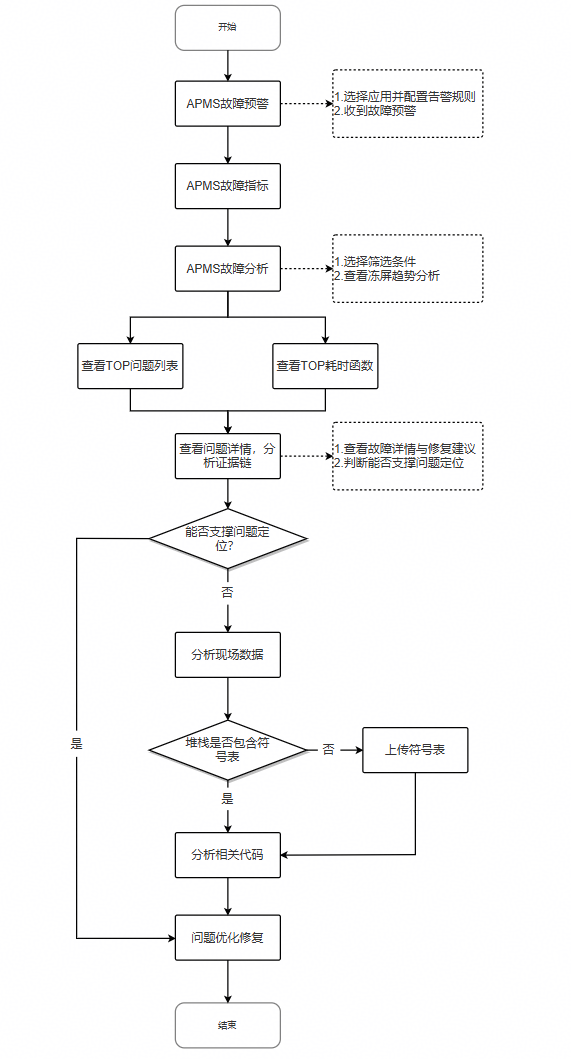
1.1.1.1 整体流程图
1.1.1.2 排查步骤
步骤 1:APMS 故障预警 - 在 APMS 平台配置应用冻屏监控告警规则,设置监控时段、频率和触发条件。
步骤 2:问题查看与聚类 - 通过 APMS 故障指标、APMS 故障分析页面,可筛选冻屏类型问题,查看冻屏趋势、Top 问题列表与 Top 耗时函数。
步骤 3:根因定位与分析 - 分析故障模块、发生次数、影响设备数等关键信息,定位高优问题。查看问题详情,通过 AI 分析、证据链、现场数据、采样栈数据,深入分析冻屏原因。
步骤 4:修复建议验证与闭环 - 根据修复建议优化代码,并验证修复效果,形成闭环。
1.1.2 指标监控与关键信息提取
1.1.2.1 应用冻屏监控信息详情
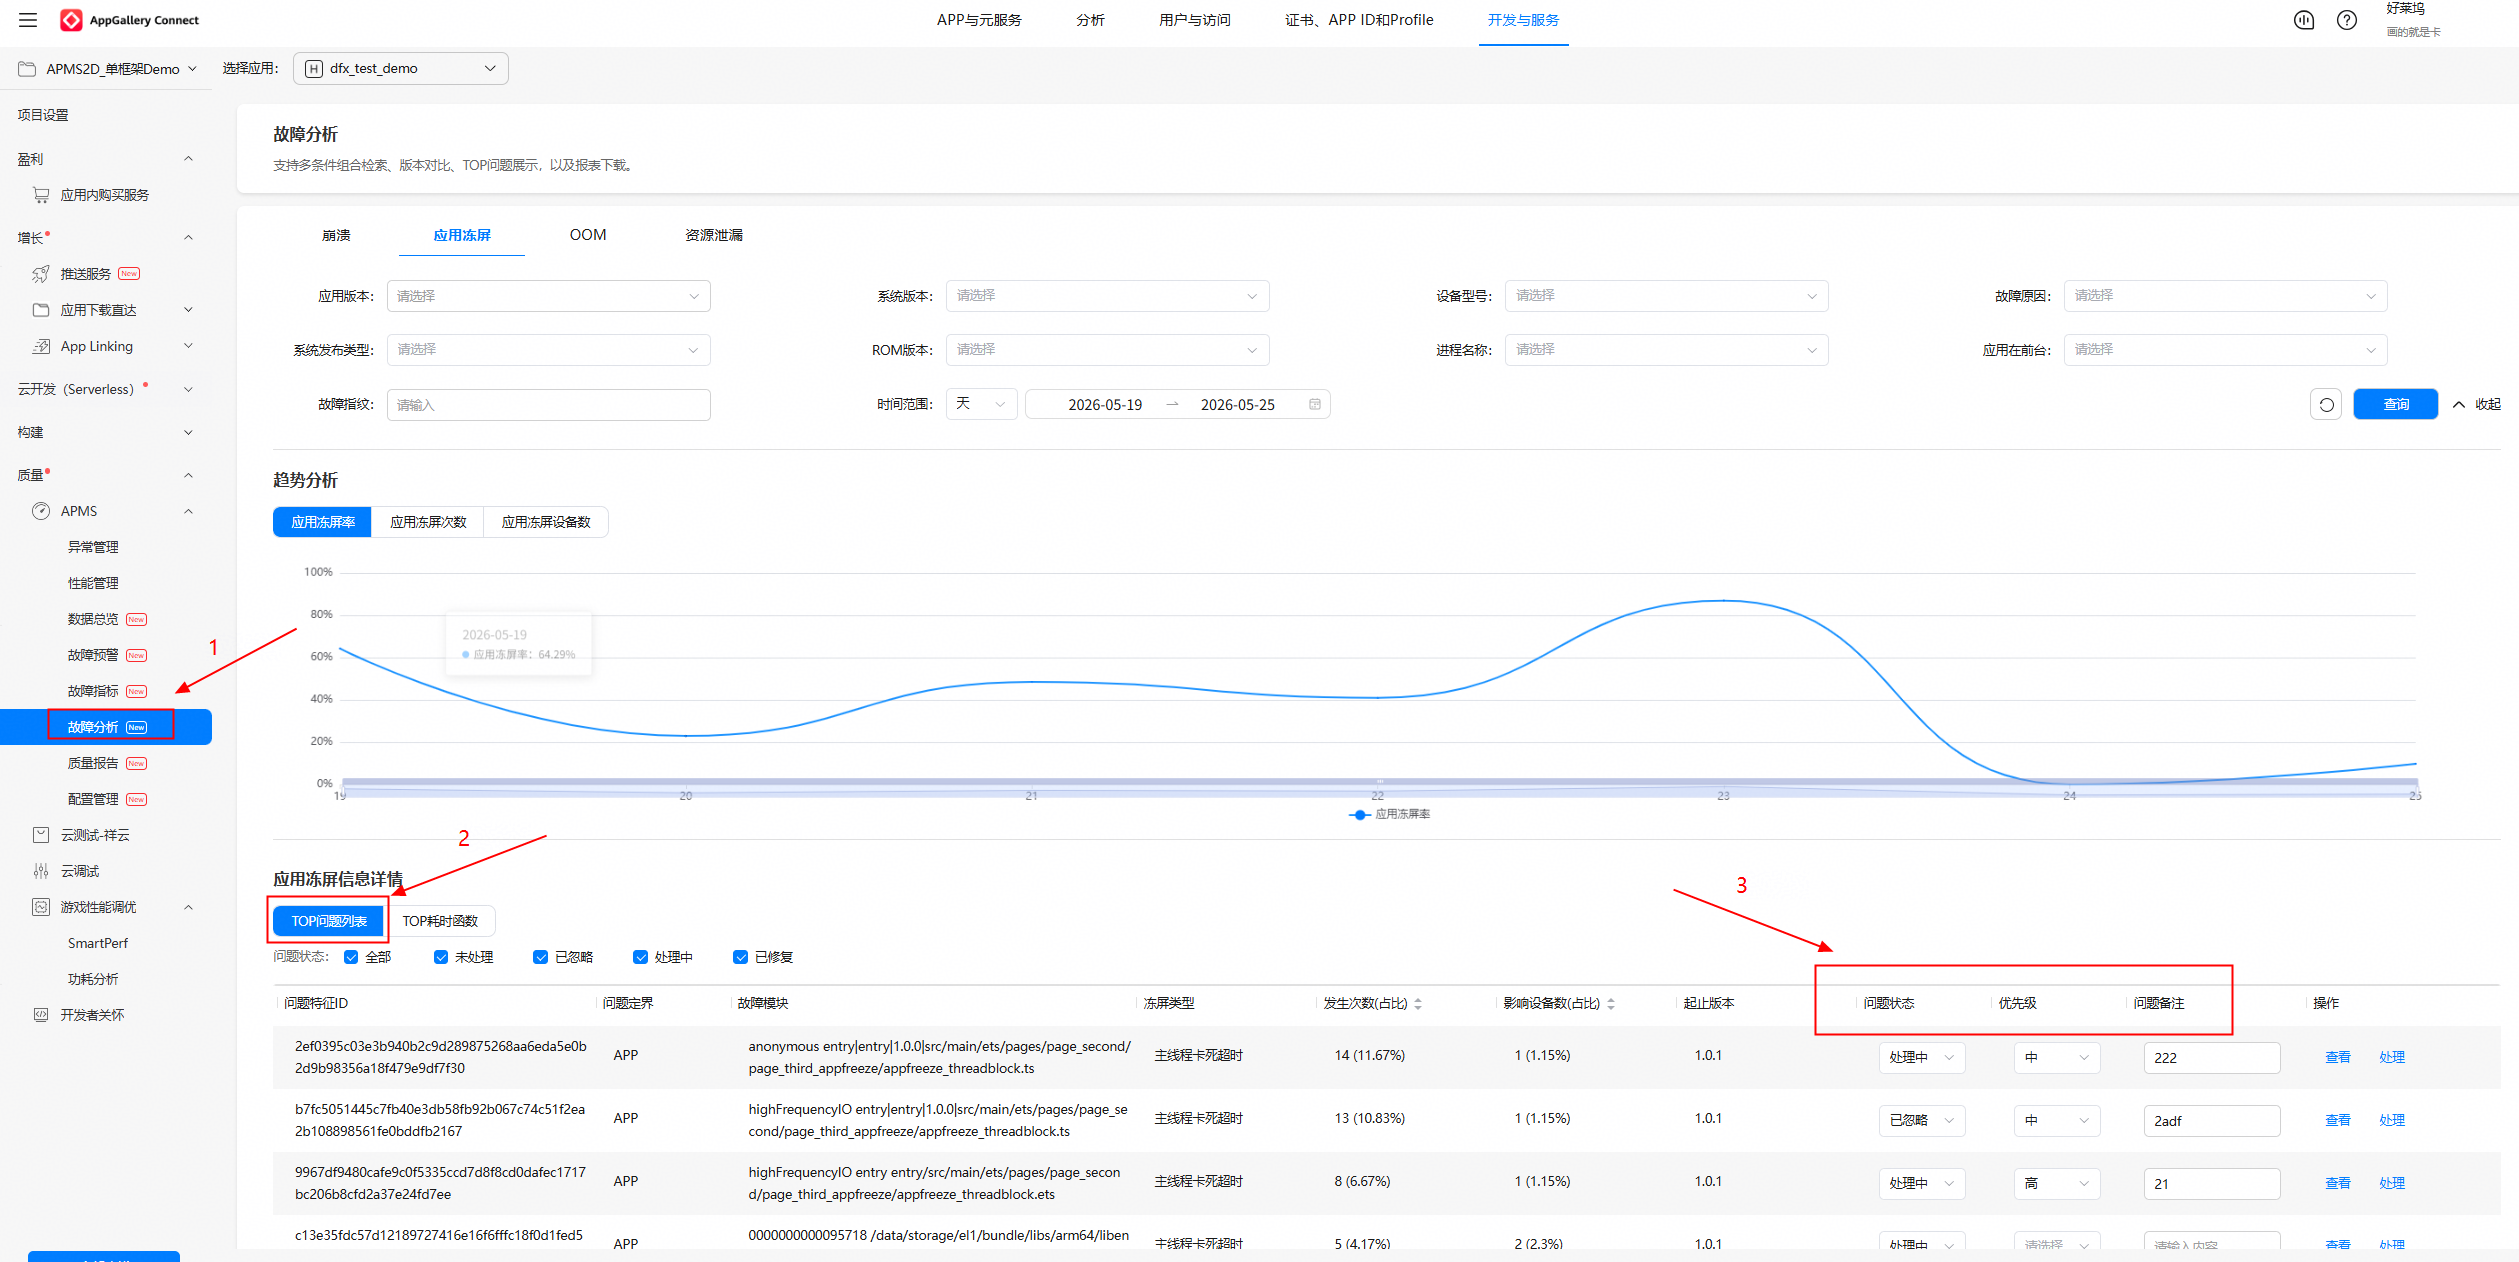
故障分析页面,开发者可查看应用的 Top 问题列表,结合业务对问题进行描述,标记优先级与问题状态,高优处理未修复的高优先级问题。
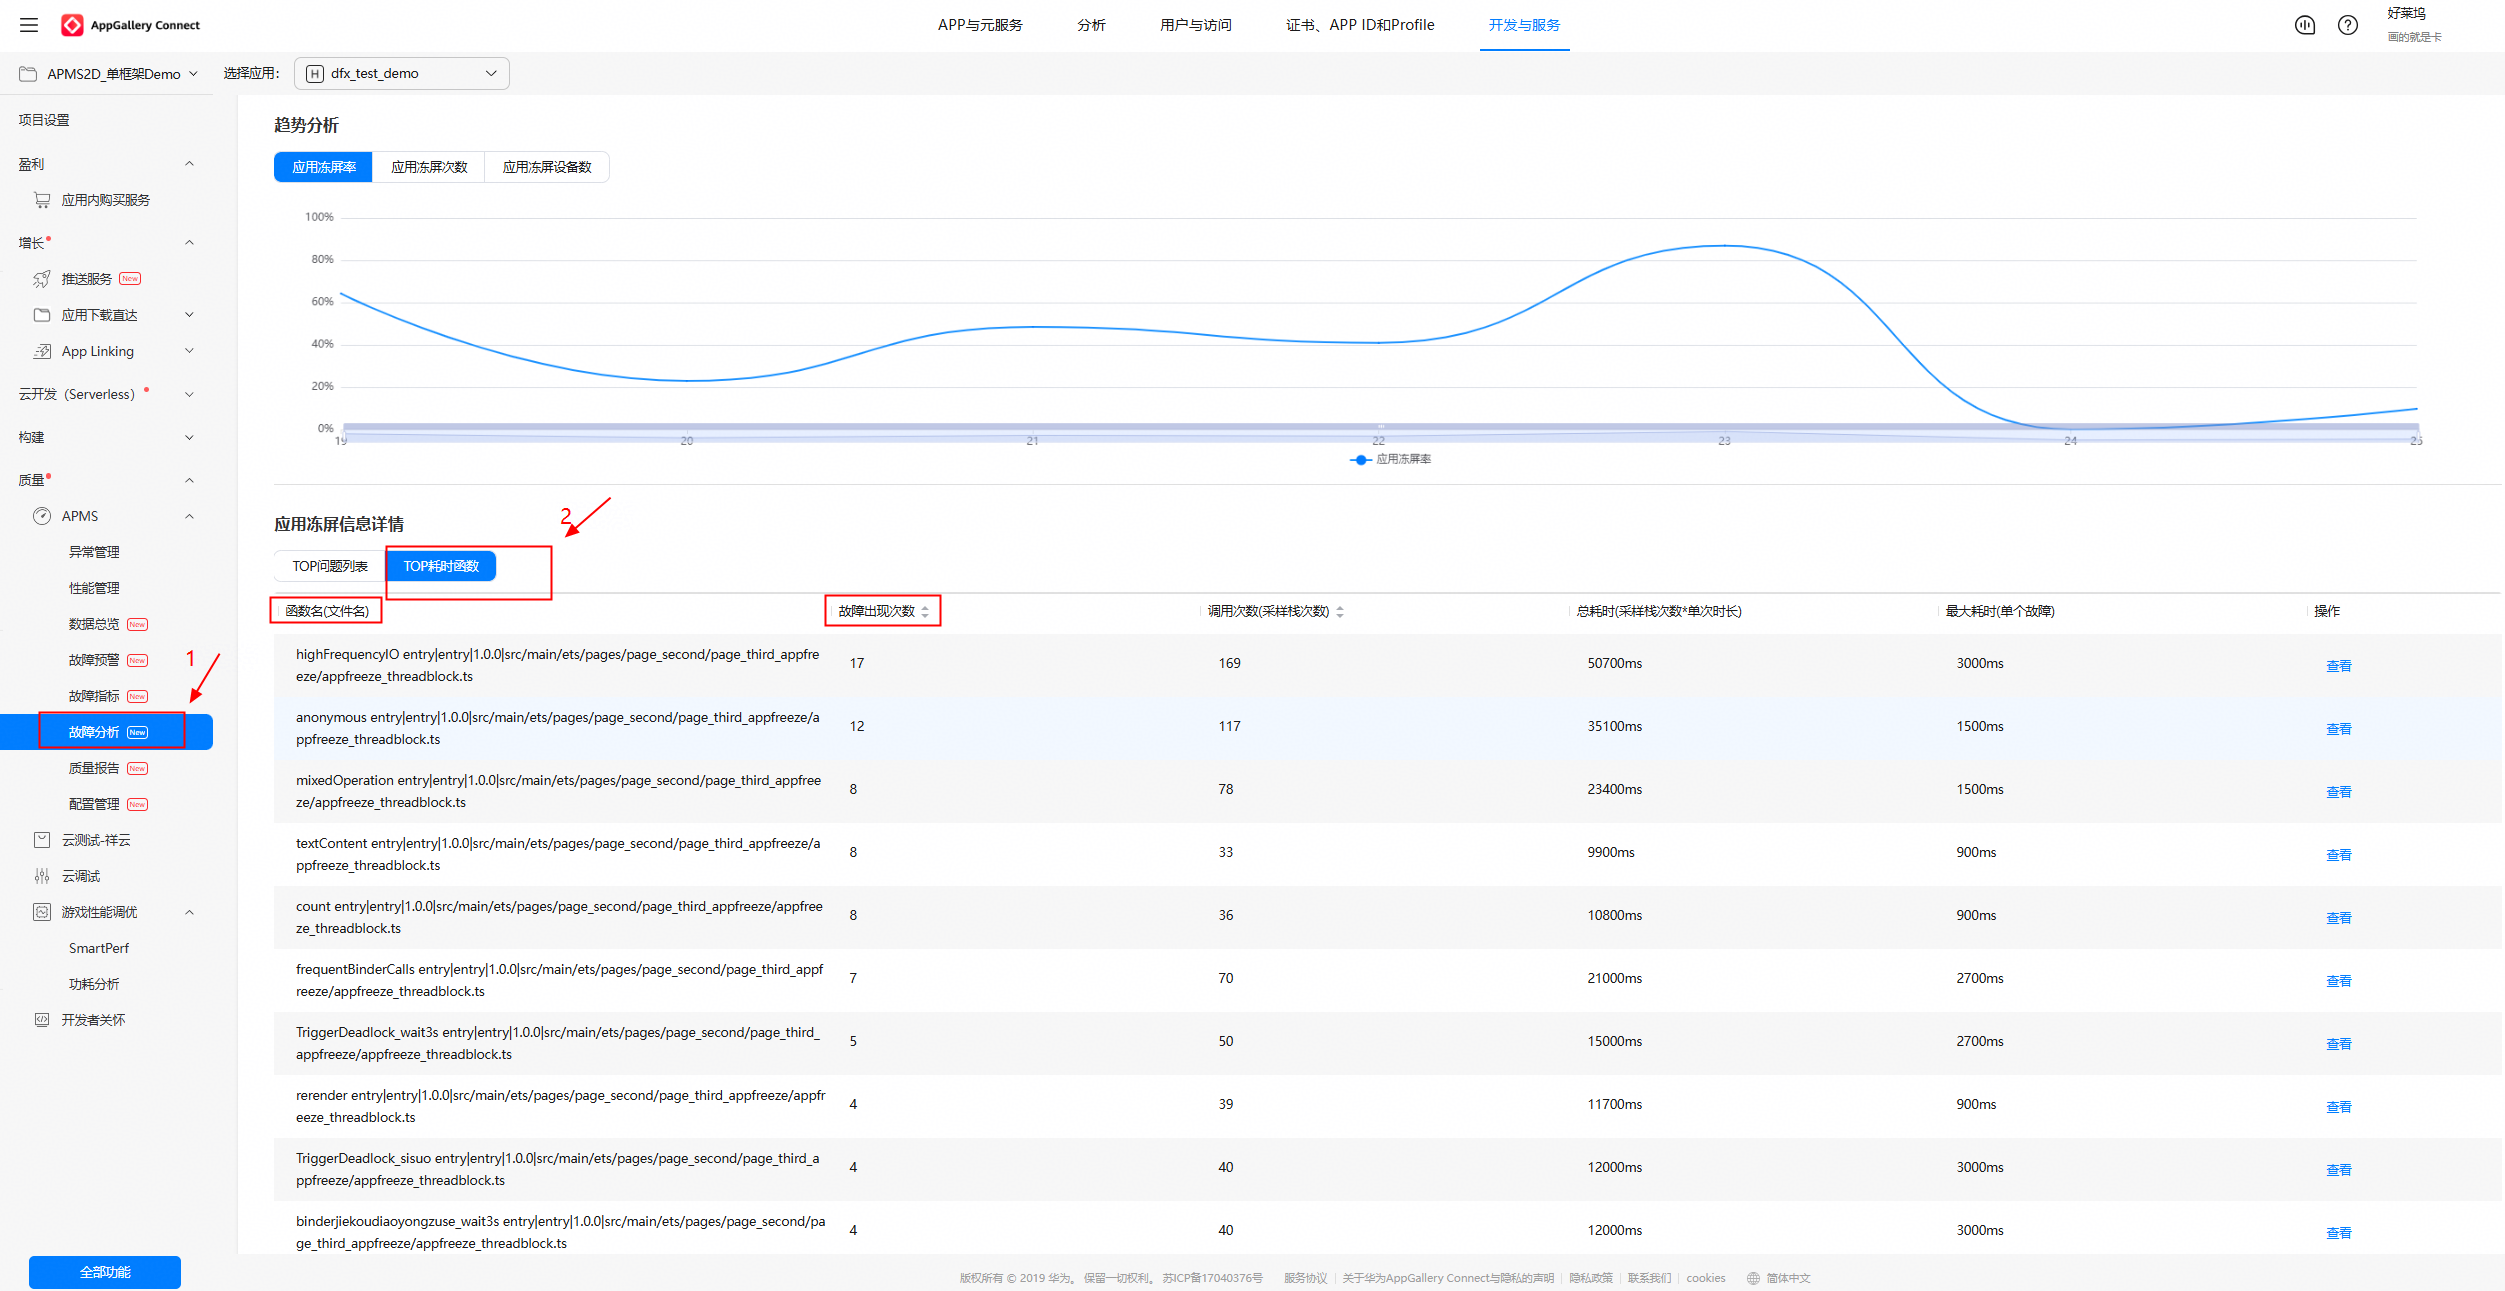
页面也展示应用的 Top 耗时函数,开发者可重点关注问题高发的函数并结合业务优先级进行修改优化。
1.1.2.2 关键指标说明
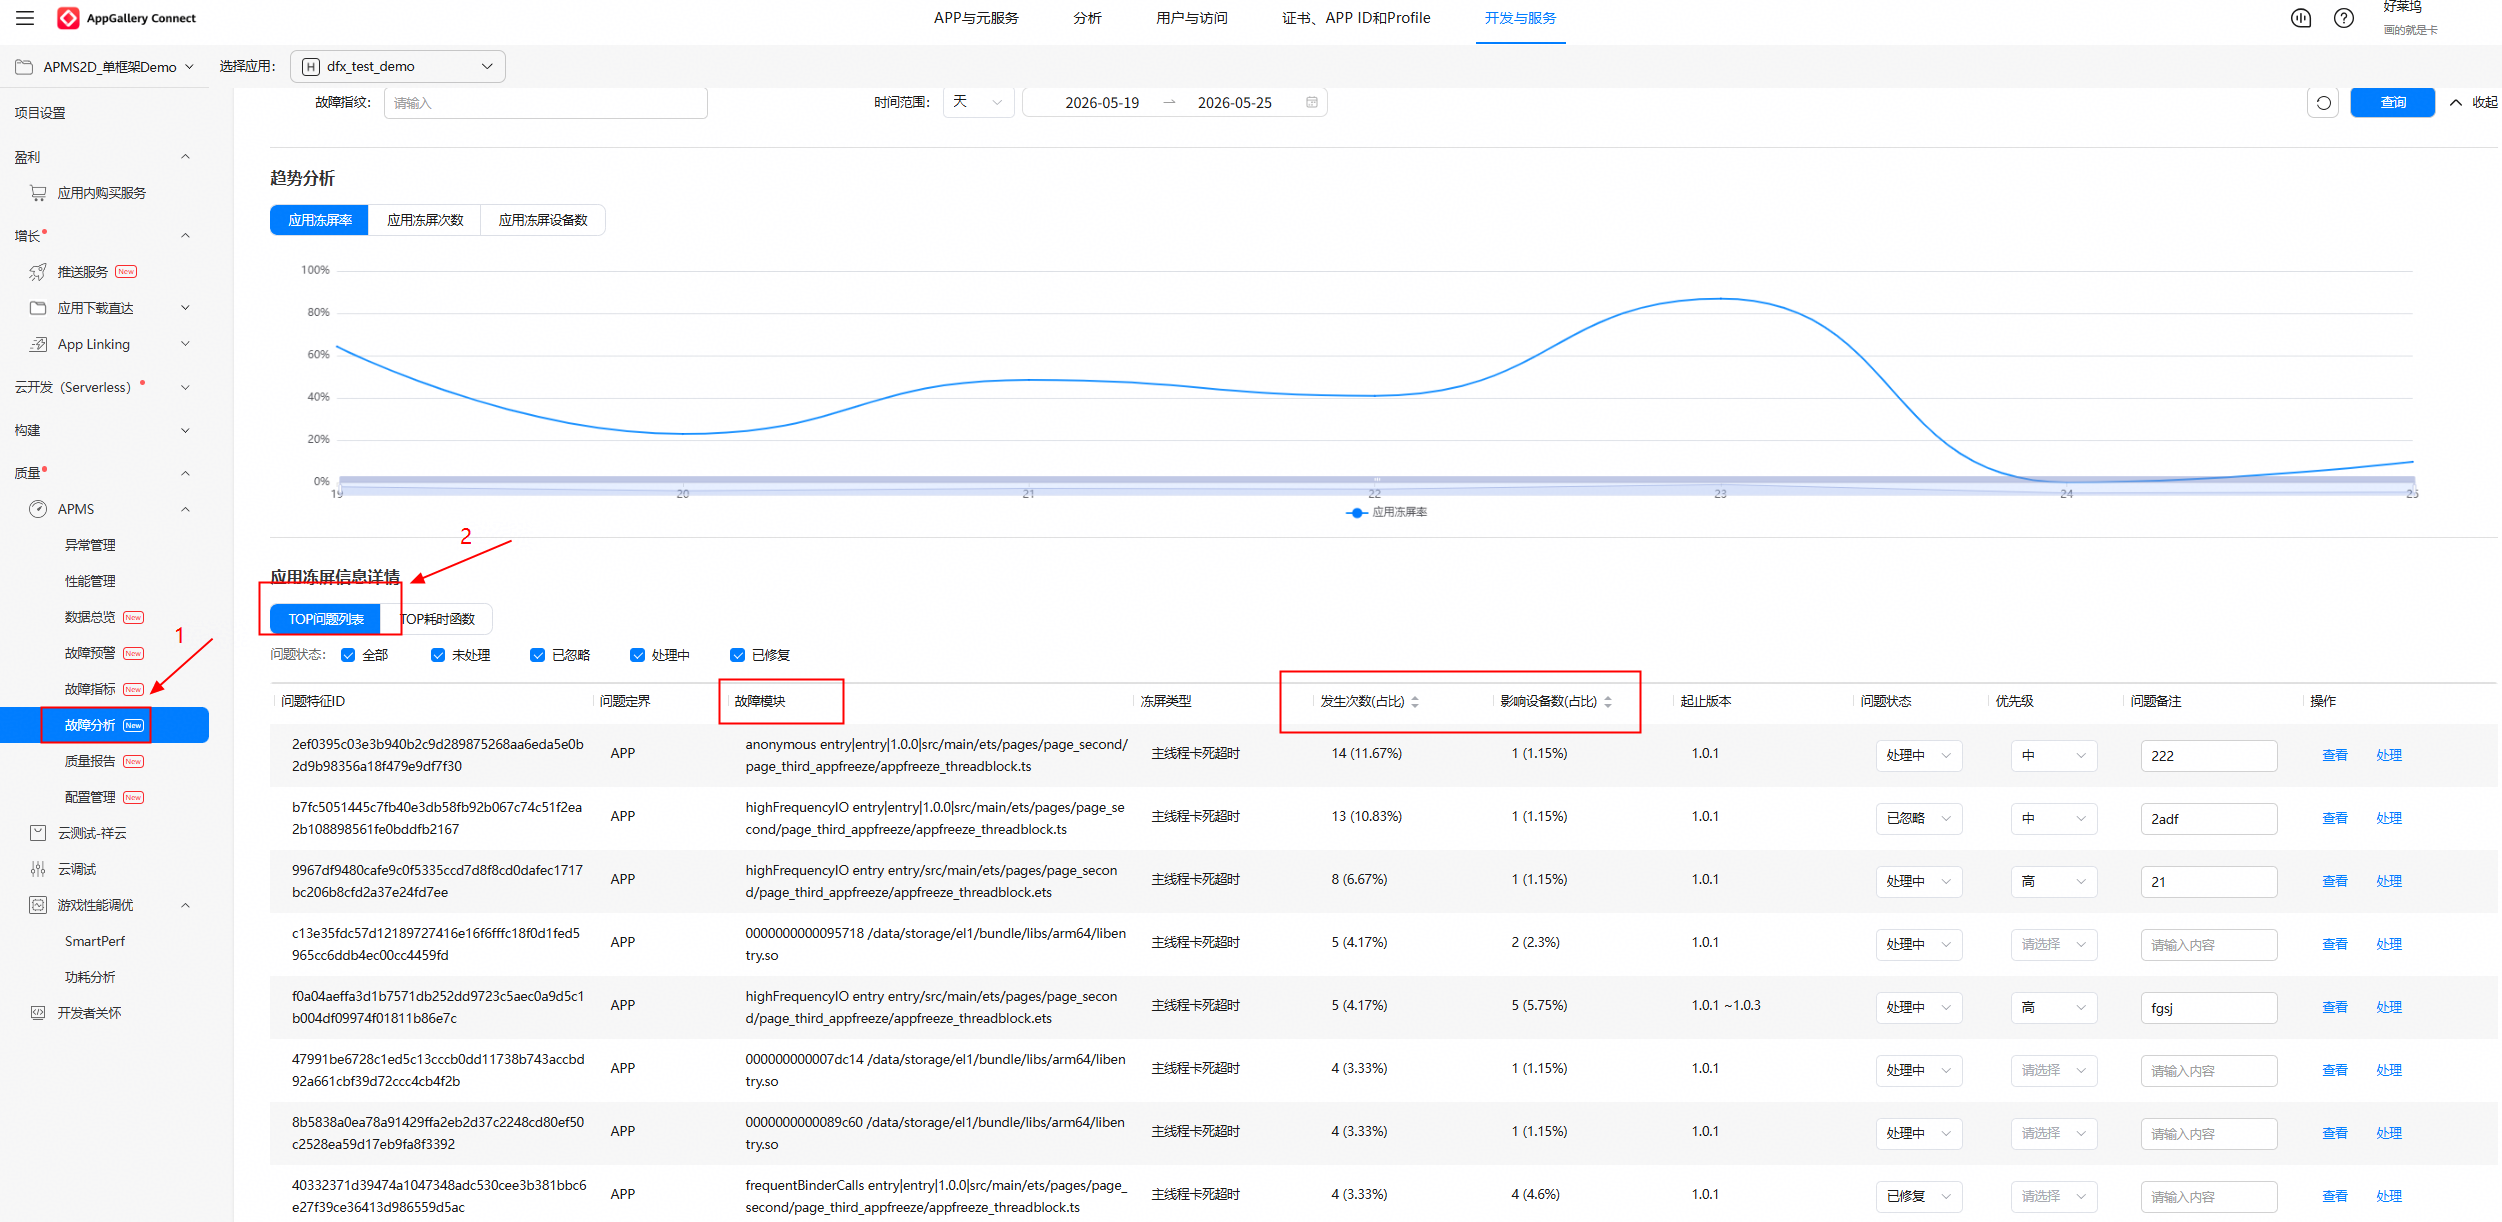
故障模块:发生冻屏的模块或组件,用于定位问题范围
发生次数(占比):冻屏问题发生的频率,帮助判断问题严重程度
影响设备数(占比):受影响的设备数量,评估问题影响面
1.1.2.3 关键信息提取
开发者在分析卡死问题时,需要重点关注问题详情页的以下信息:
(1) 卡死趋势图表
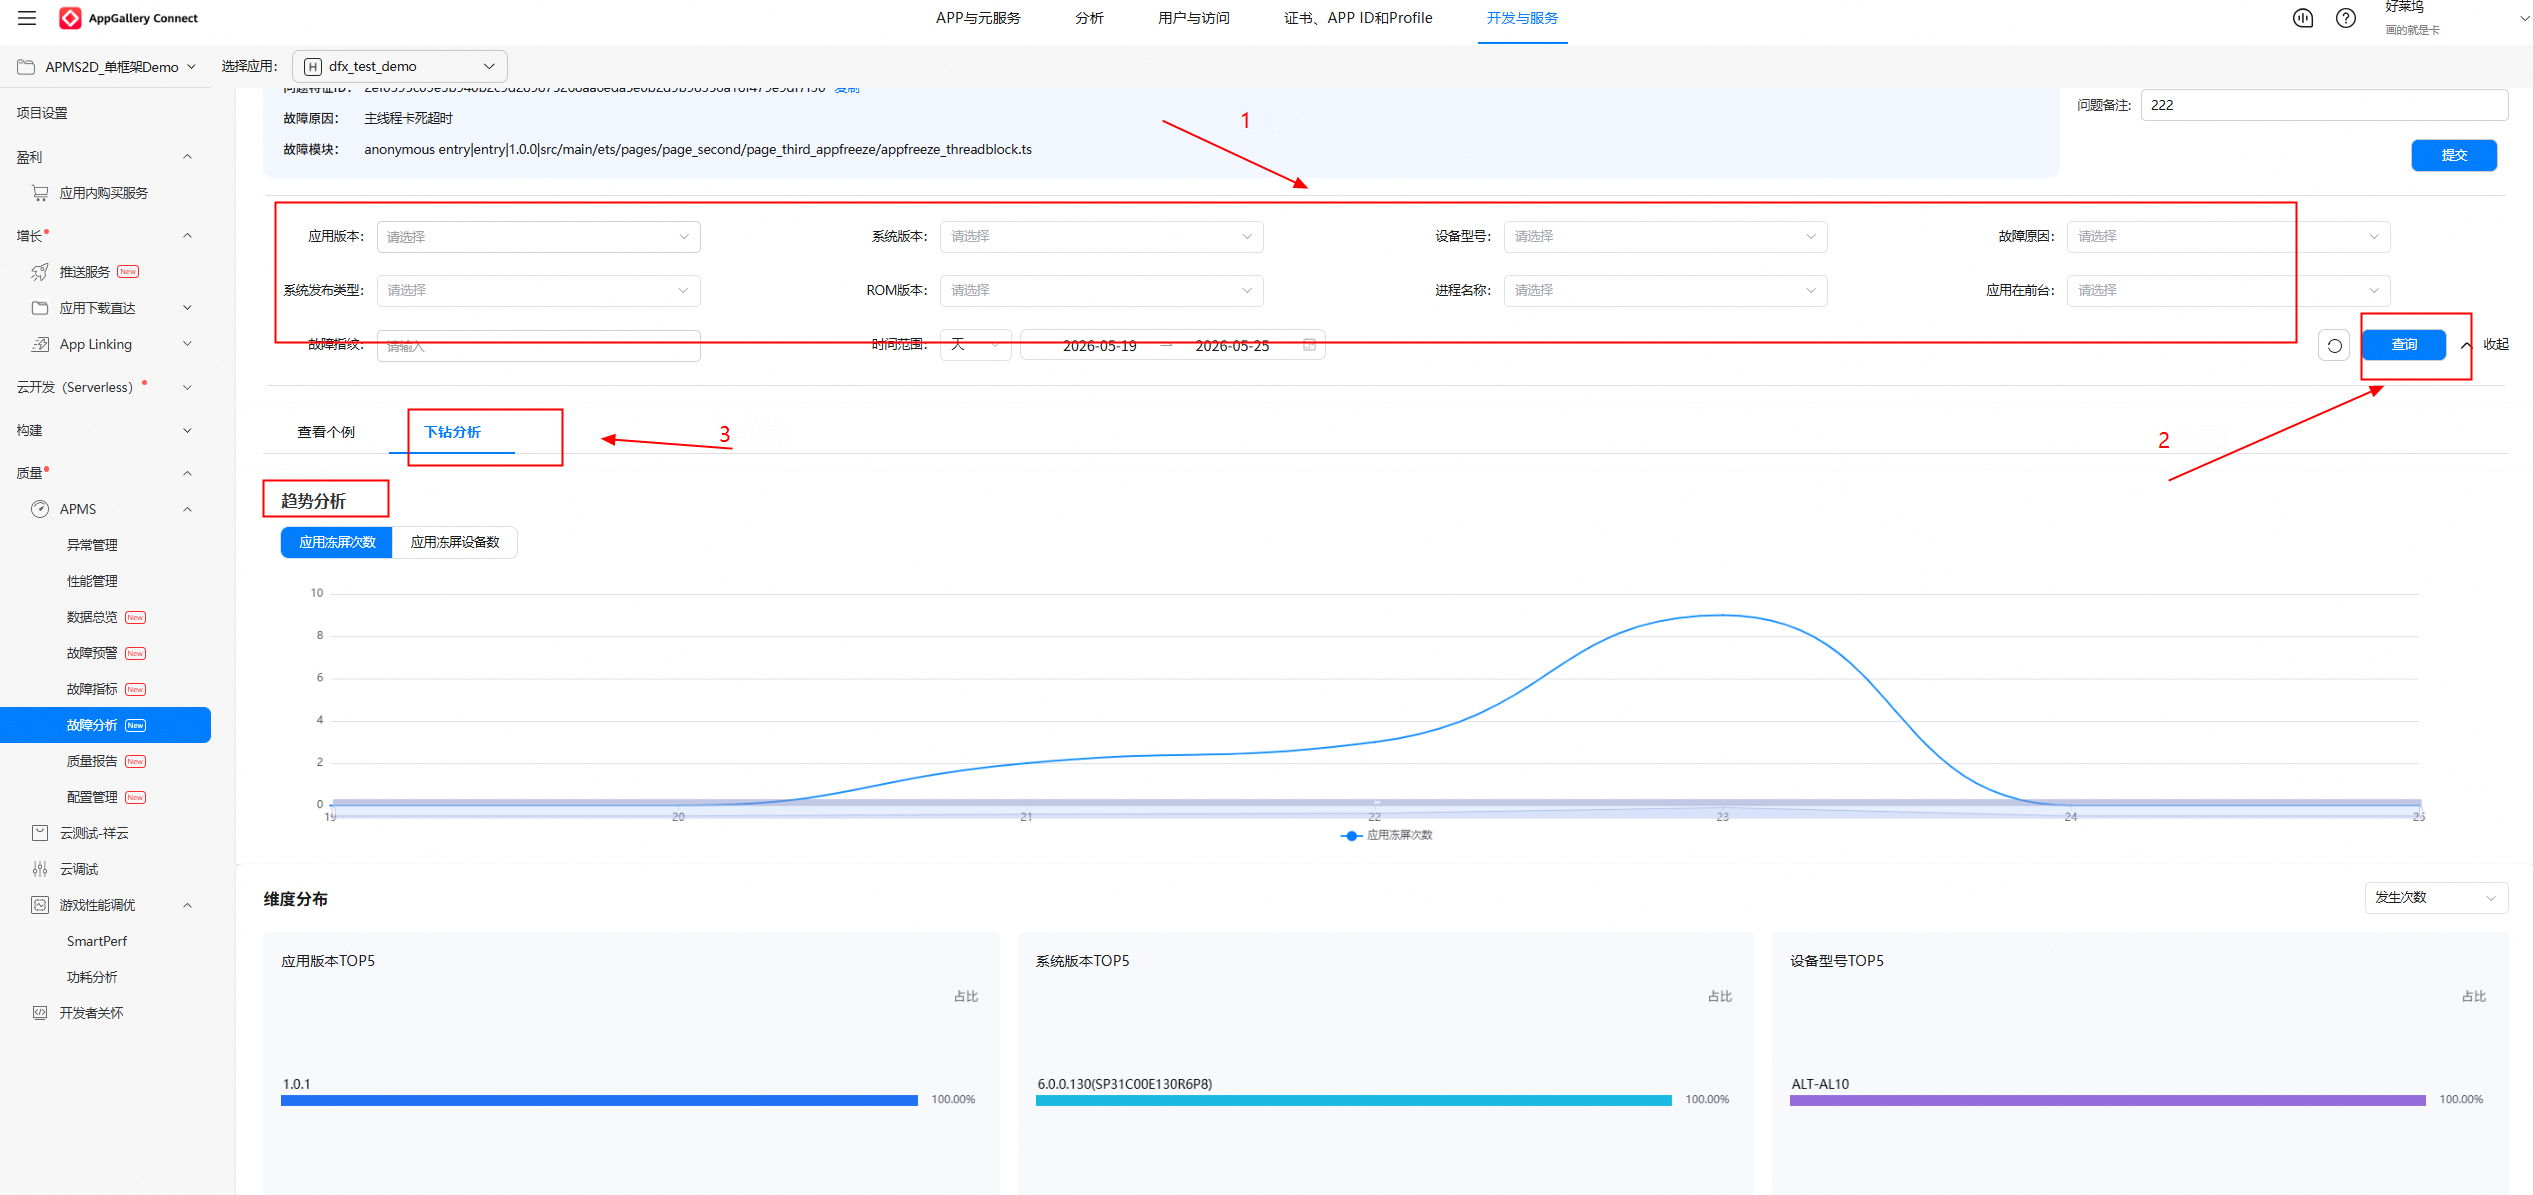
在问题详情页下钻分析可设置筛选条件查看冻屏在不同时间、不同版本、不同设备维度的发生频率。例如,某次版本更新后该类卡死量激增,可能提示新引入的问题。
(2)环境上下文
包括设备信息、系统版本、应用版本、ROM 版本、前后台状态等,帮助判断卡死发生的具体环境。
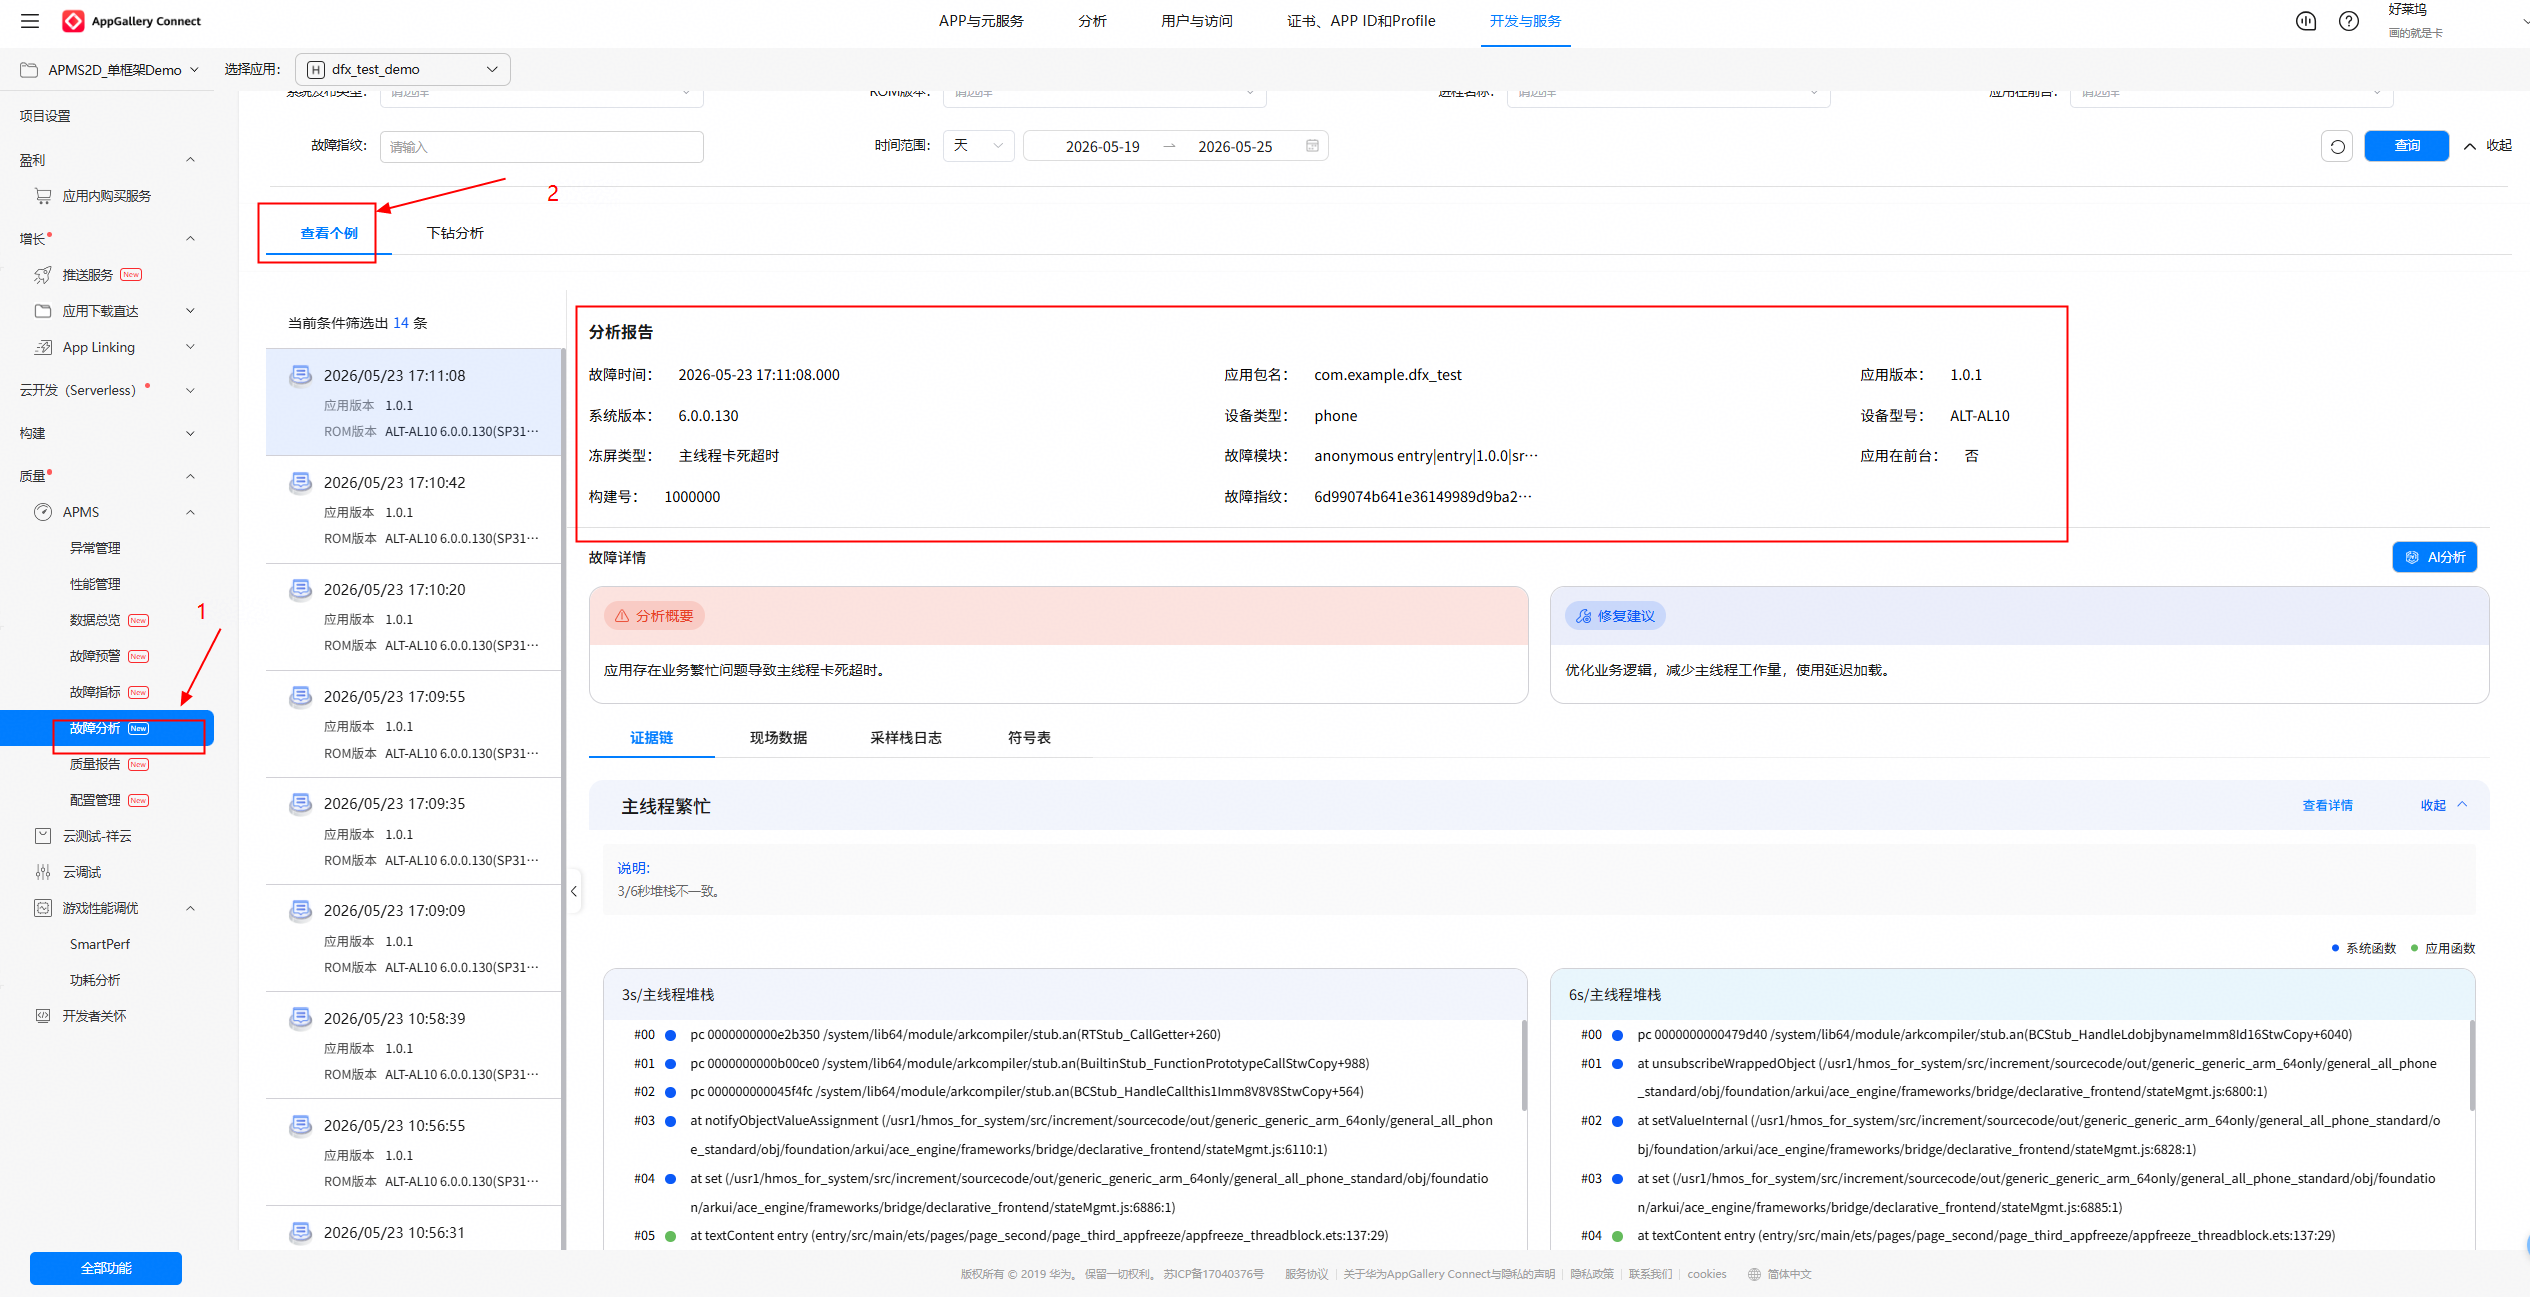
(3)证据链
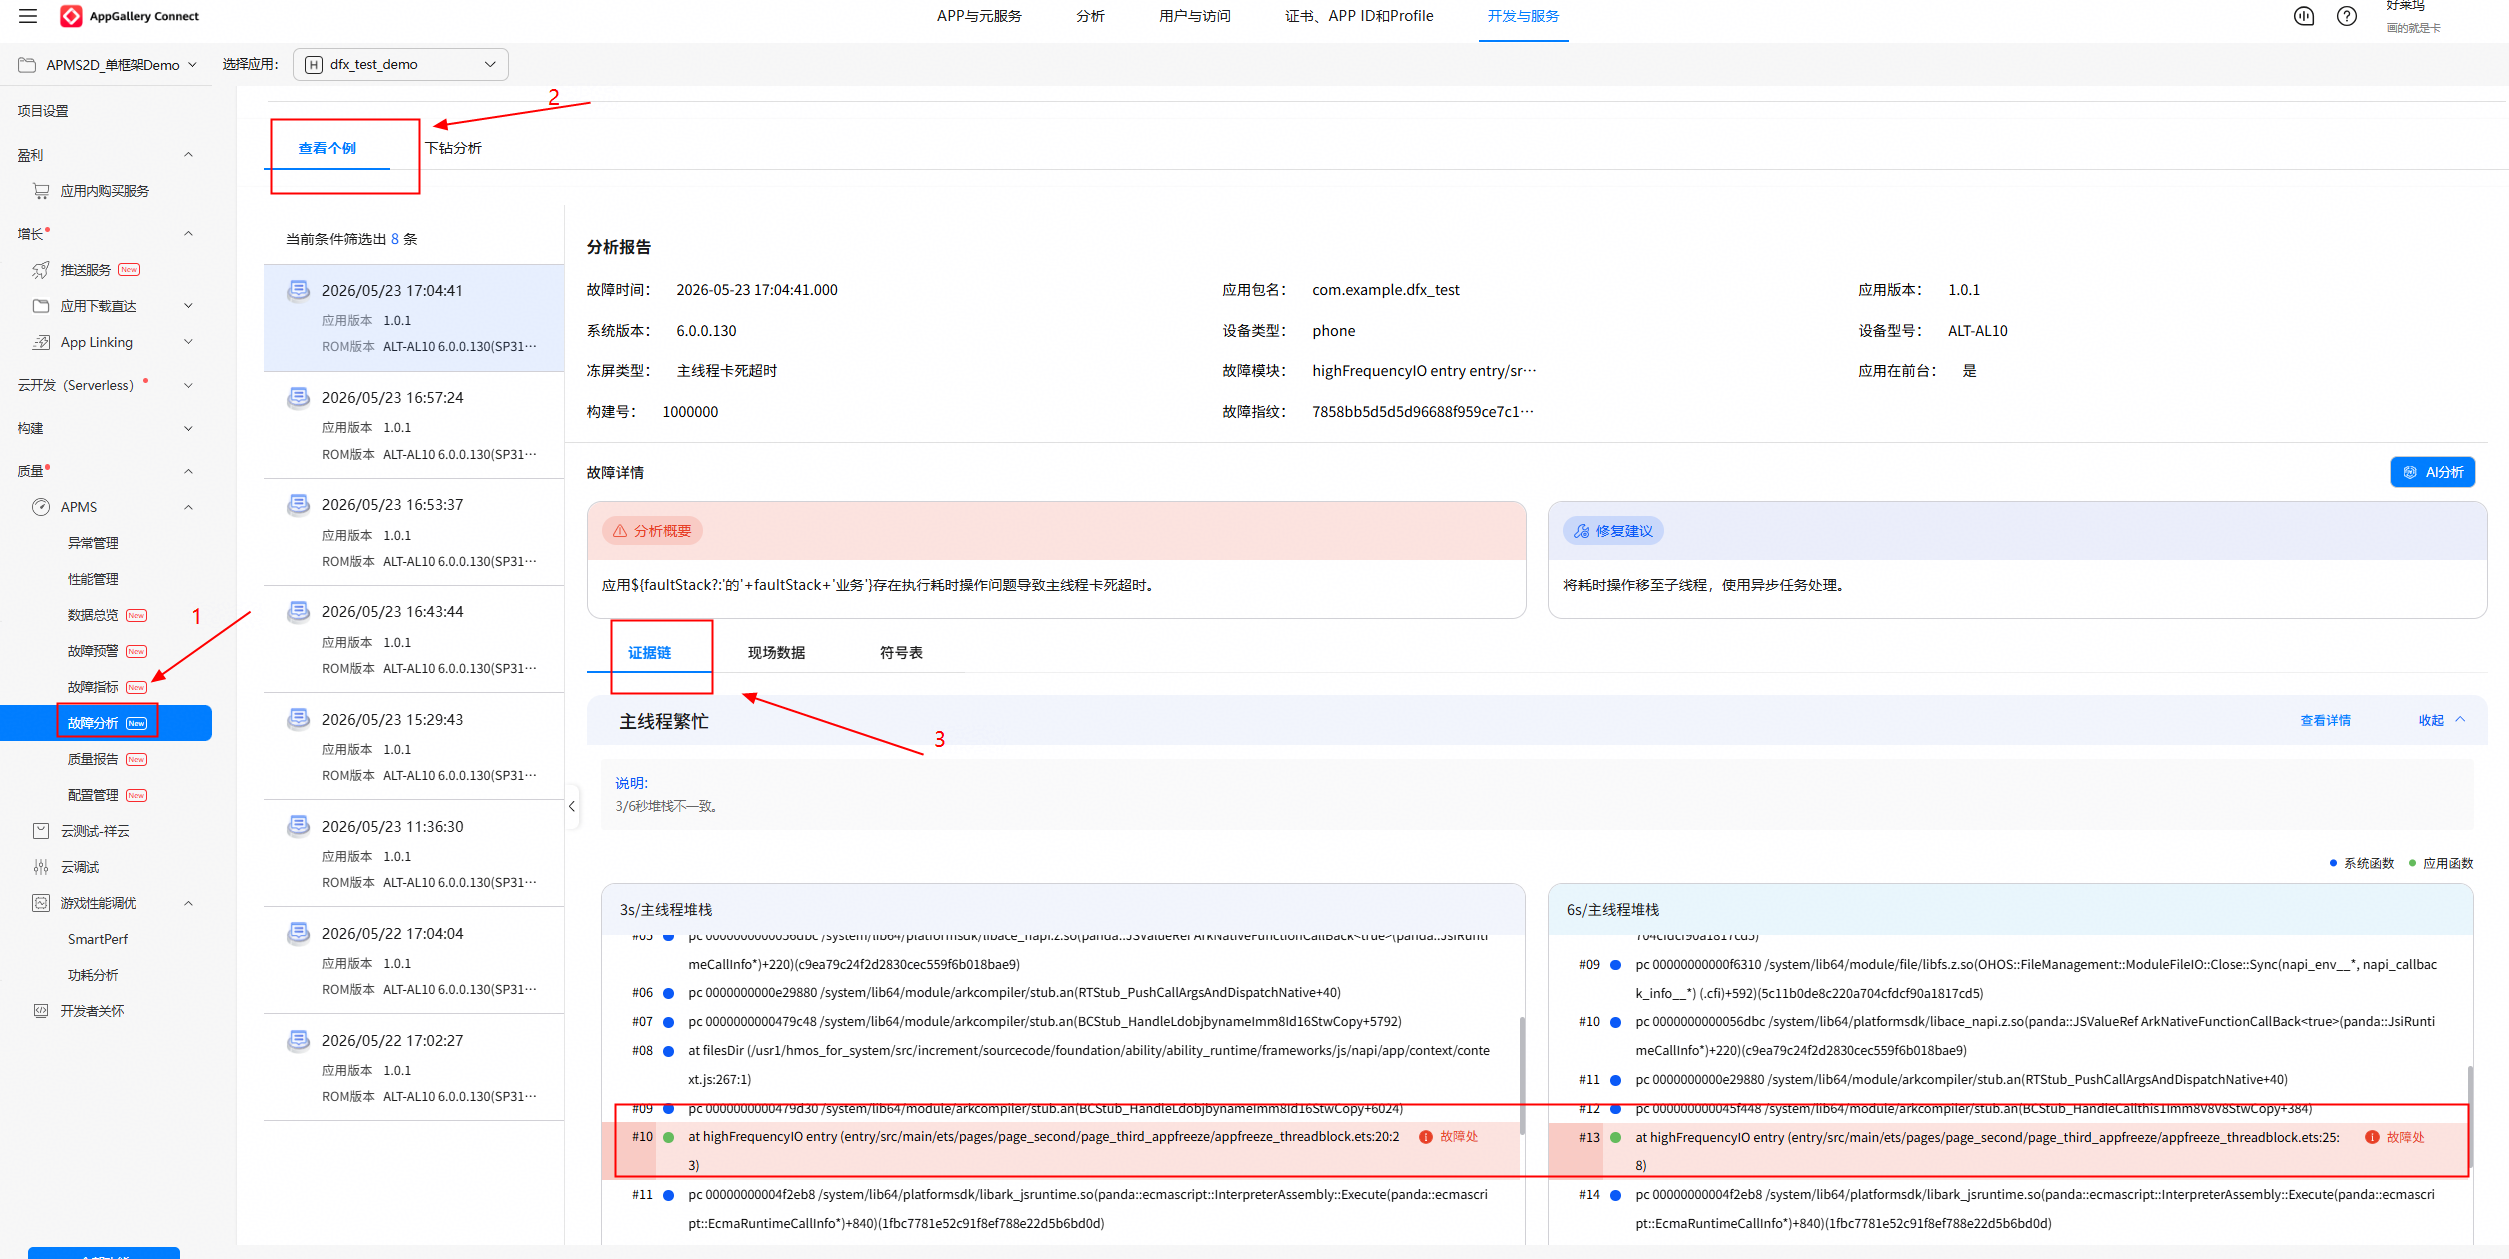
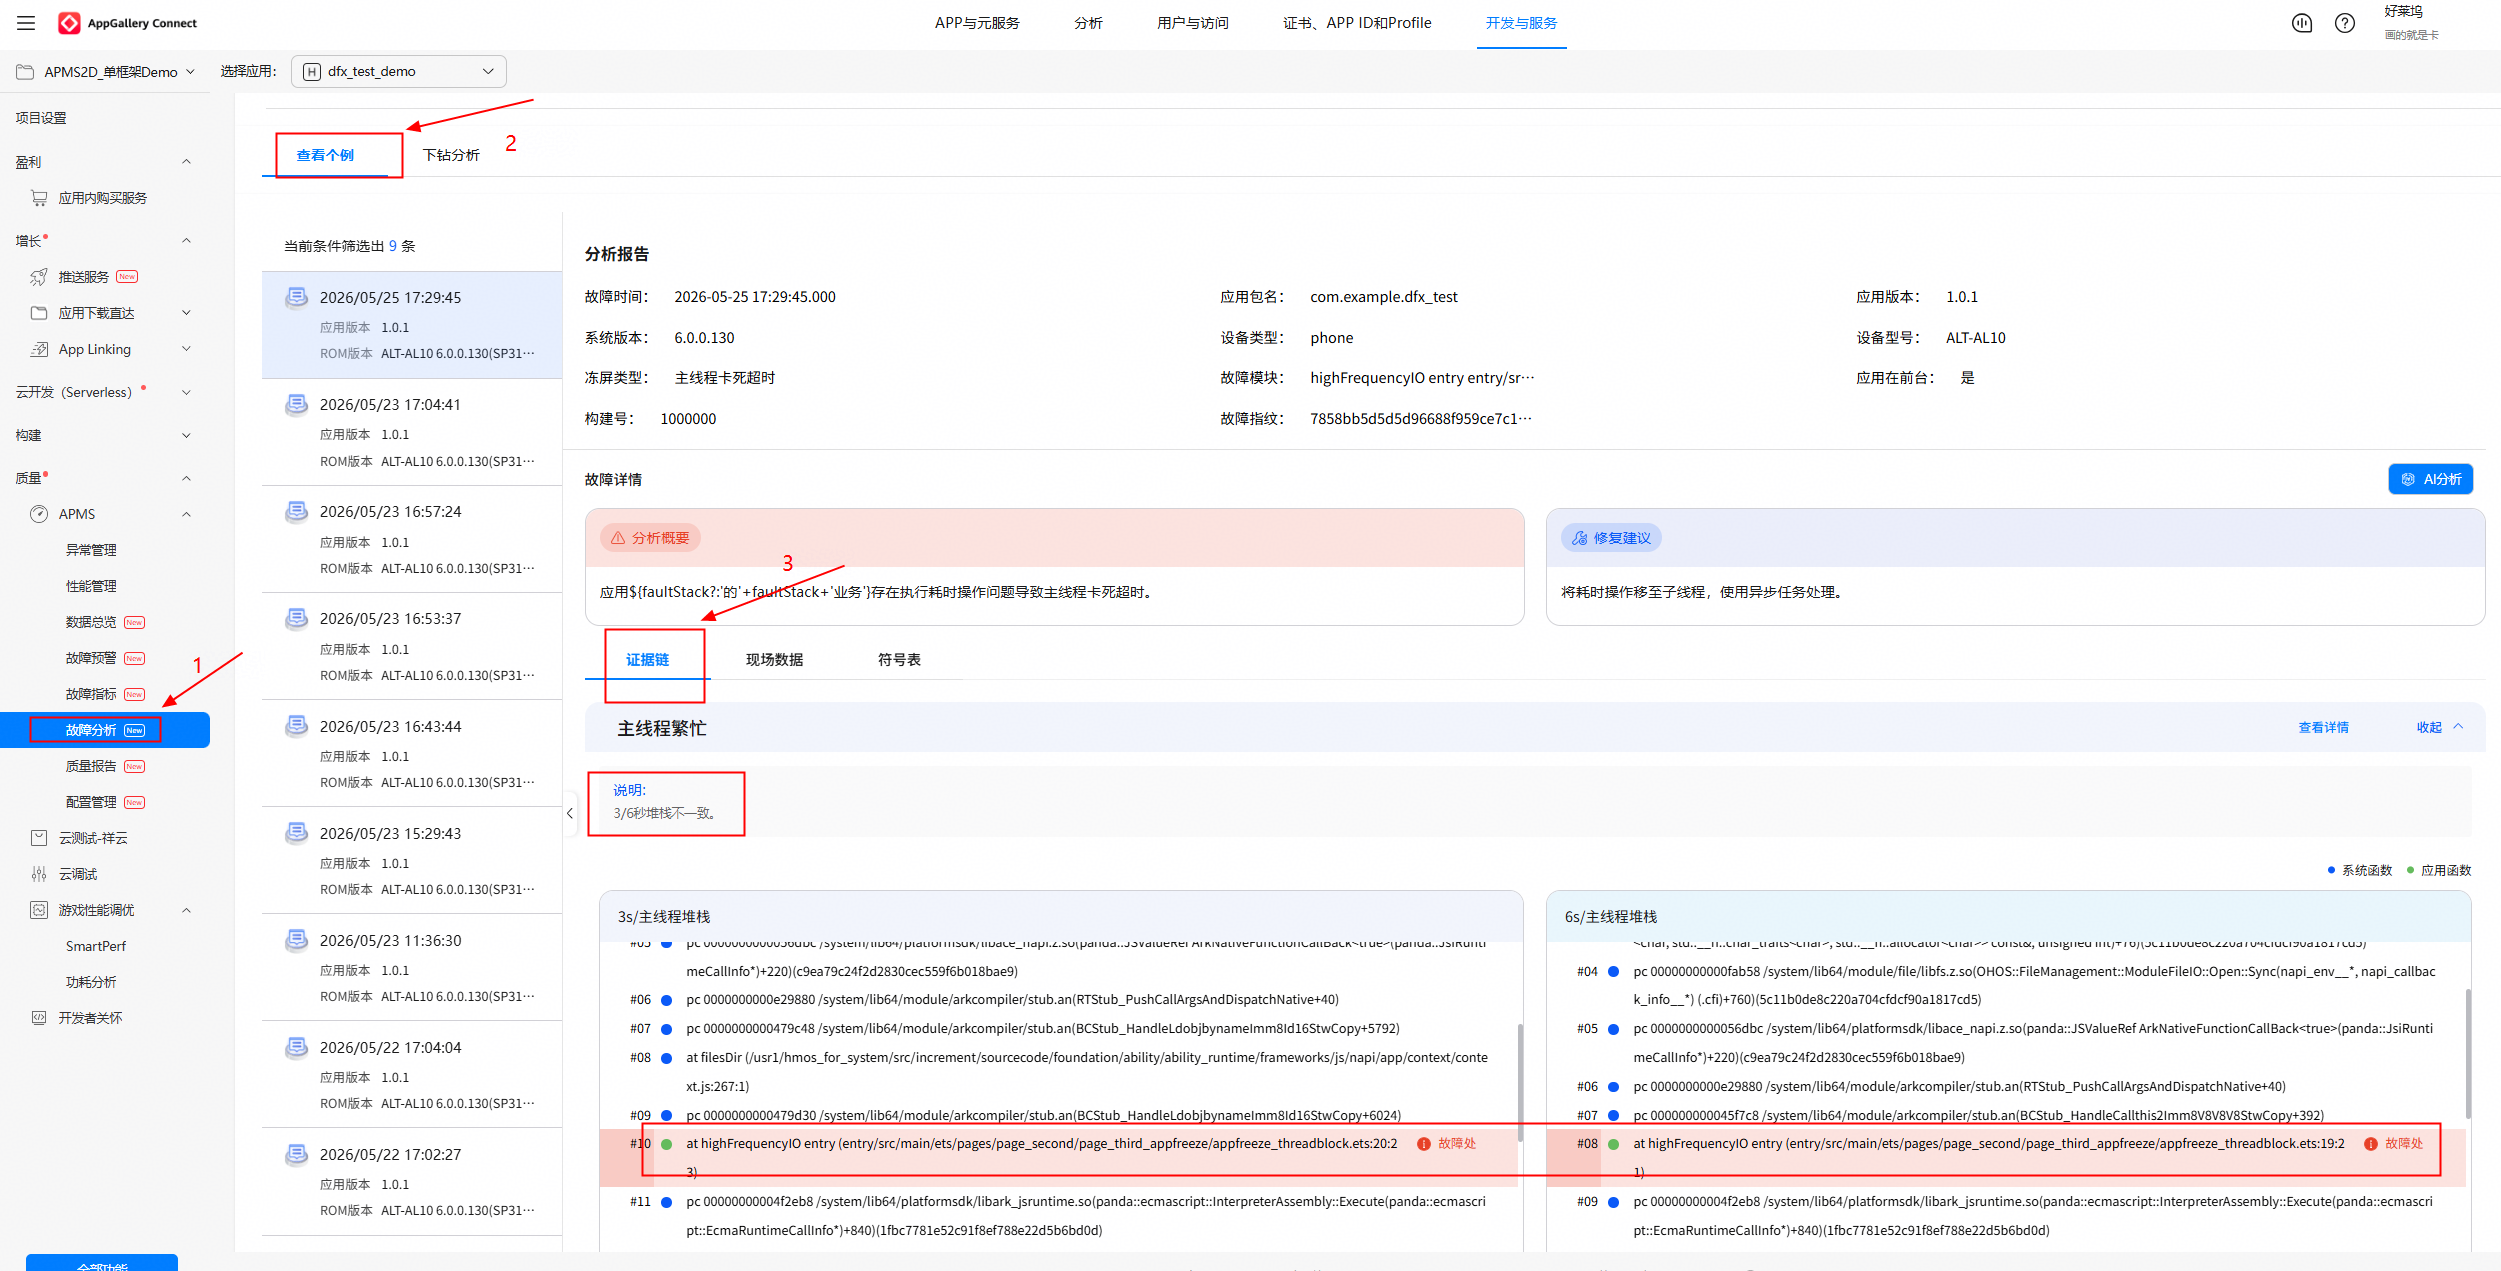
证据链可查看堆栈信息,问题堆栈会有红色高亮显示,可查看问题发生的业务代码位置。
1.2 APMS 平台应用冻屏问题分析案例
1.2.1 APMS 故障预警
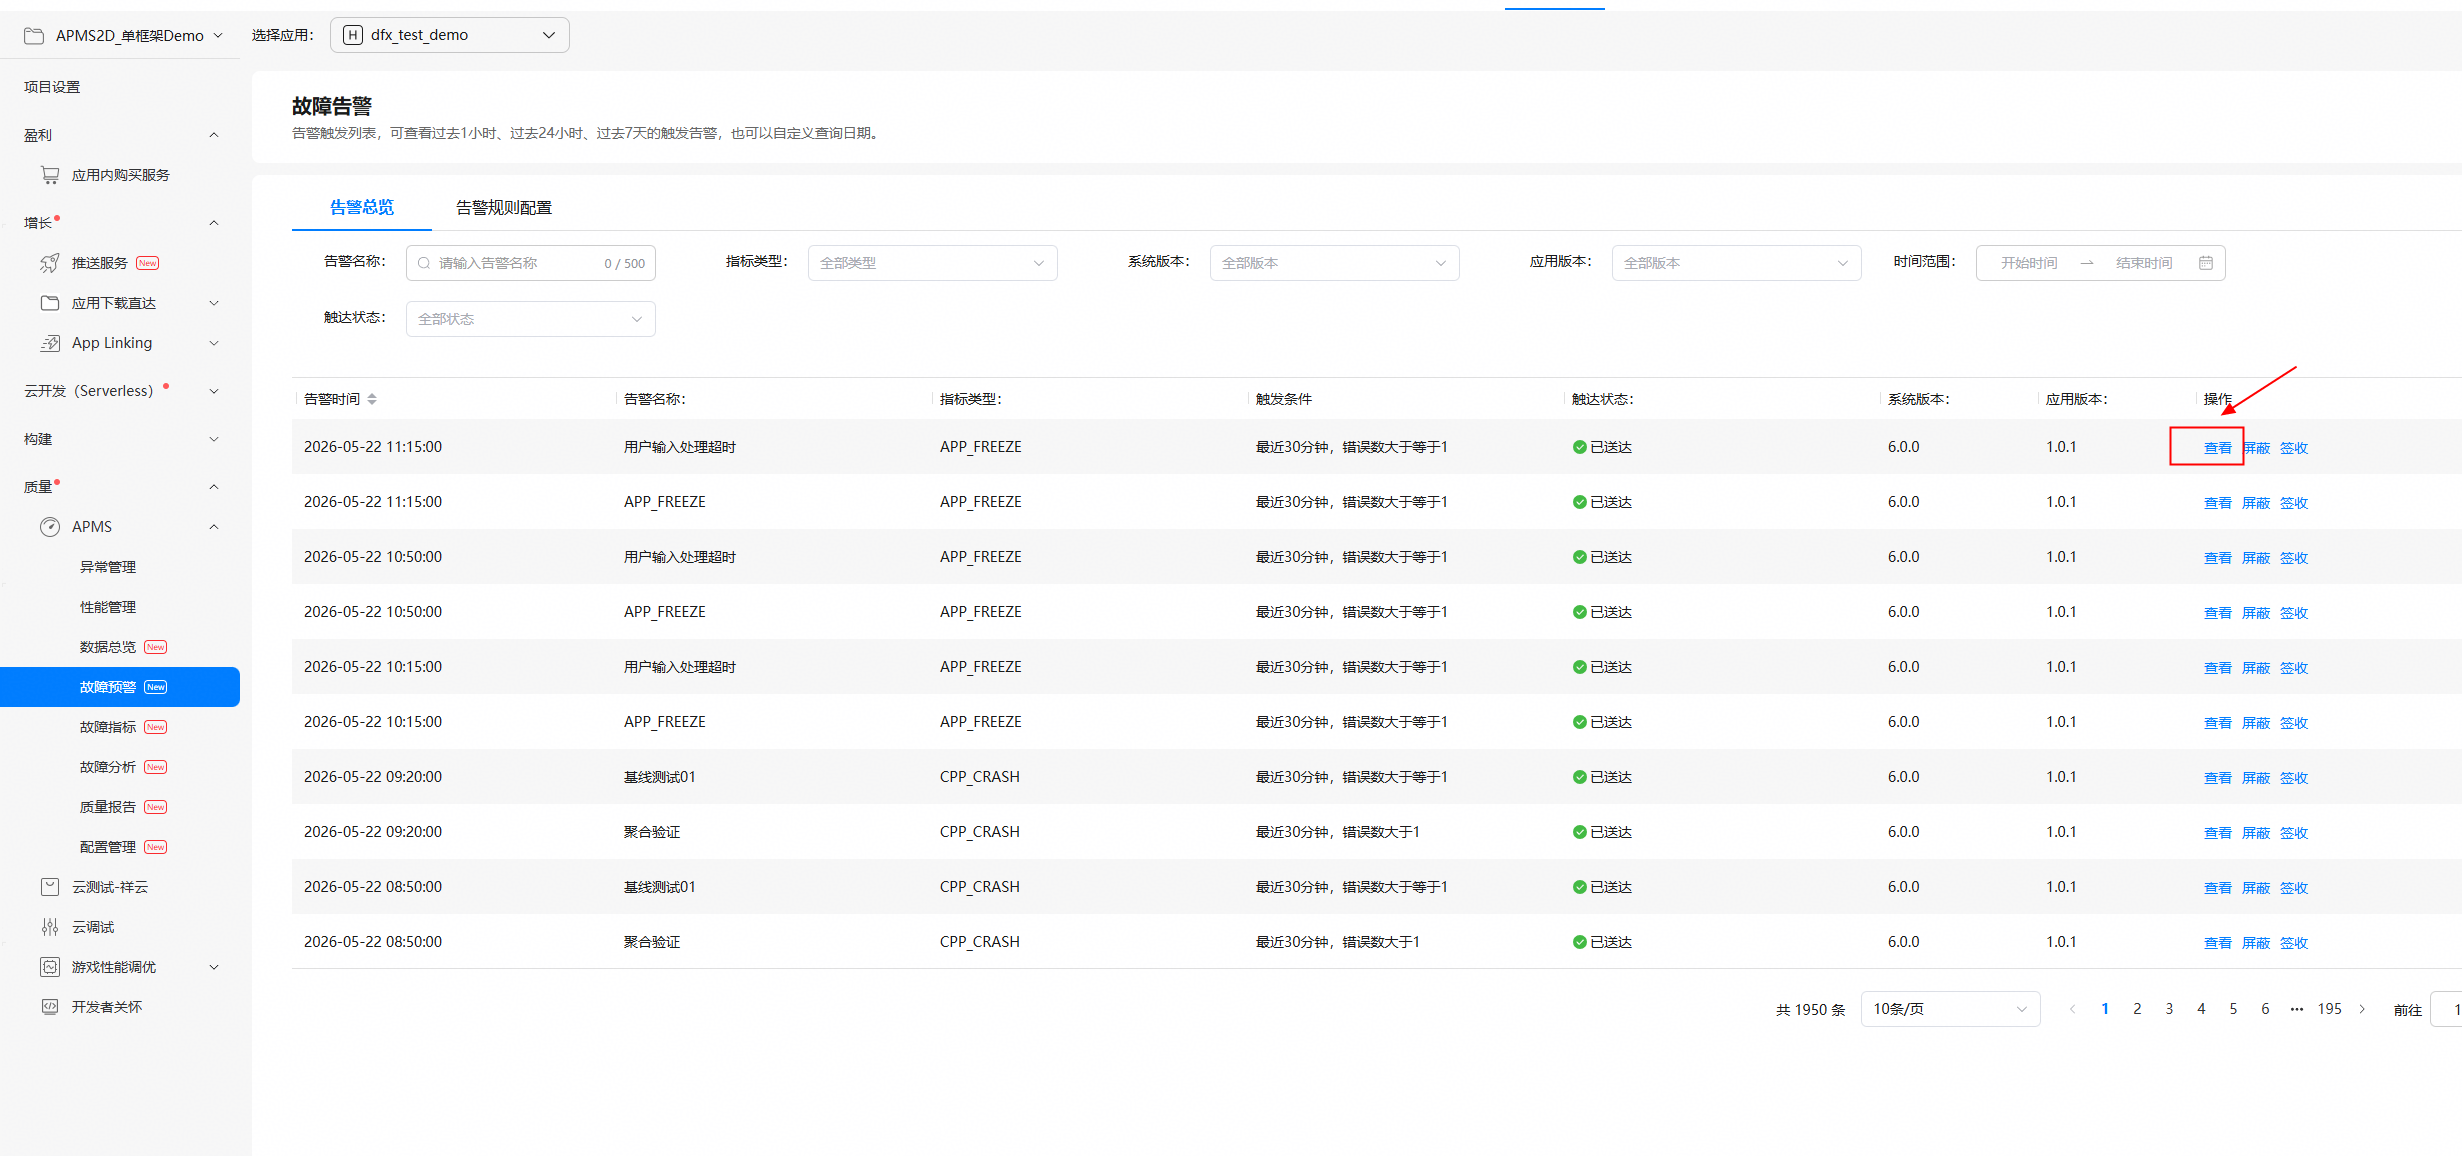
可以在故障预警平台的告警规则页面创建告警。根据实际的业务情况,选择合适监控时段,监控频率,告警触发条件等,应用冻屏的指标类型是属于 APP_FREEZE。
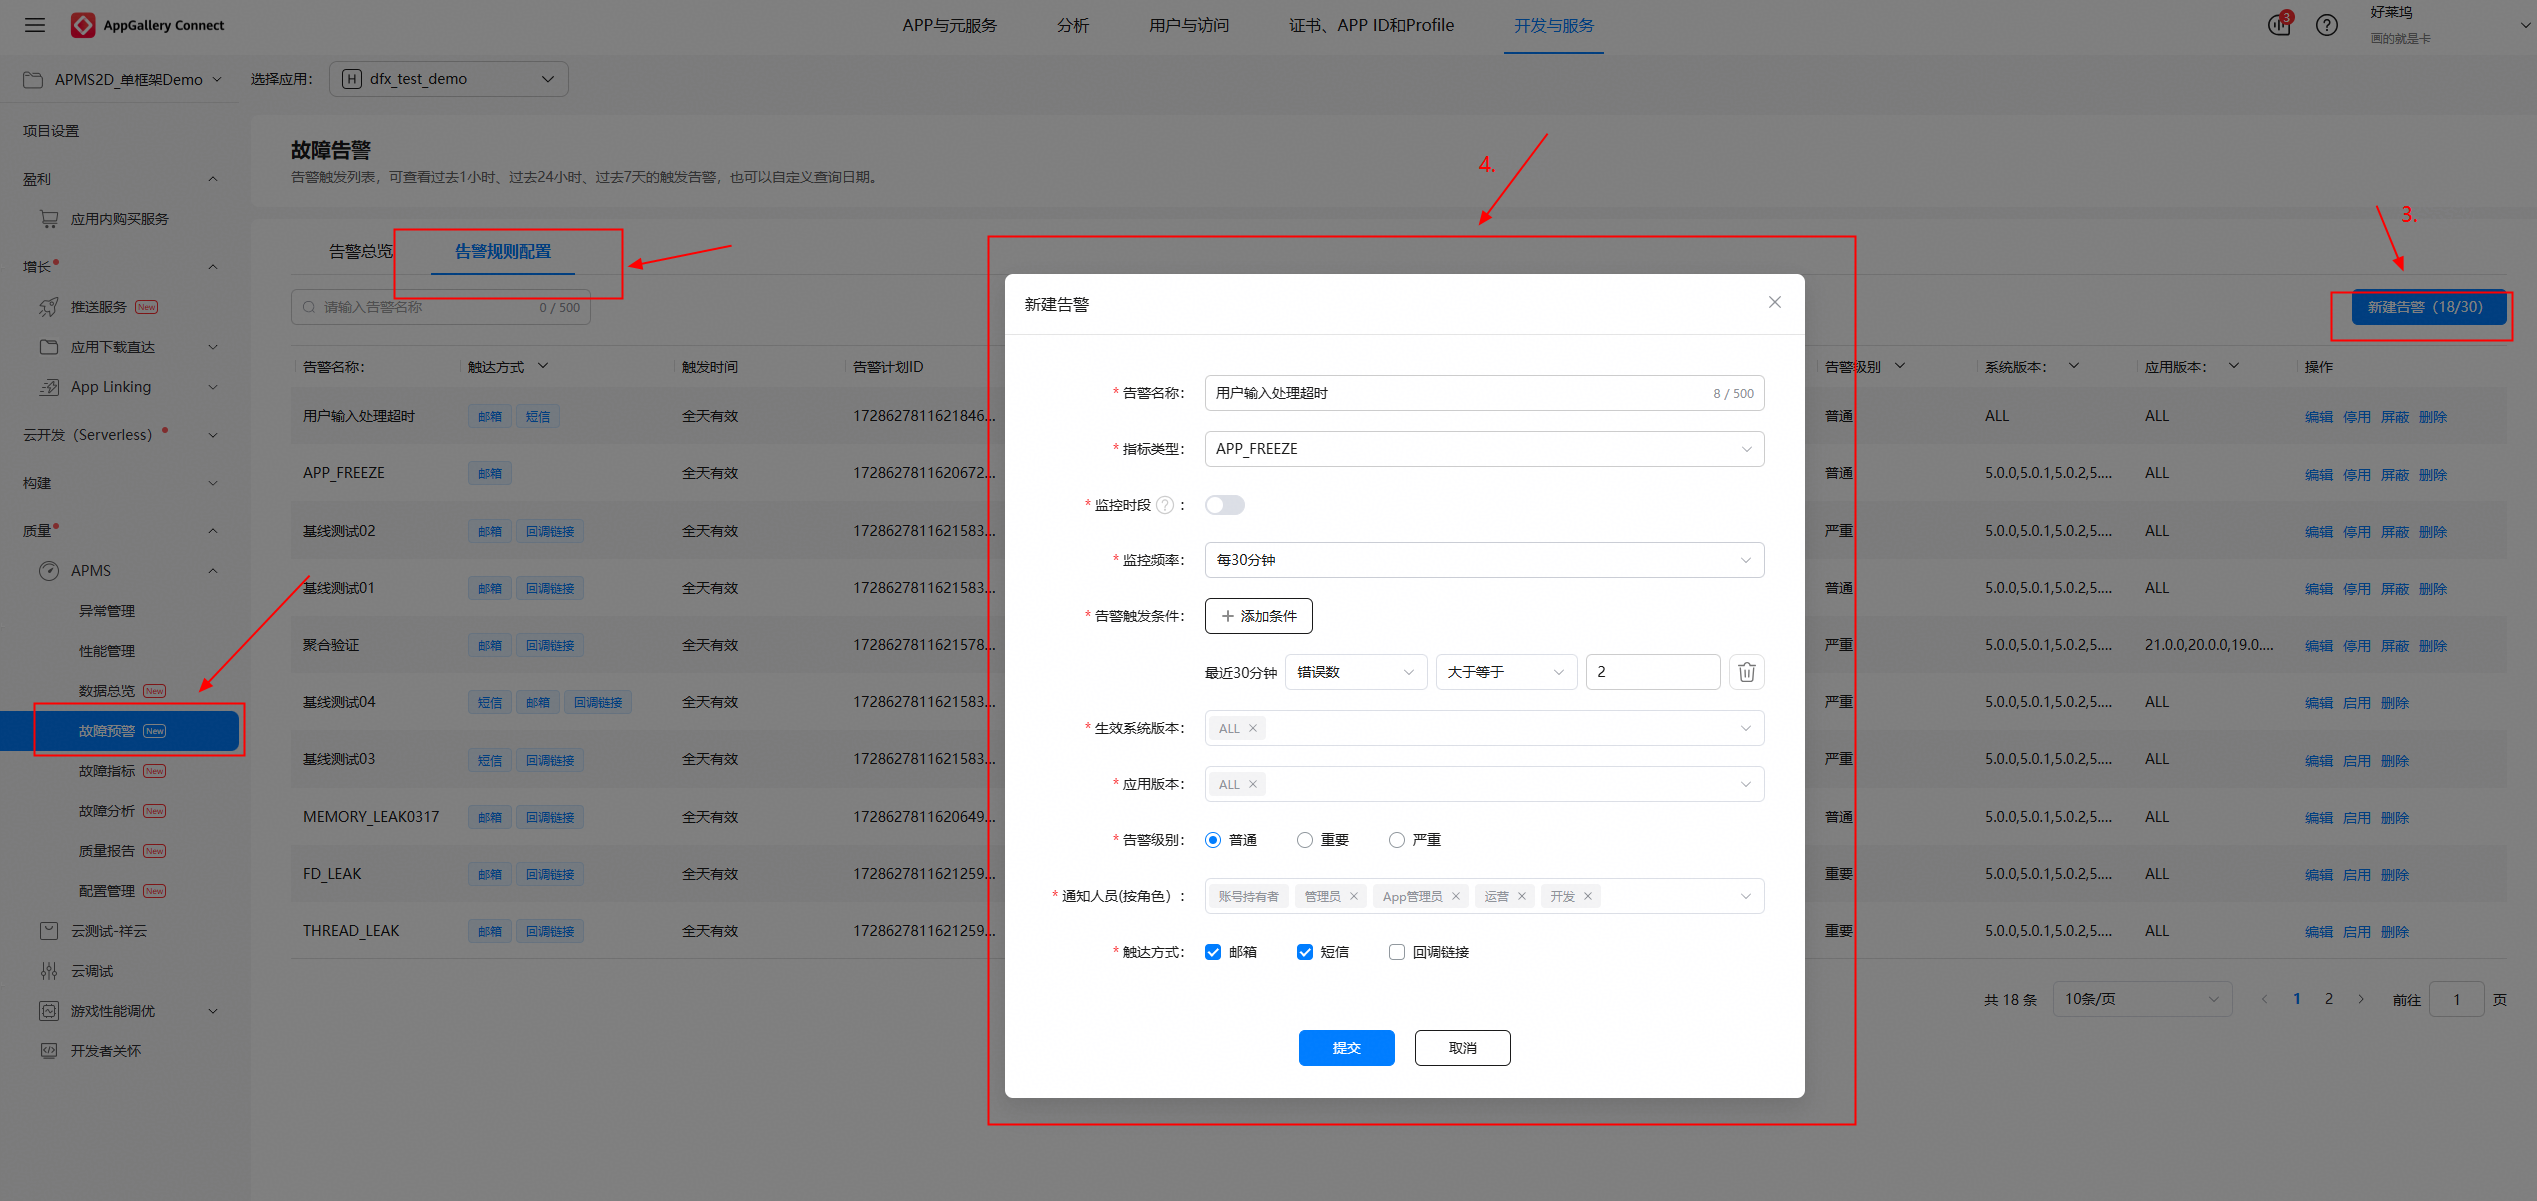
配置告警规则后,当应用触发冻屏事件,设备会进行上报故障信息。系统会开始收集后台数据,当满足告警触发条件后,会触发预警。
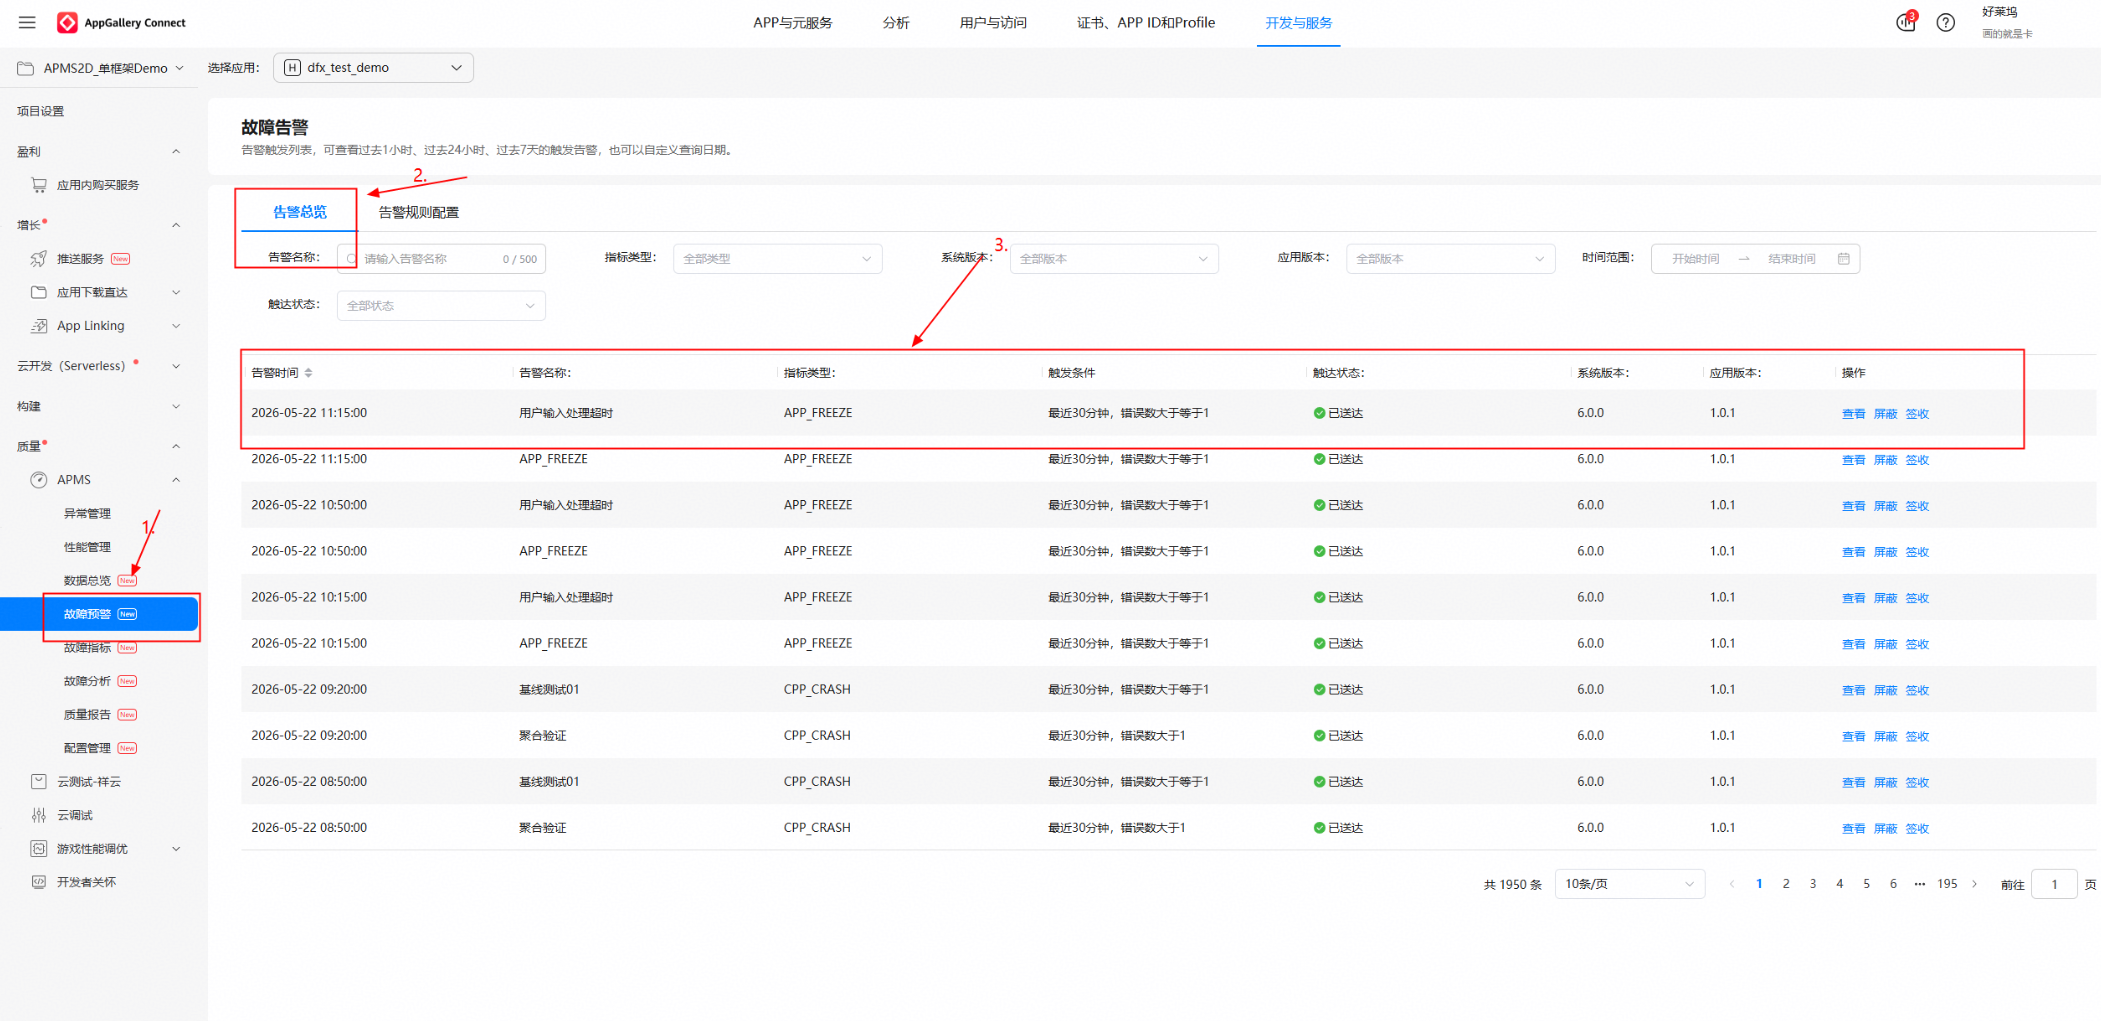
收到预警后,可以点击查看进入故障指标页面。
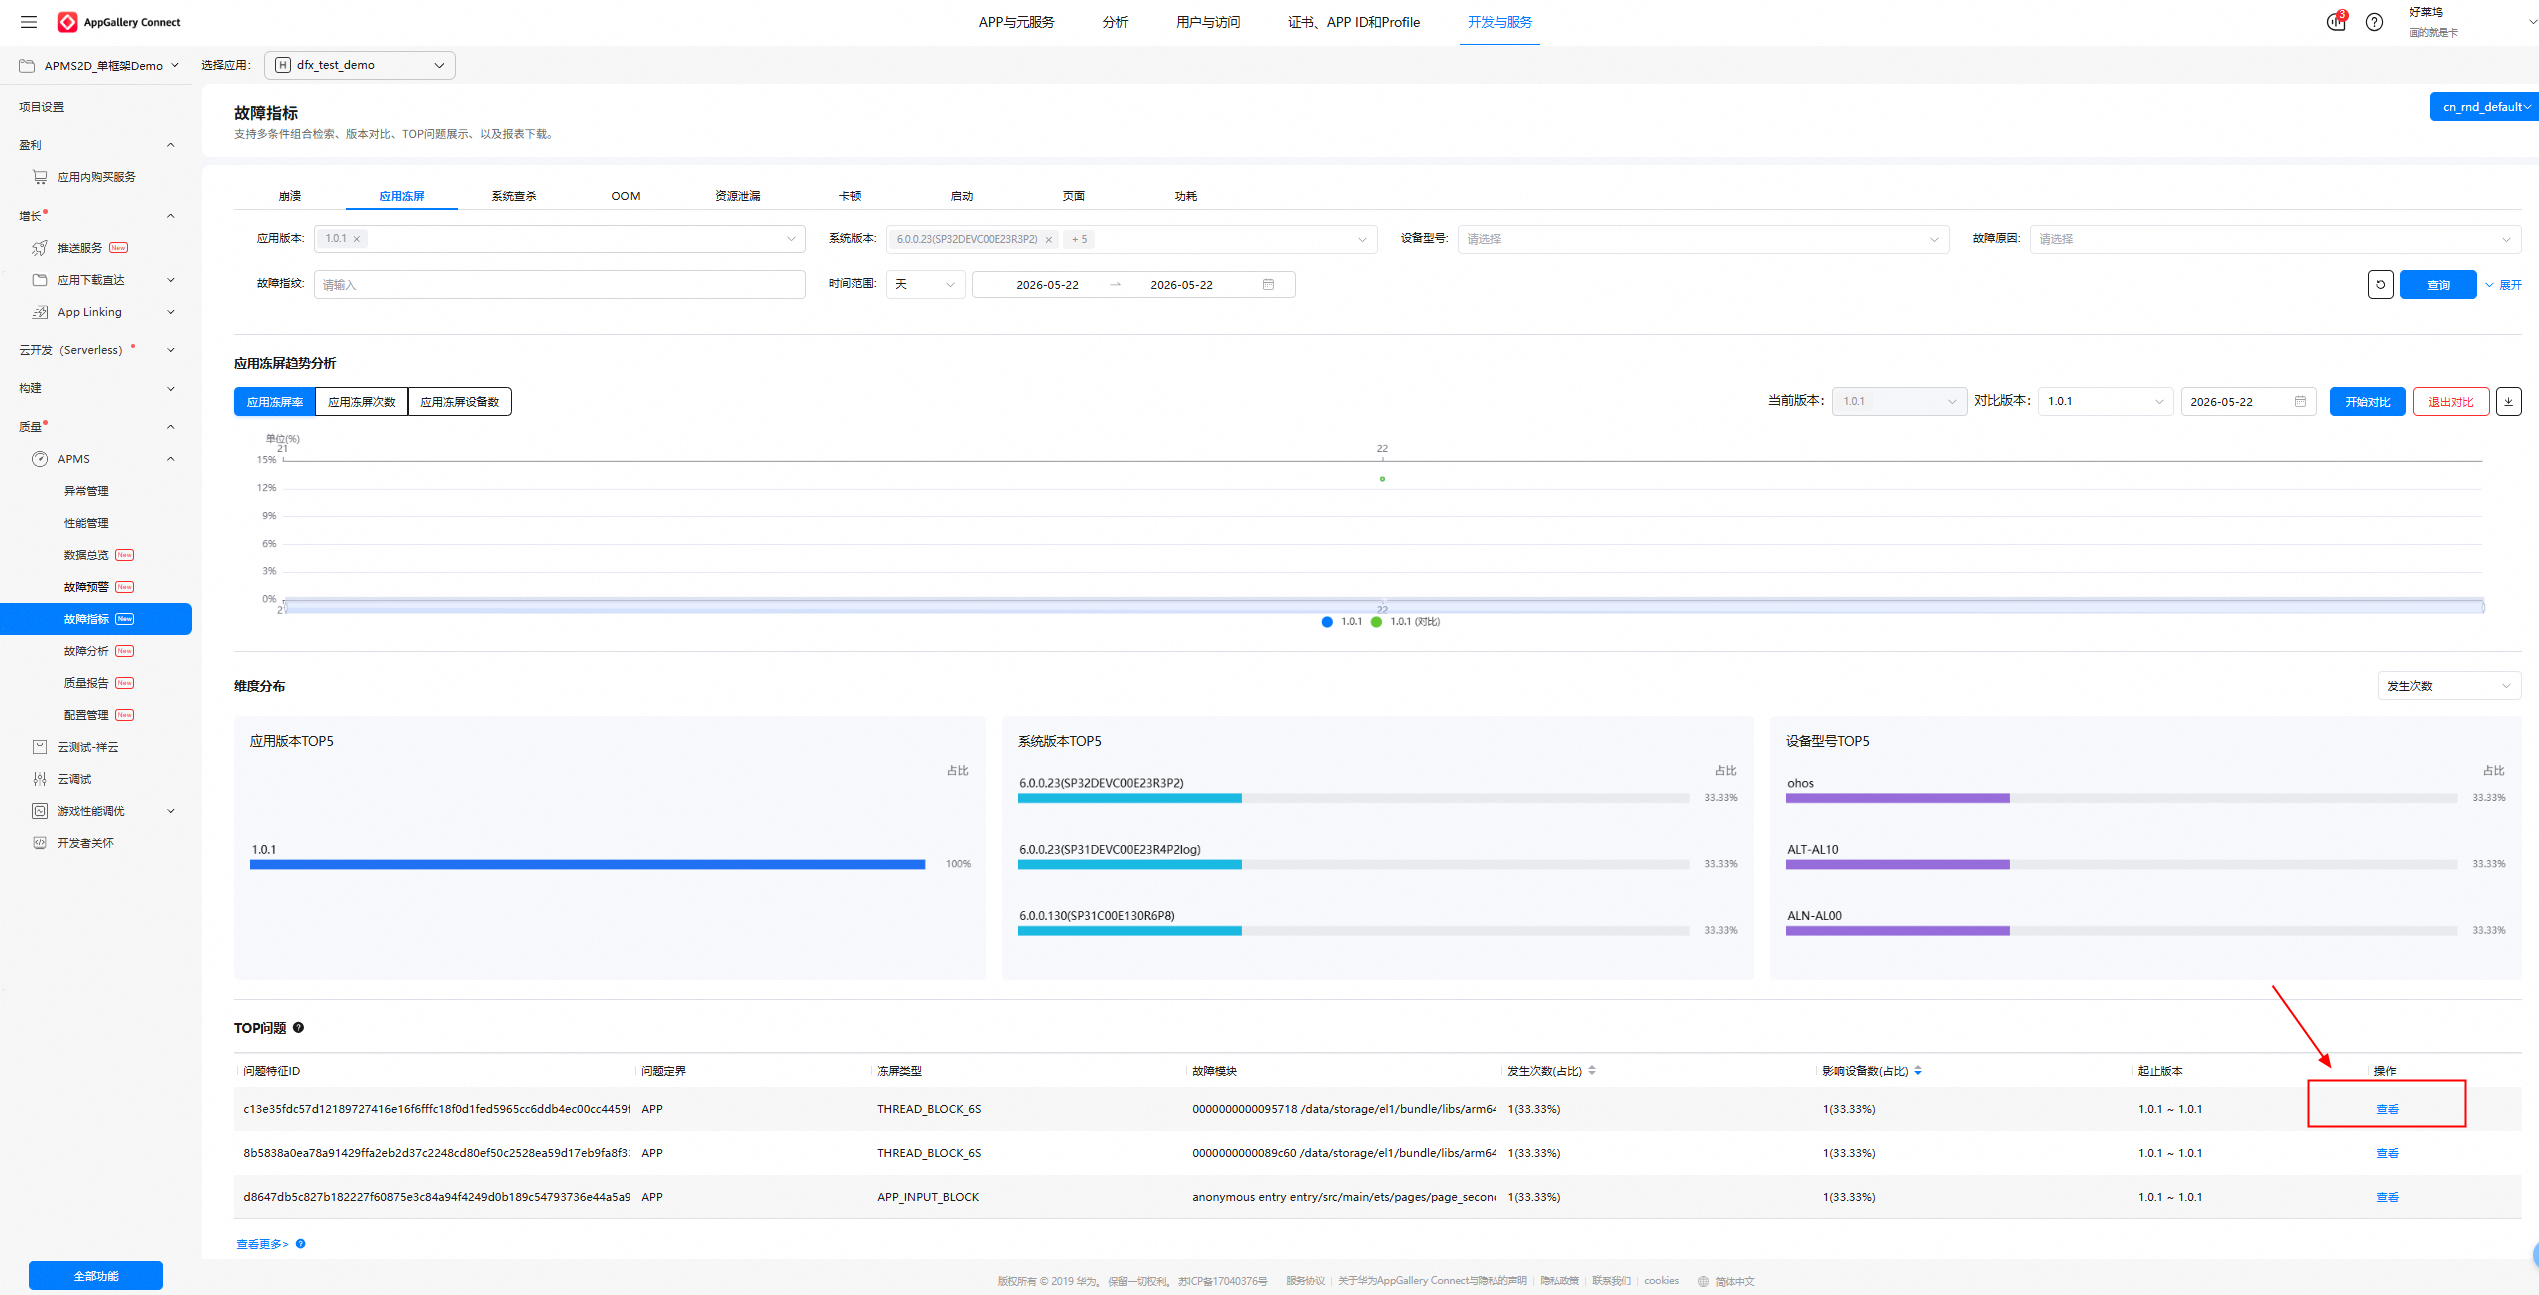
故障指标页面包含了趋势分析,维度分布和 Top 问题列表。开发者可以在界面可以设置不同的筛选条件对冻屏问题进行个性化分析。点击 top 问题列表中的查看,可以进入问题详情页查看问题详情近一步分析。
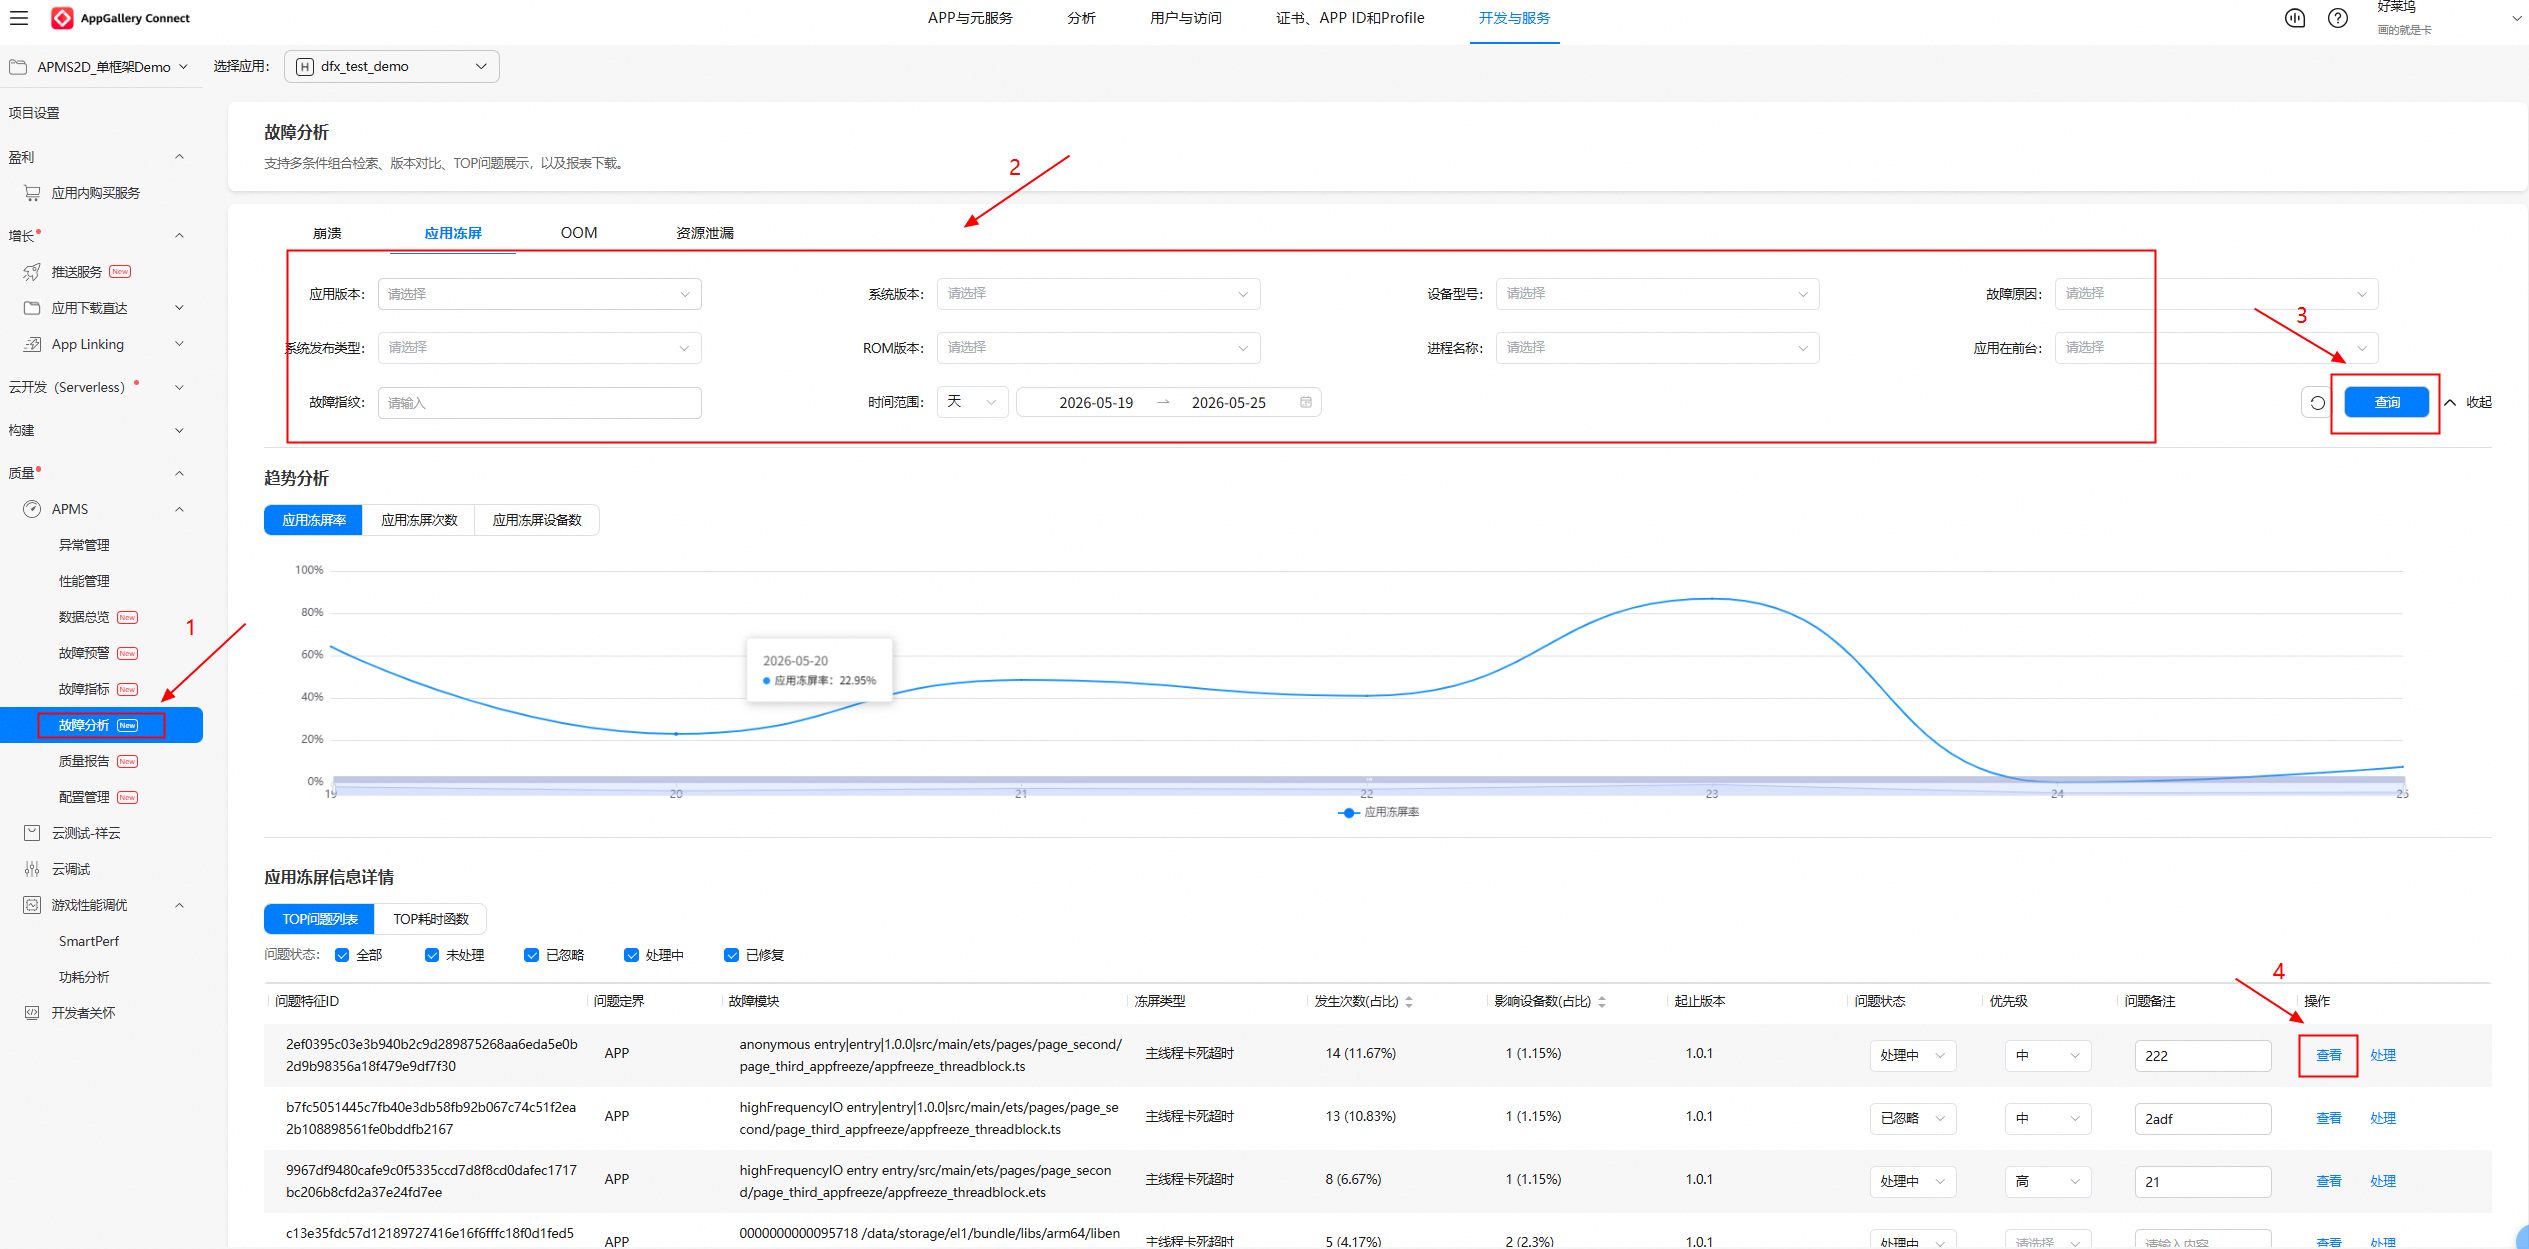
开发者也可以直接点击故障分析页面,经过条件筛选后可查看具体的 Top 问题列表,点击查看可进入问题详情页近一步分析。
1.2.2 问题查看与聚类
1.2.2.1 聚类规则说明
平台根据以下规则进行问题聚类:
相同特征 ID:将具有相同问题特征 ID 的问题聚合在一起
相同函数名:同一函数发生的冻屏问题会被聚合在一起
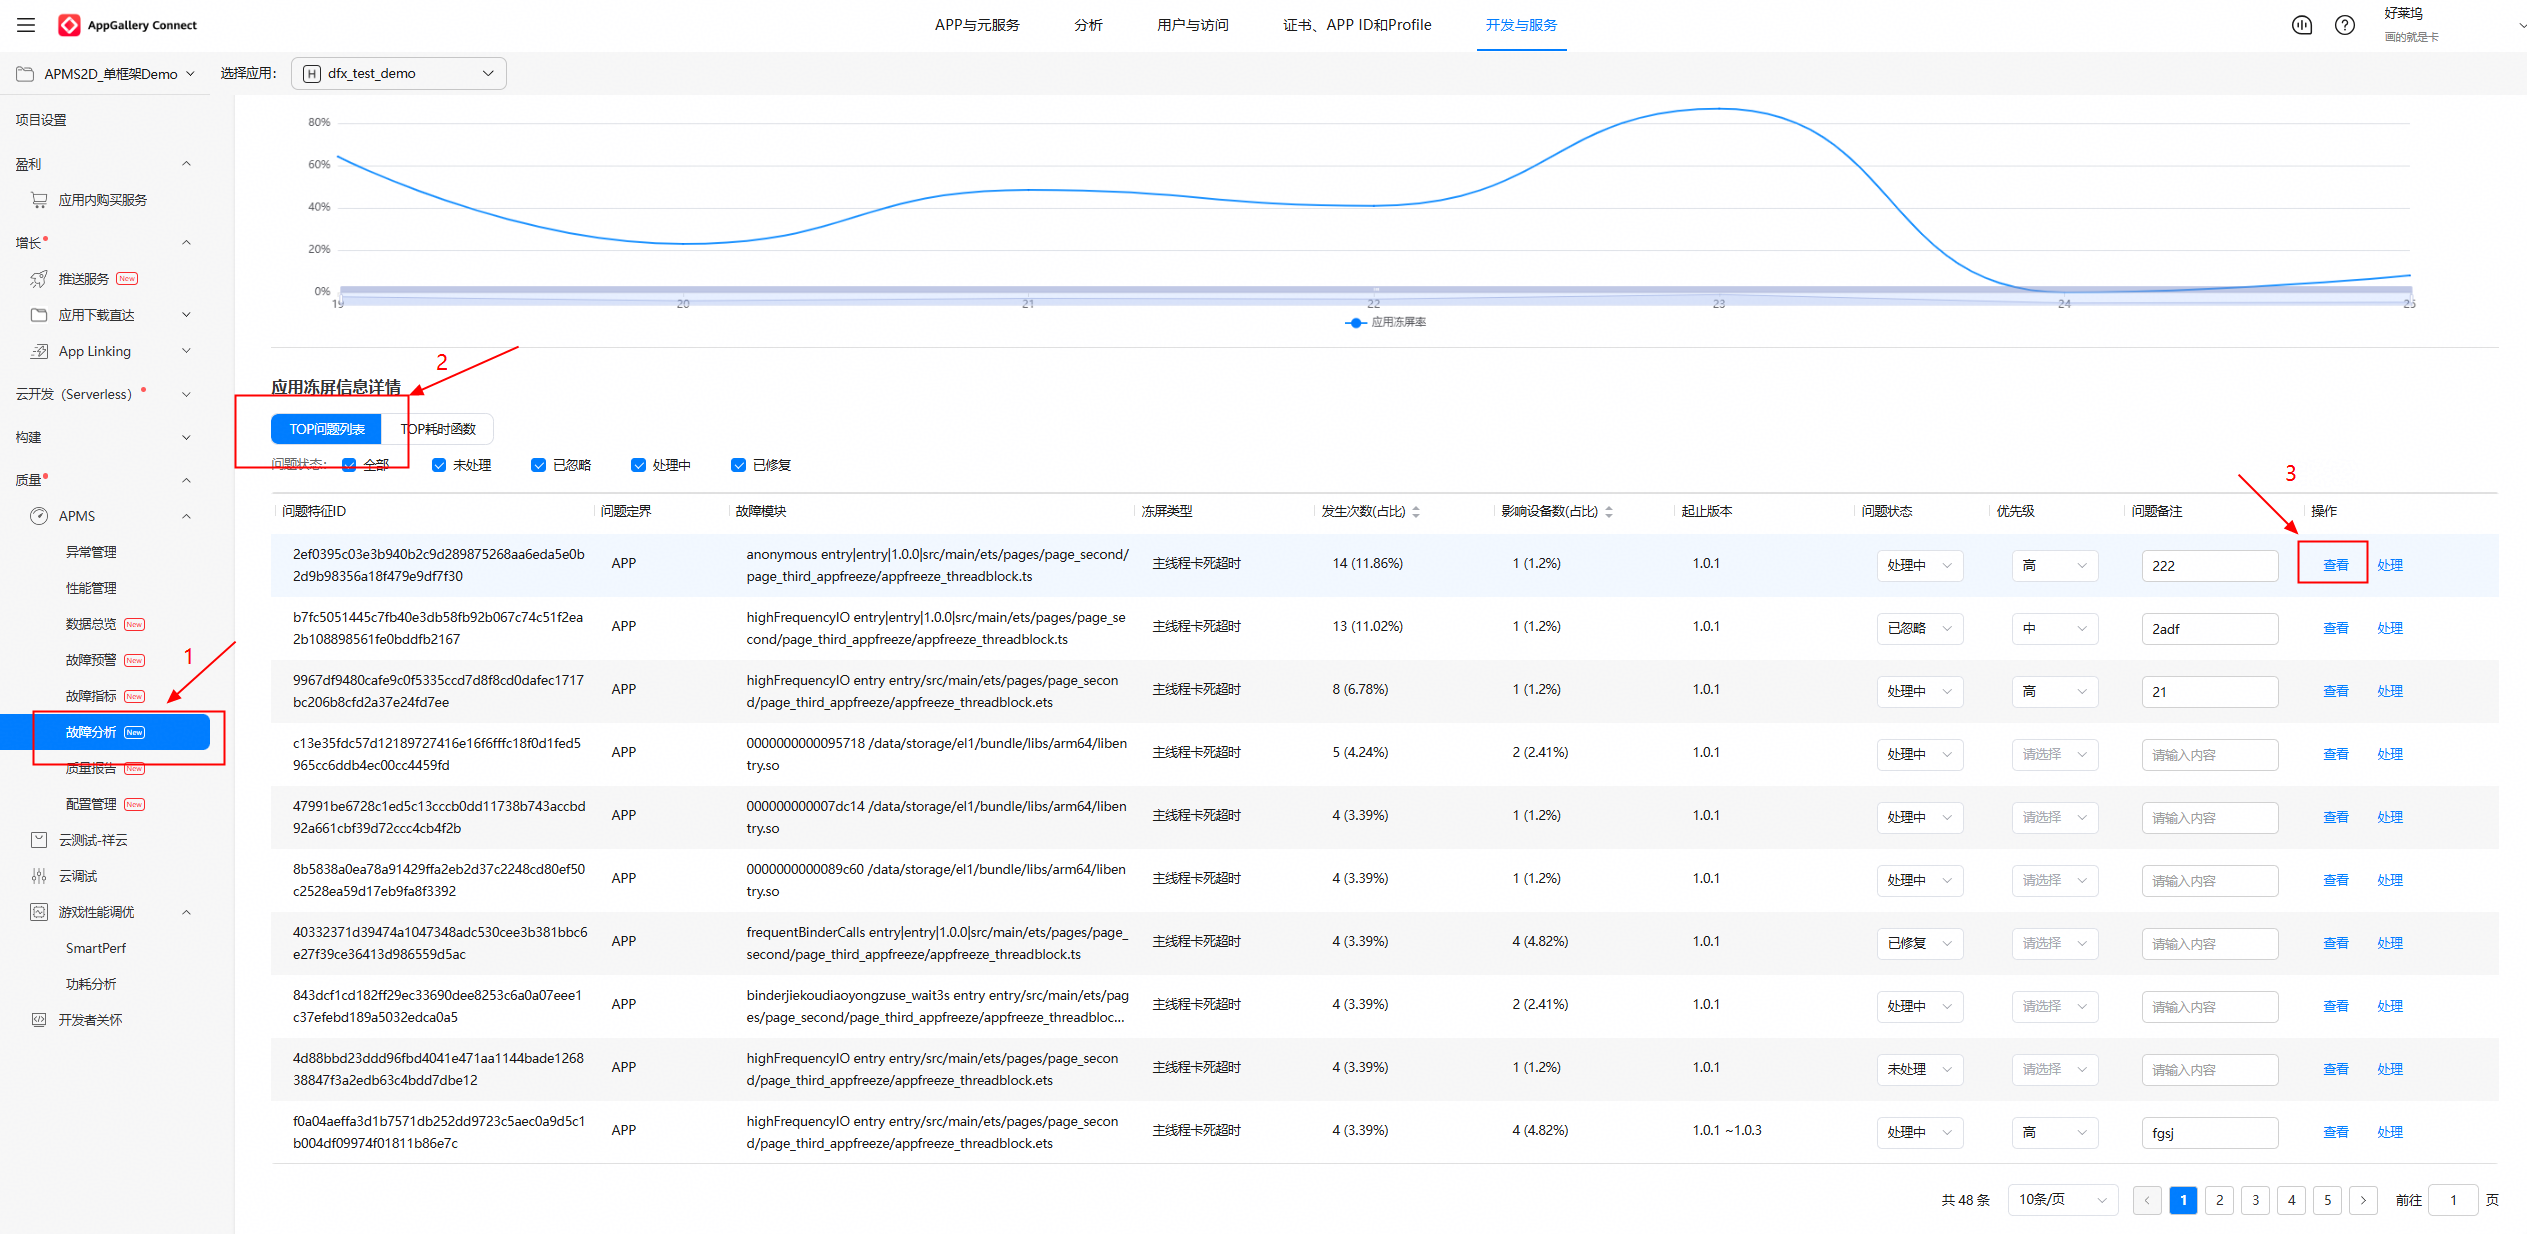
1.2.2.2 TOP 问题查看
进入故障分析界面
筛选卡死问题范围:在界面可以设置不同的筛选条件对卡死问题进行个性化分析。筛选条件设置完成后点击“查询”,即可查看指定时间范围和条件下的三类指标数据的变化趋势,包括冻屏率、冻屏次数、冻屏设备数。
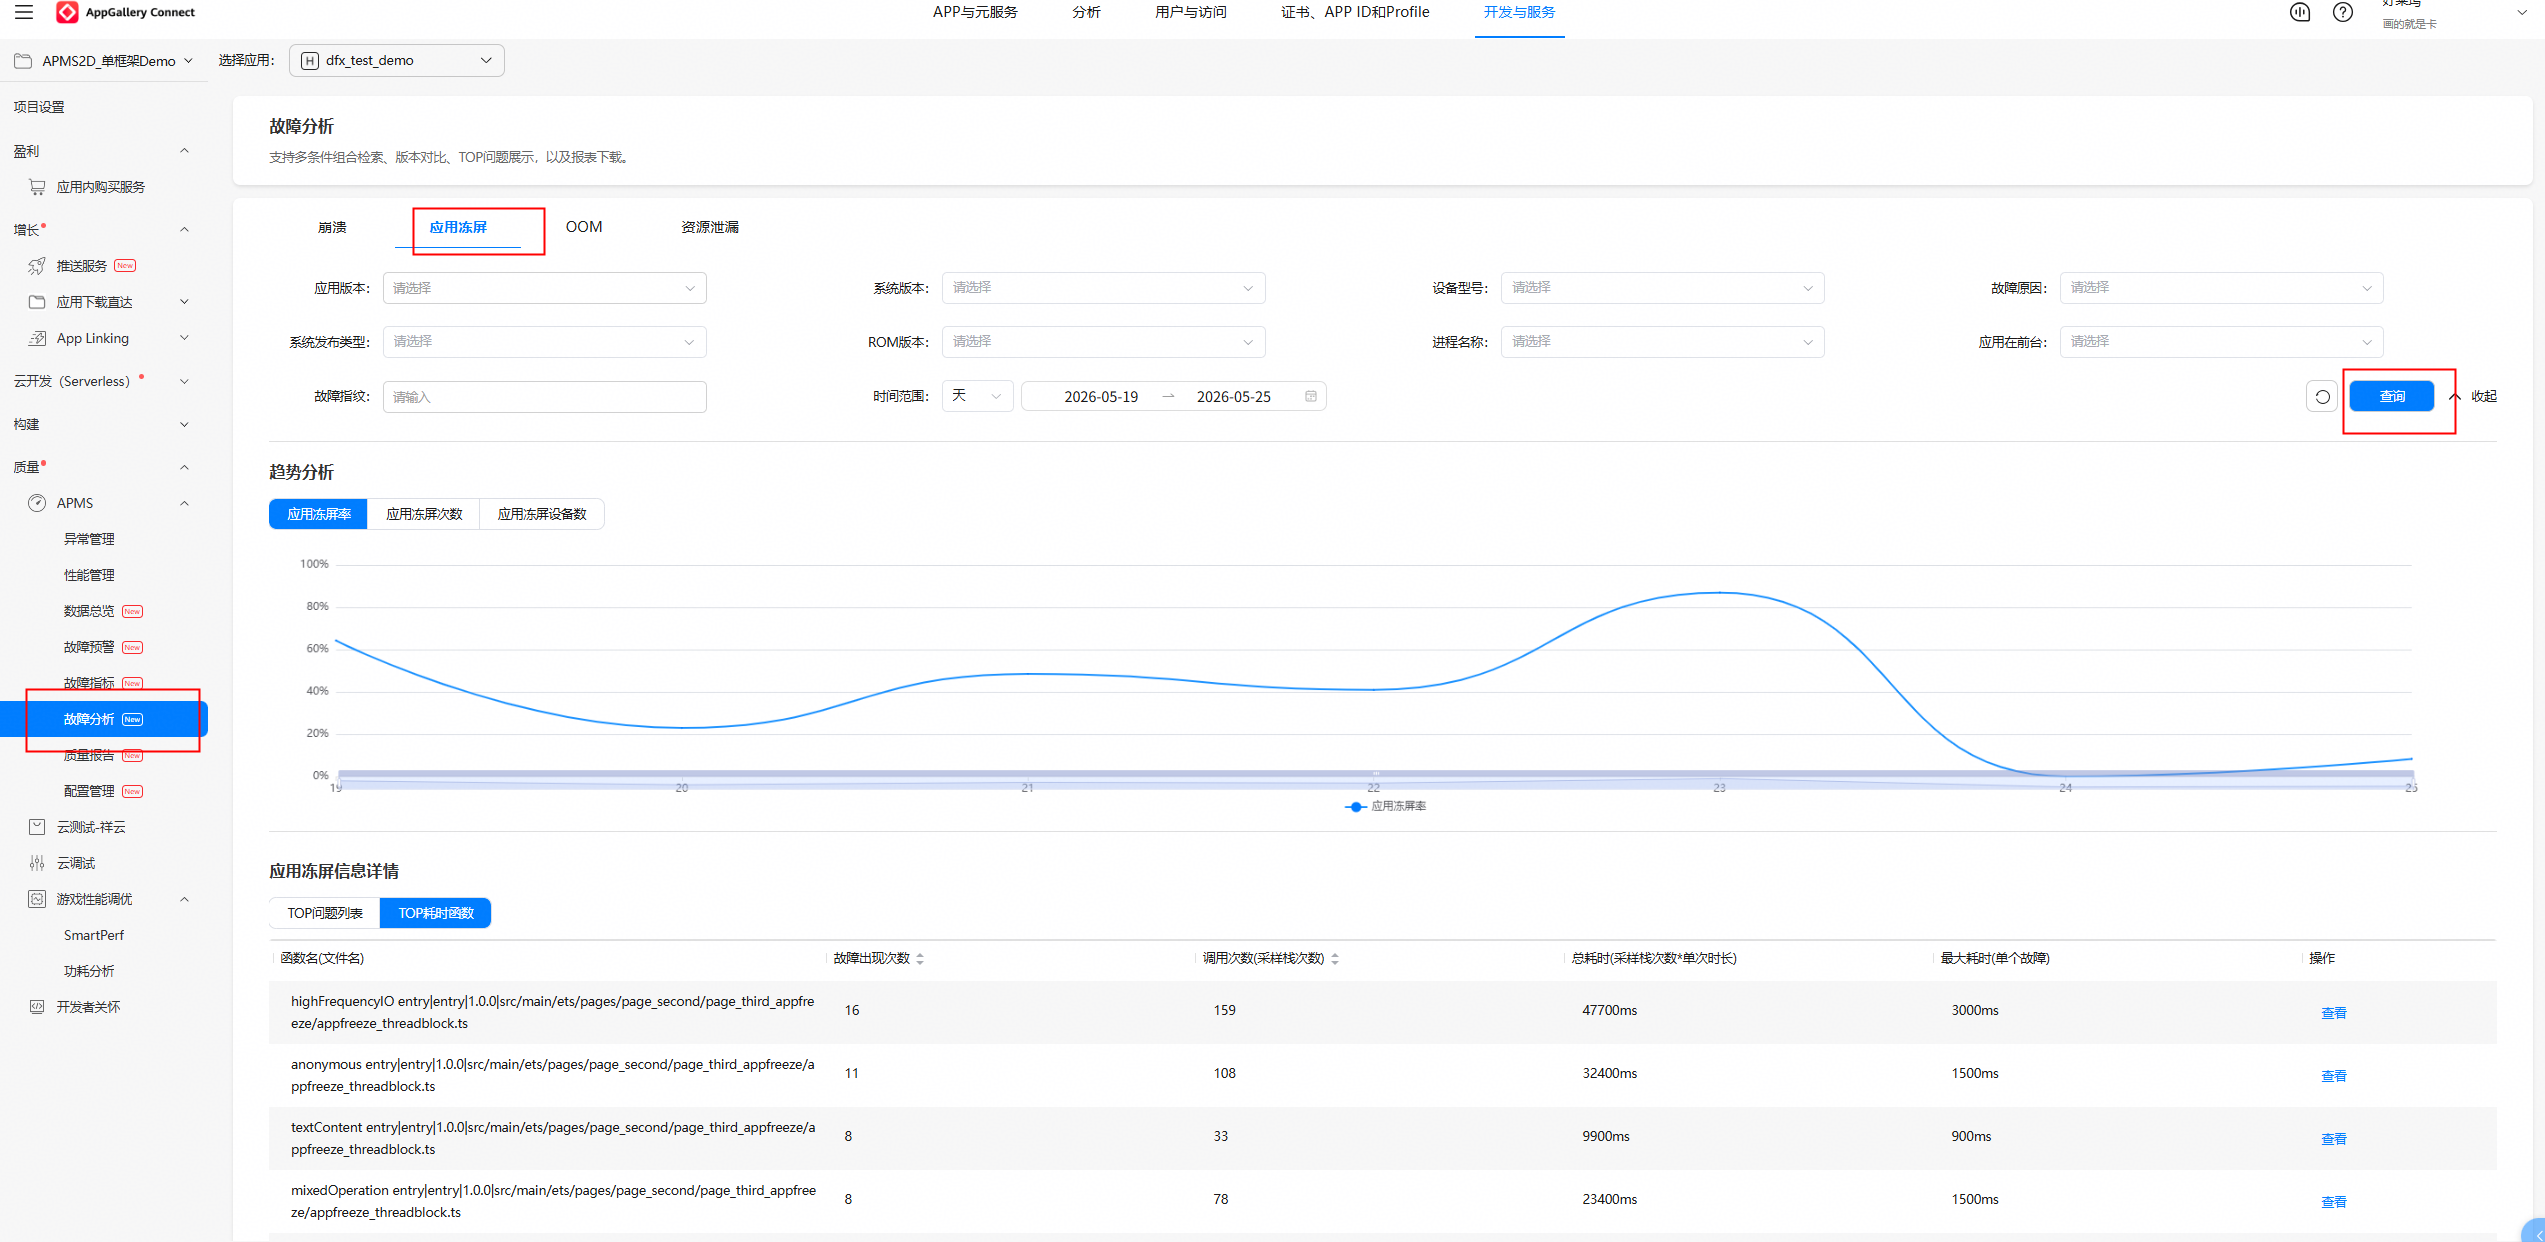
1.2.2.3 TOP 根因聚类
完成筛选后,开发者可进一步查看 Top 问题列表,在问题列表中,每个问题都是同一类问题的汇总。APMS 平台会将具有相同特征 ID 的问题聚合成一个,并按照发生次数进行排序,开发者可高优处理 top 问题。点击“查看”进入问题详情页,近一步查看问题详情。
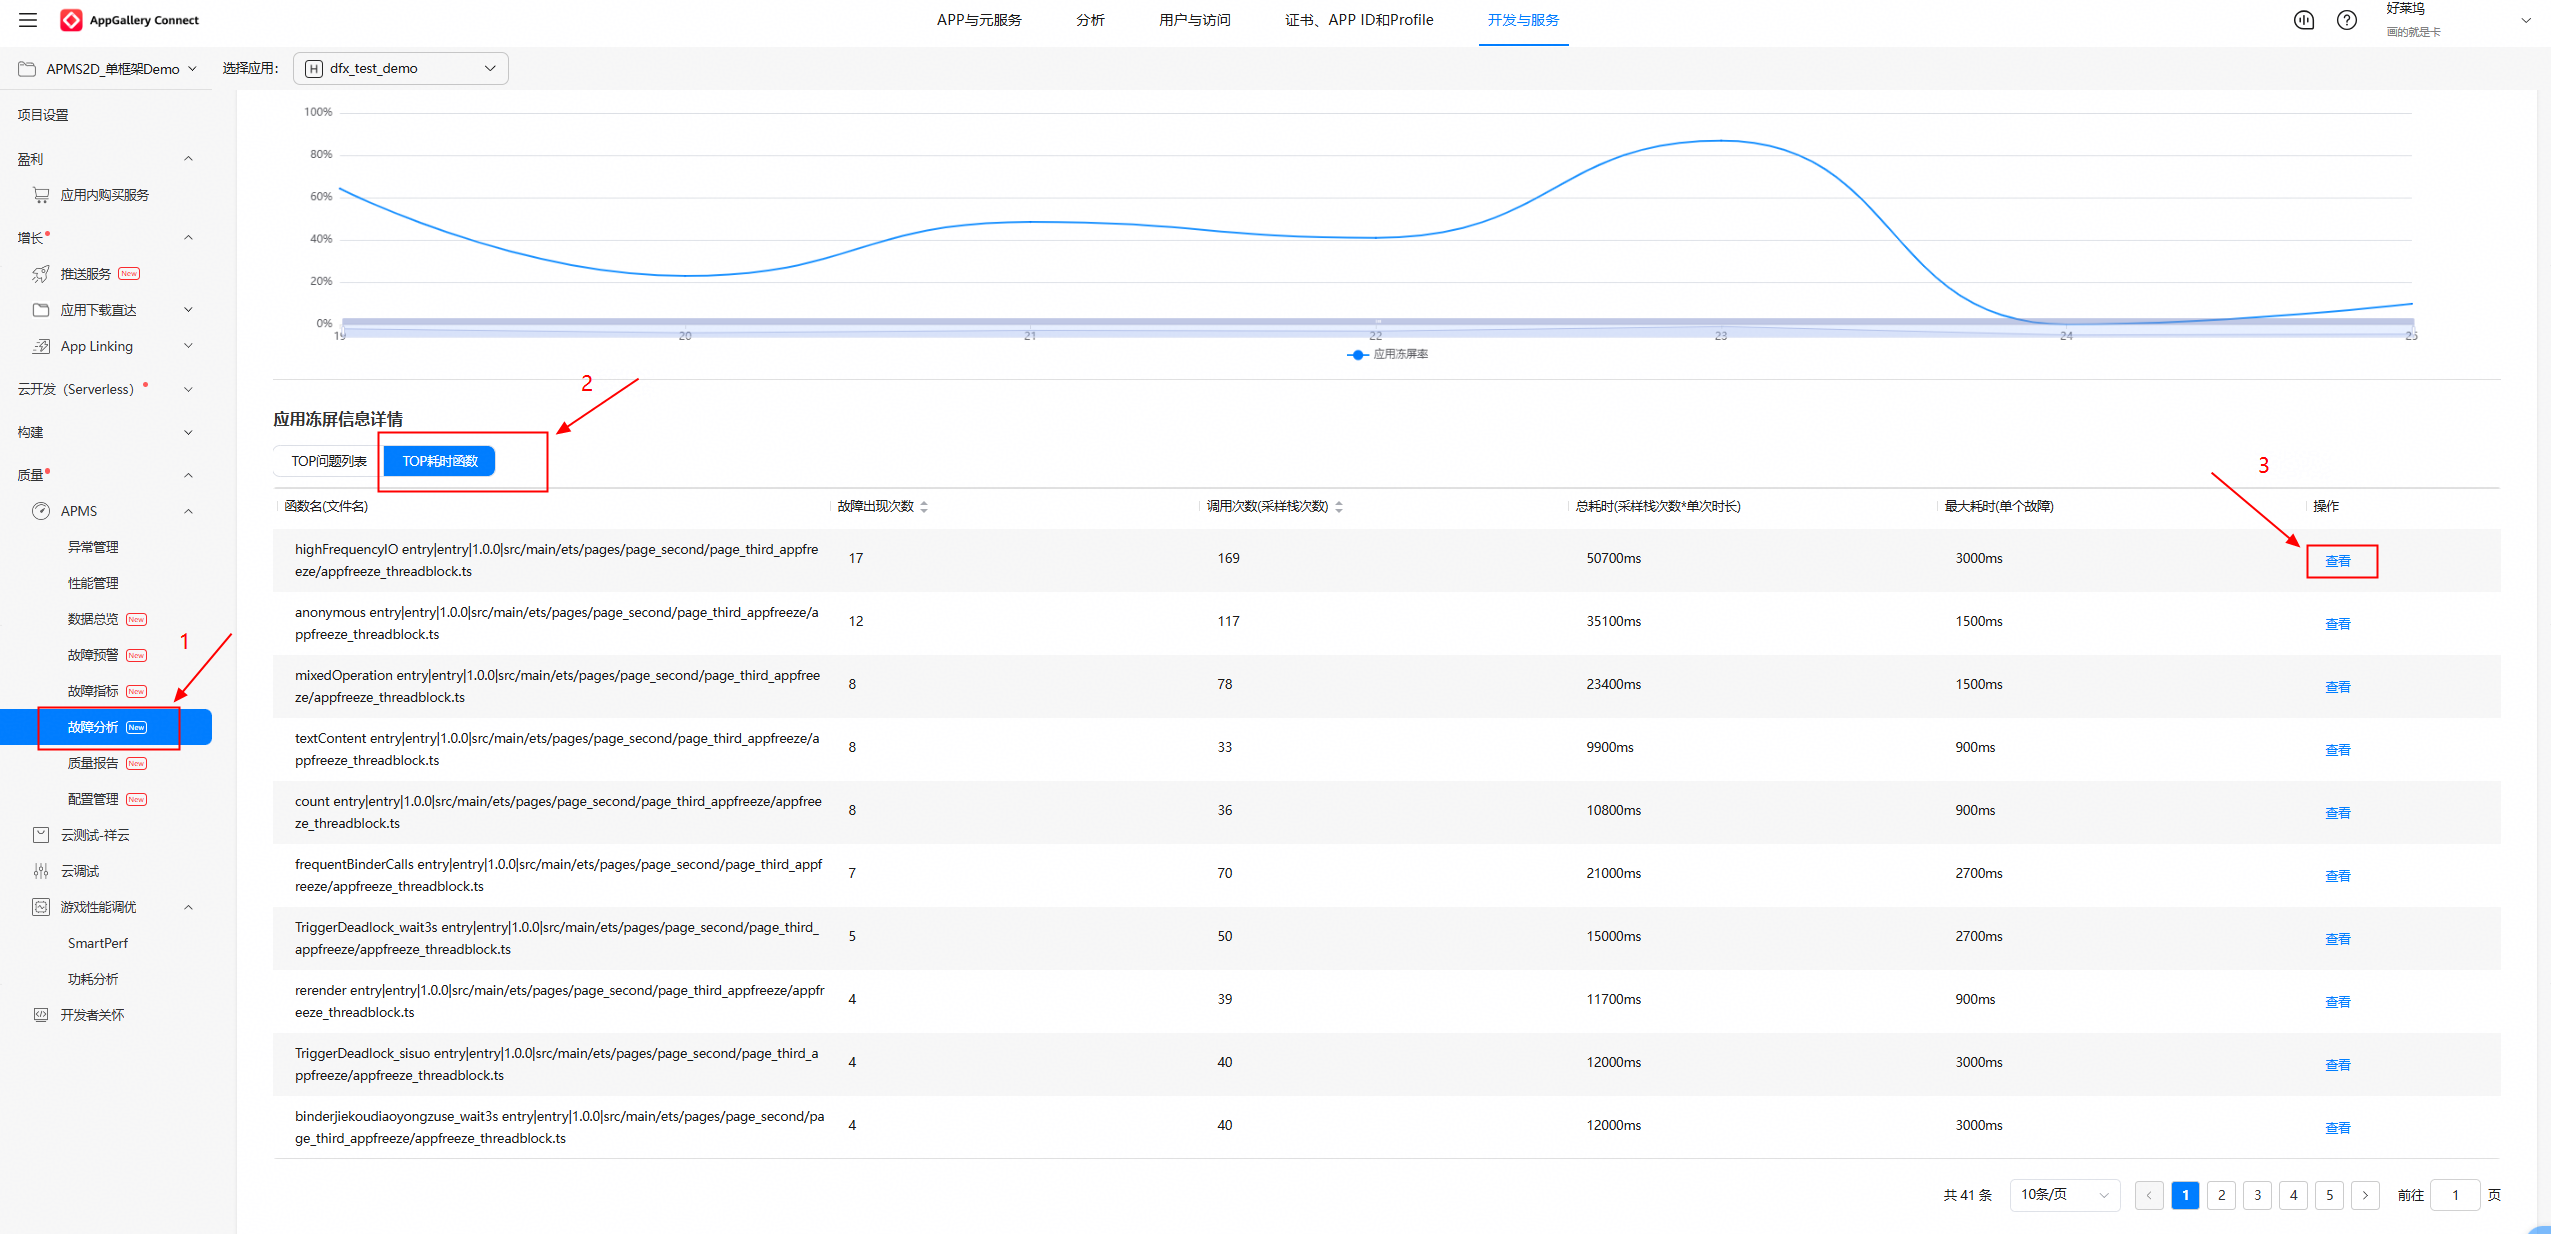
开发者也可以查看 Top 耗时函数,APMS 会根据函数名,将相同函数发生的问题聚类成一个记录,并按照故障出现次数进行排序,开发者可根据函数名排查自己的业务逻辑。点击“查看”进入问题详情页,近一步查看问题详情。
1.2.3 根因定位与分析
1.2.3.1 基础定位信息
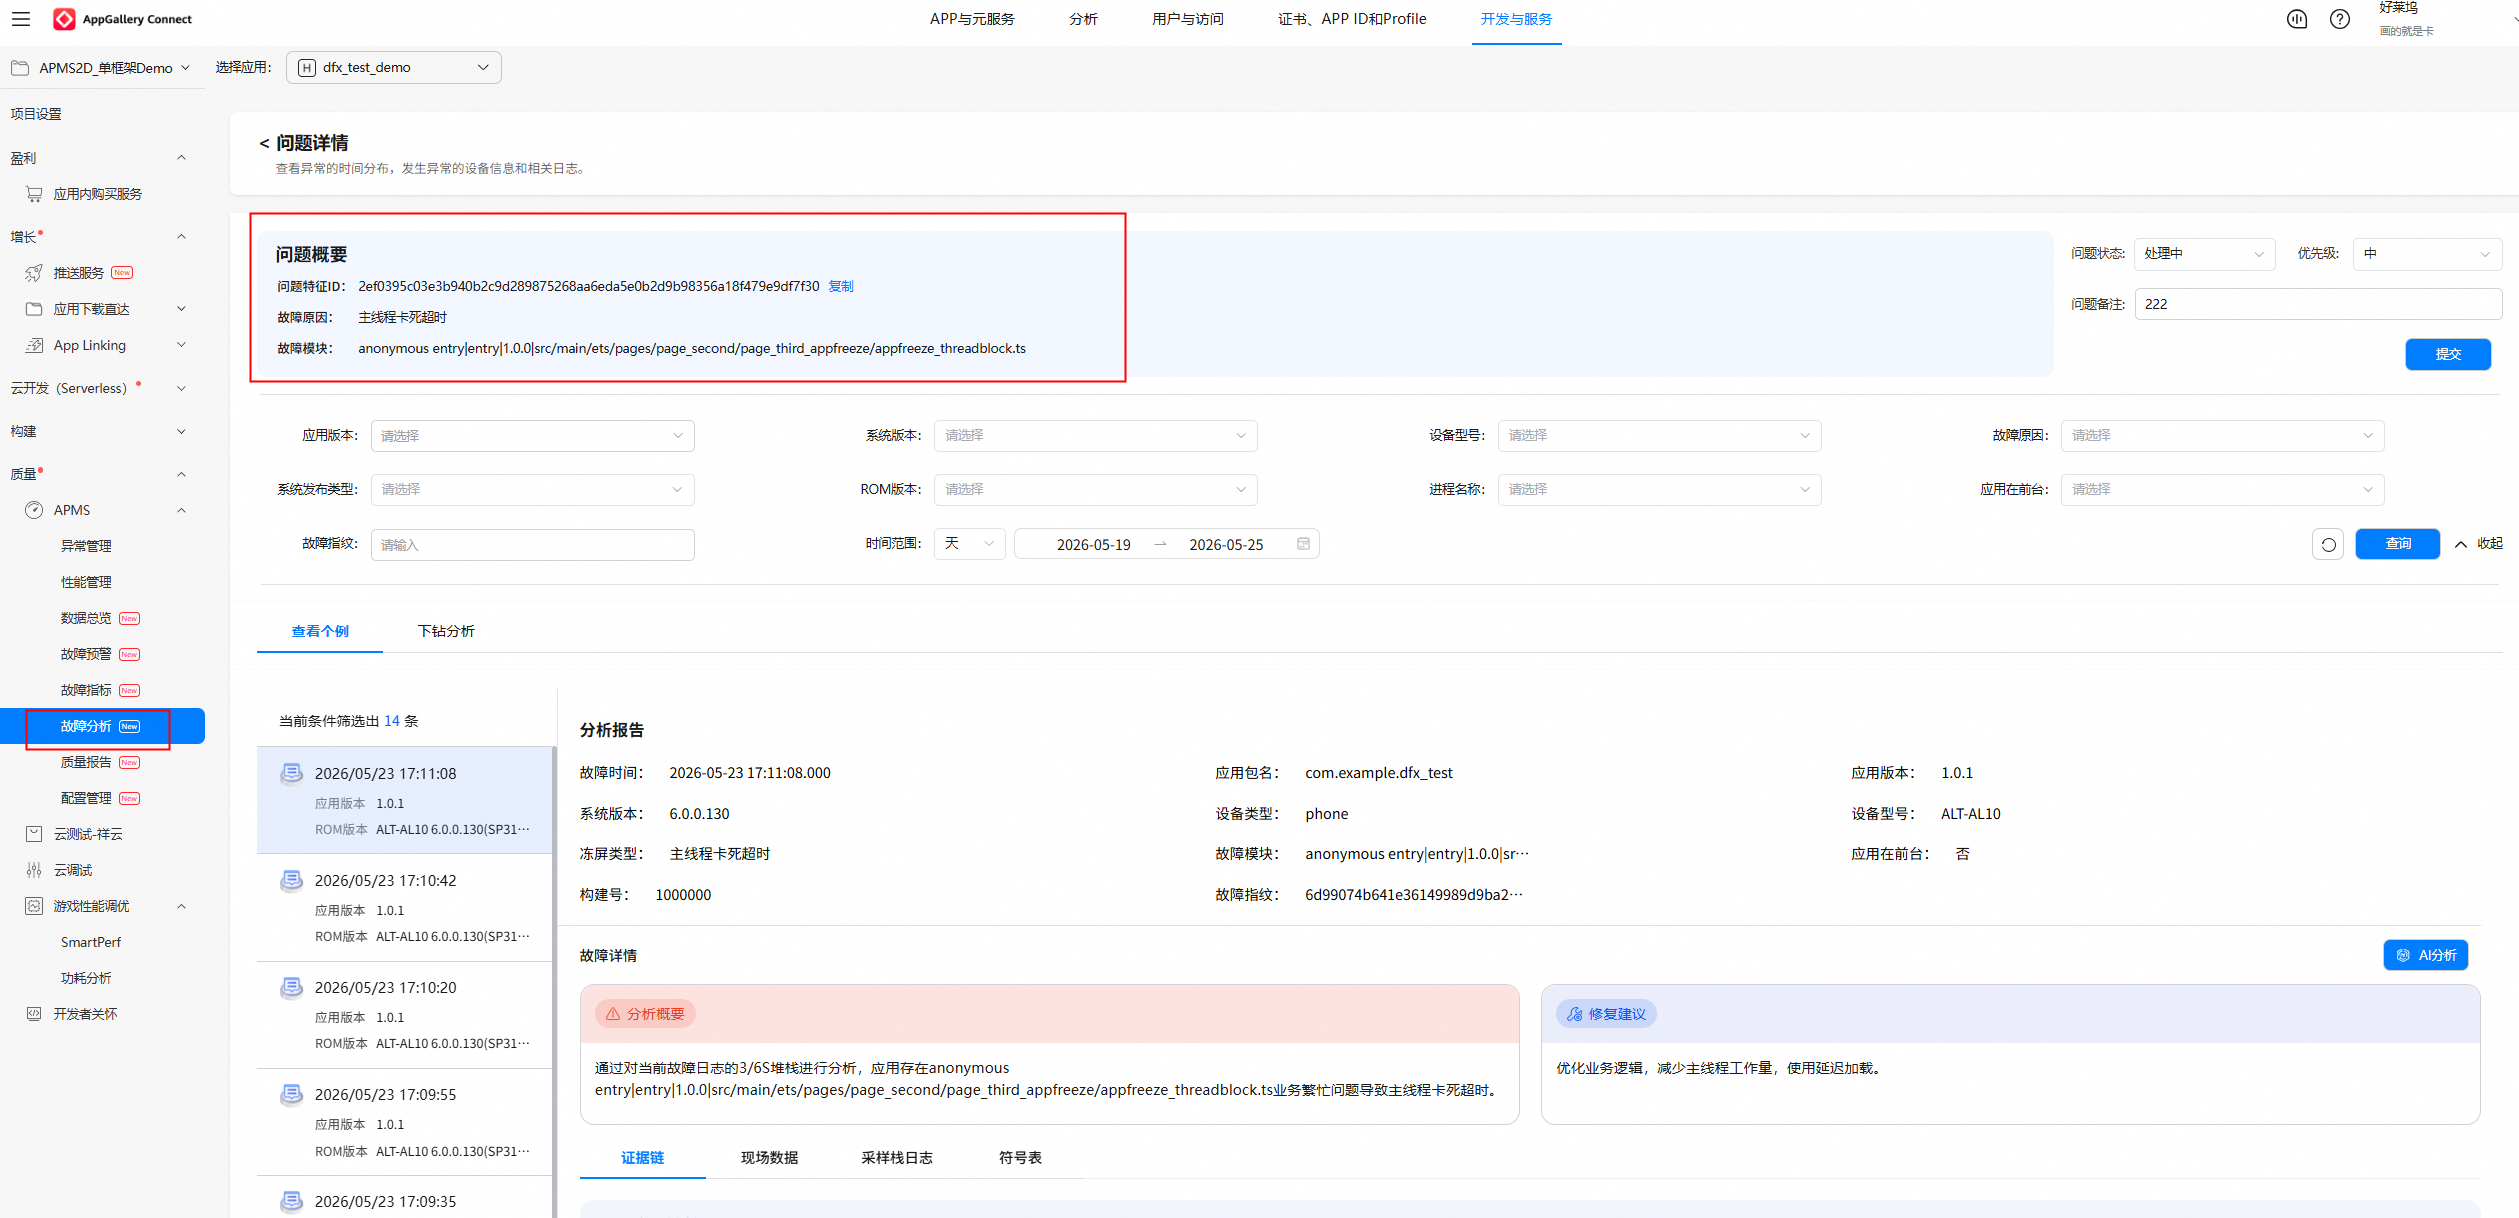
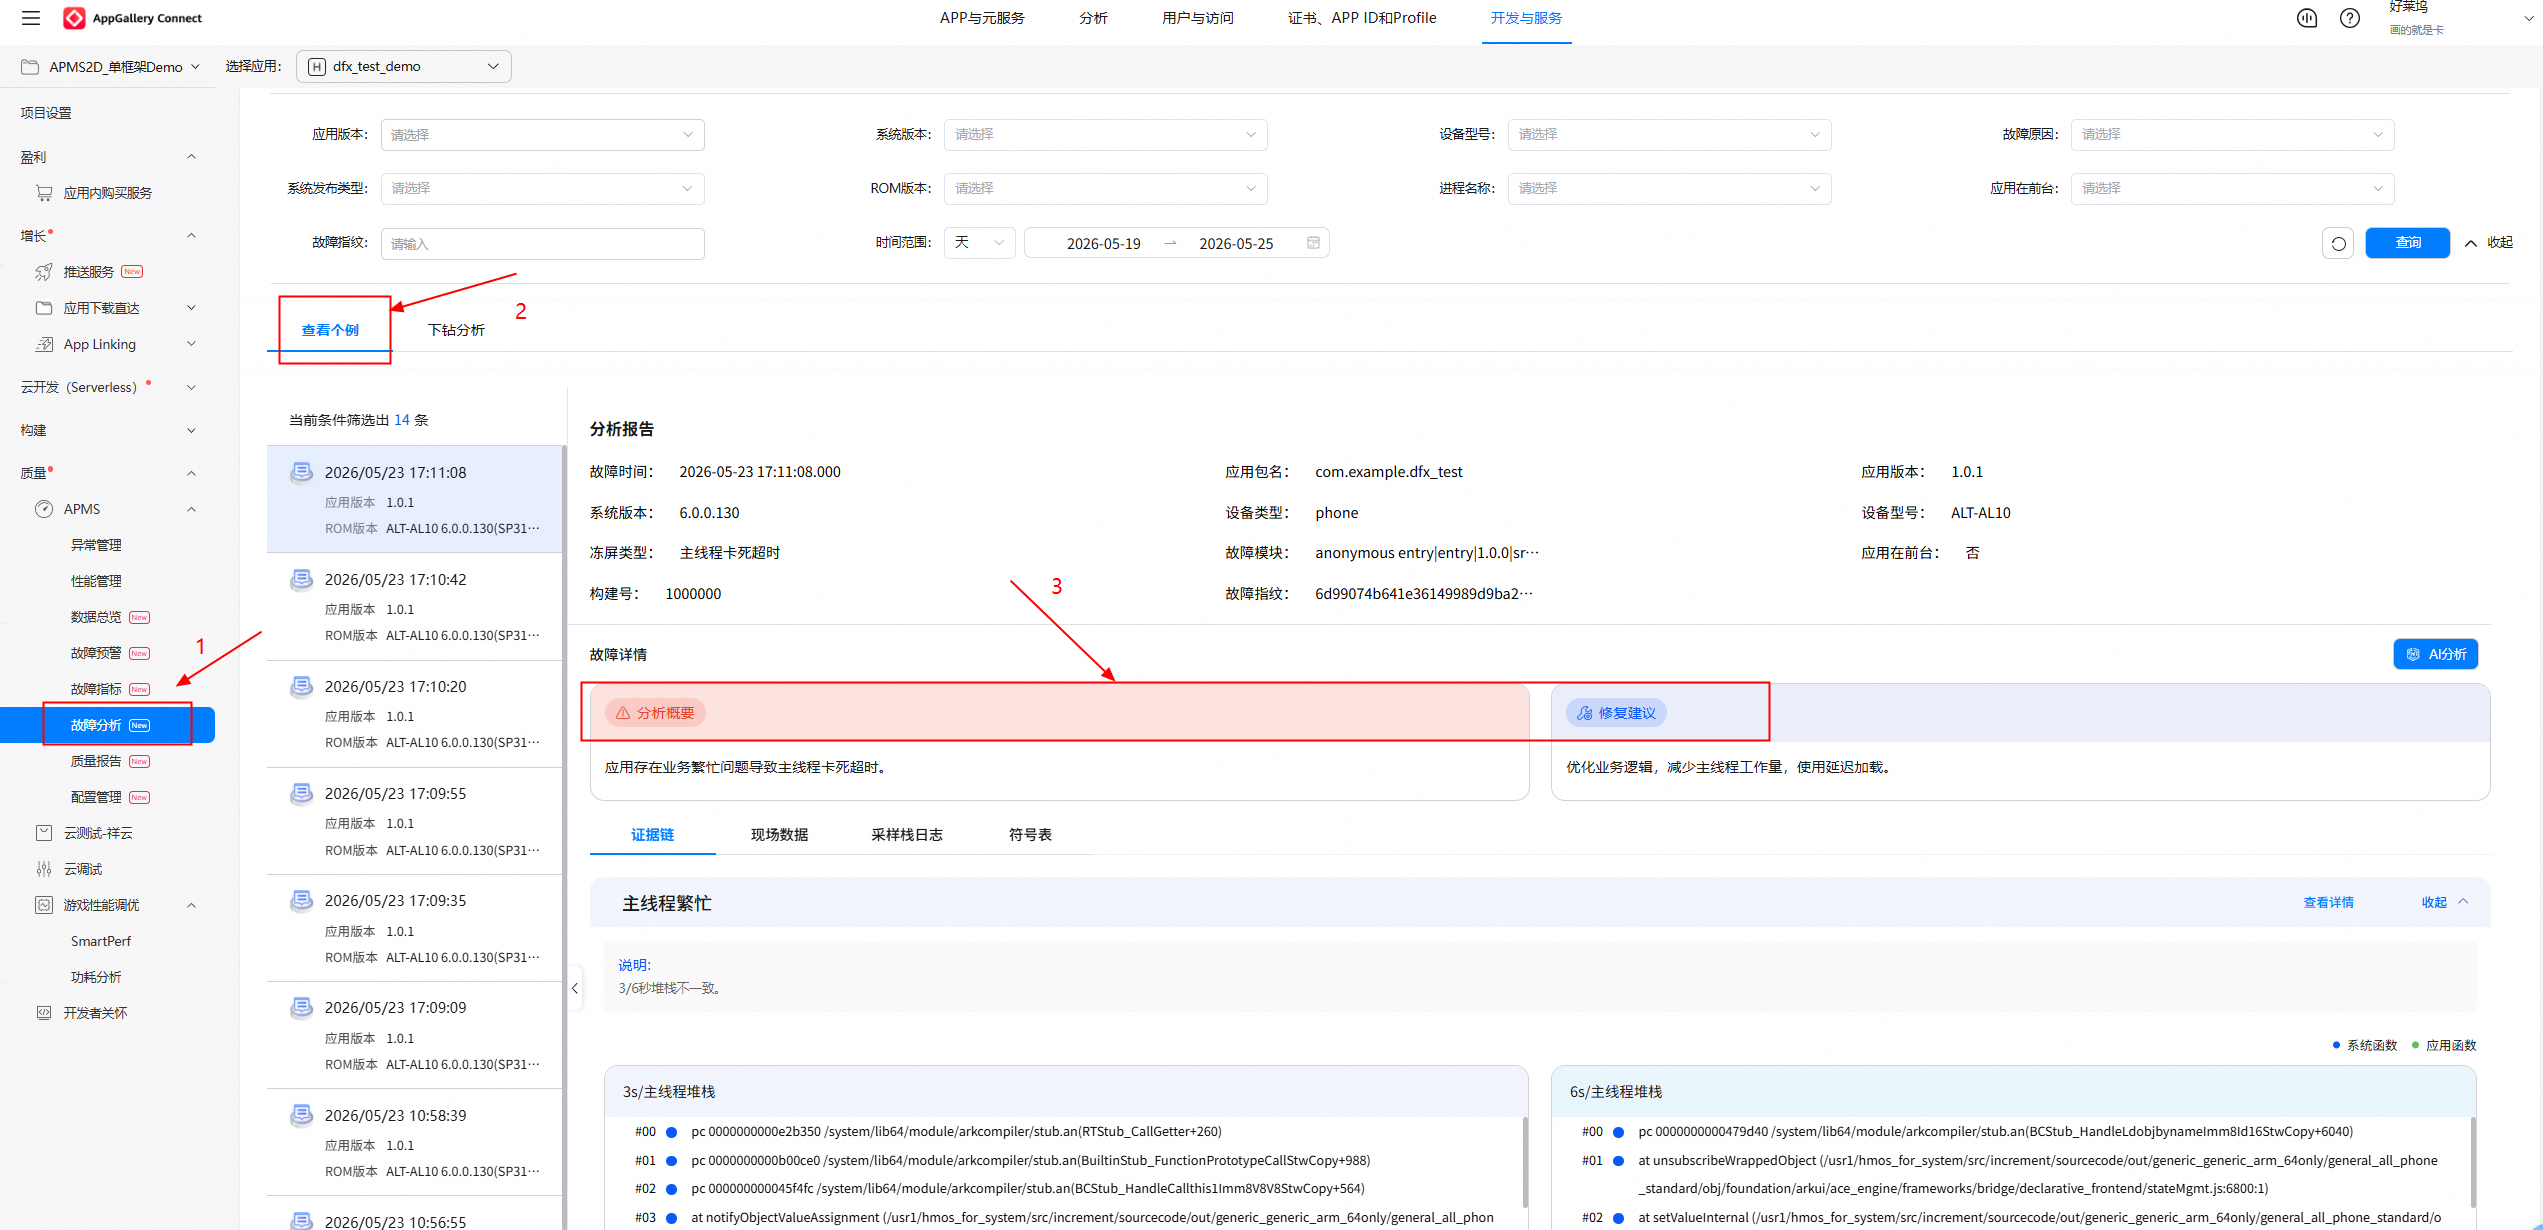
点击应用冻屏信息详情列表某个问题(通常状态不为已修复)进入详情页后,APMS 将提供以下核心分析信息,帮助开发者定位根因
问题概要:展示问题的核心身份信息,包括问题特征 ID、故障原因、故障模块,帮助您快速判断卡死的基本属性。
聚类数据:基于堆栈关键行和过滤筛选跳转聚类同类故障,帮助您评估问题的影响范围与严重程度。
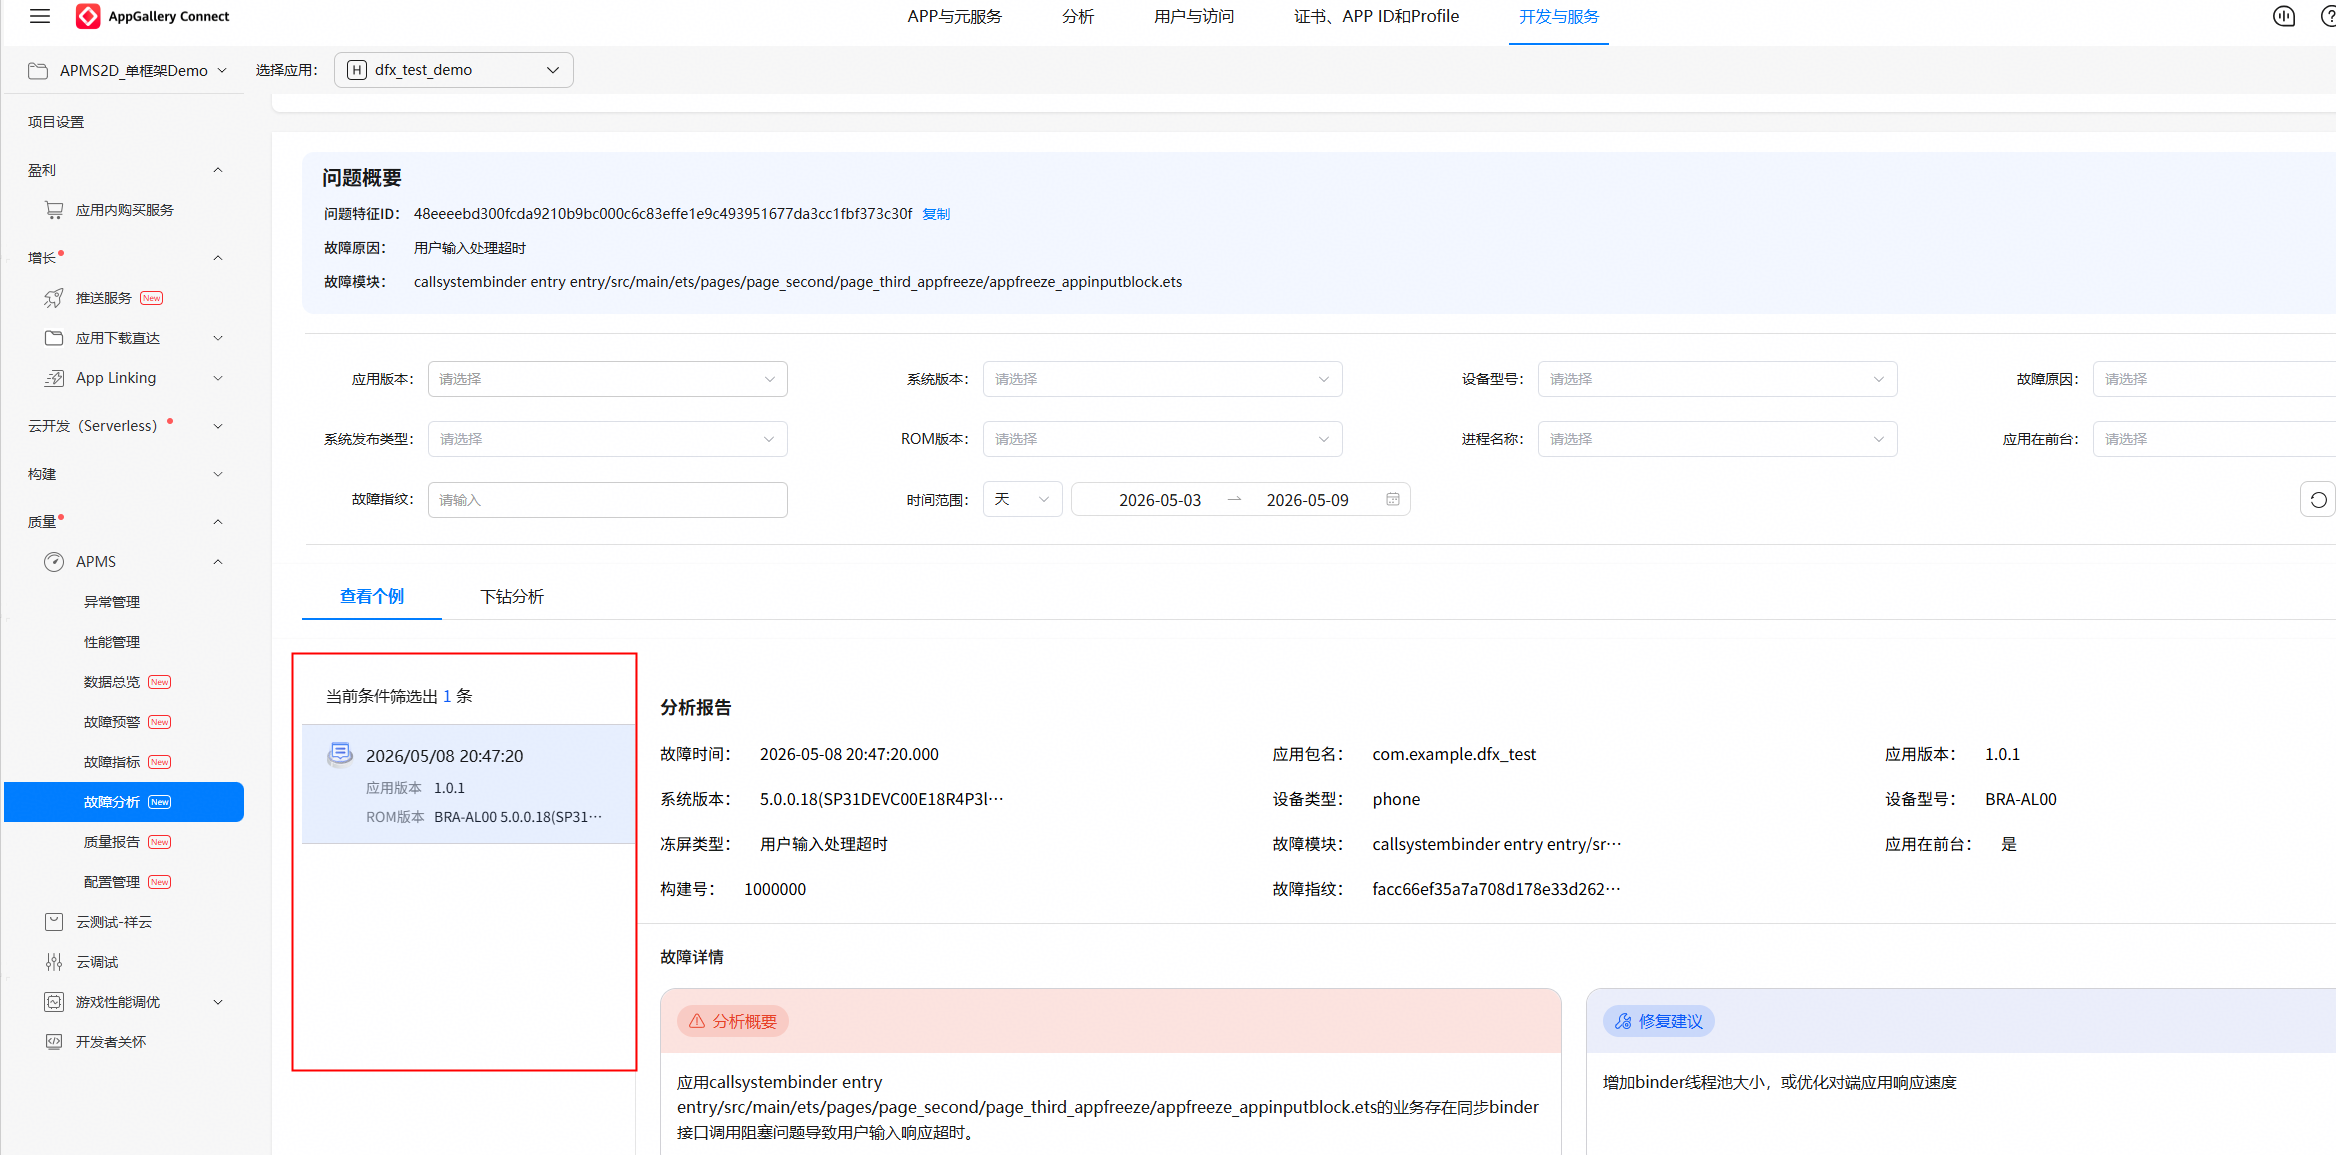
分析报告:提供问题发生时的完整上下文,包括环境信息(设备型号、系统版本、ROM 版本、前后台状态等)、堆栈信息、日志文件,并基于分析结果给出修复建议,辅助您高效完成问题排查与闭环。
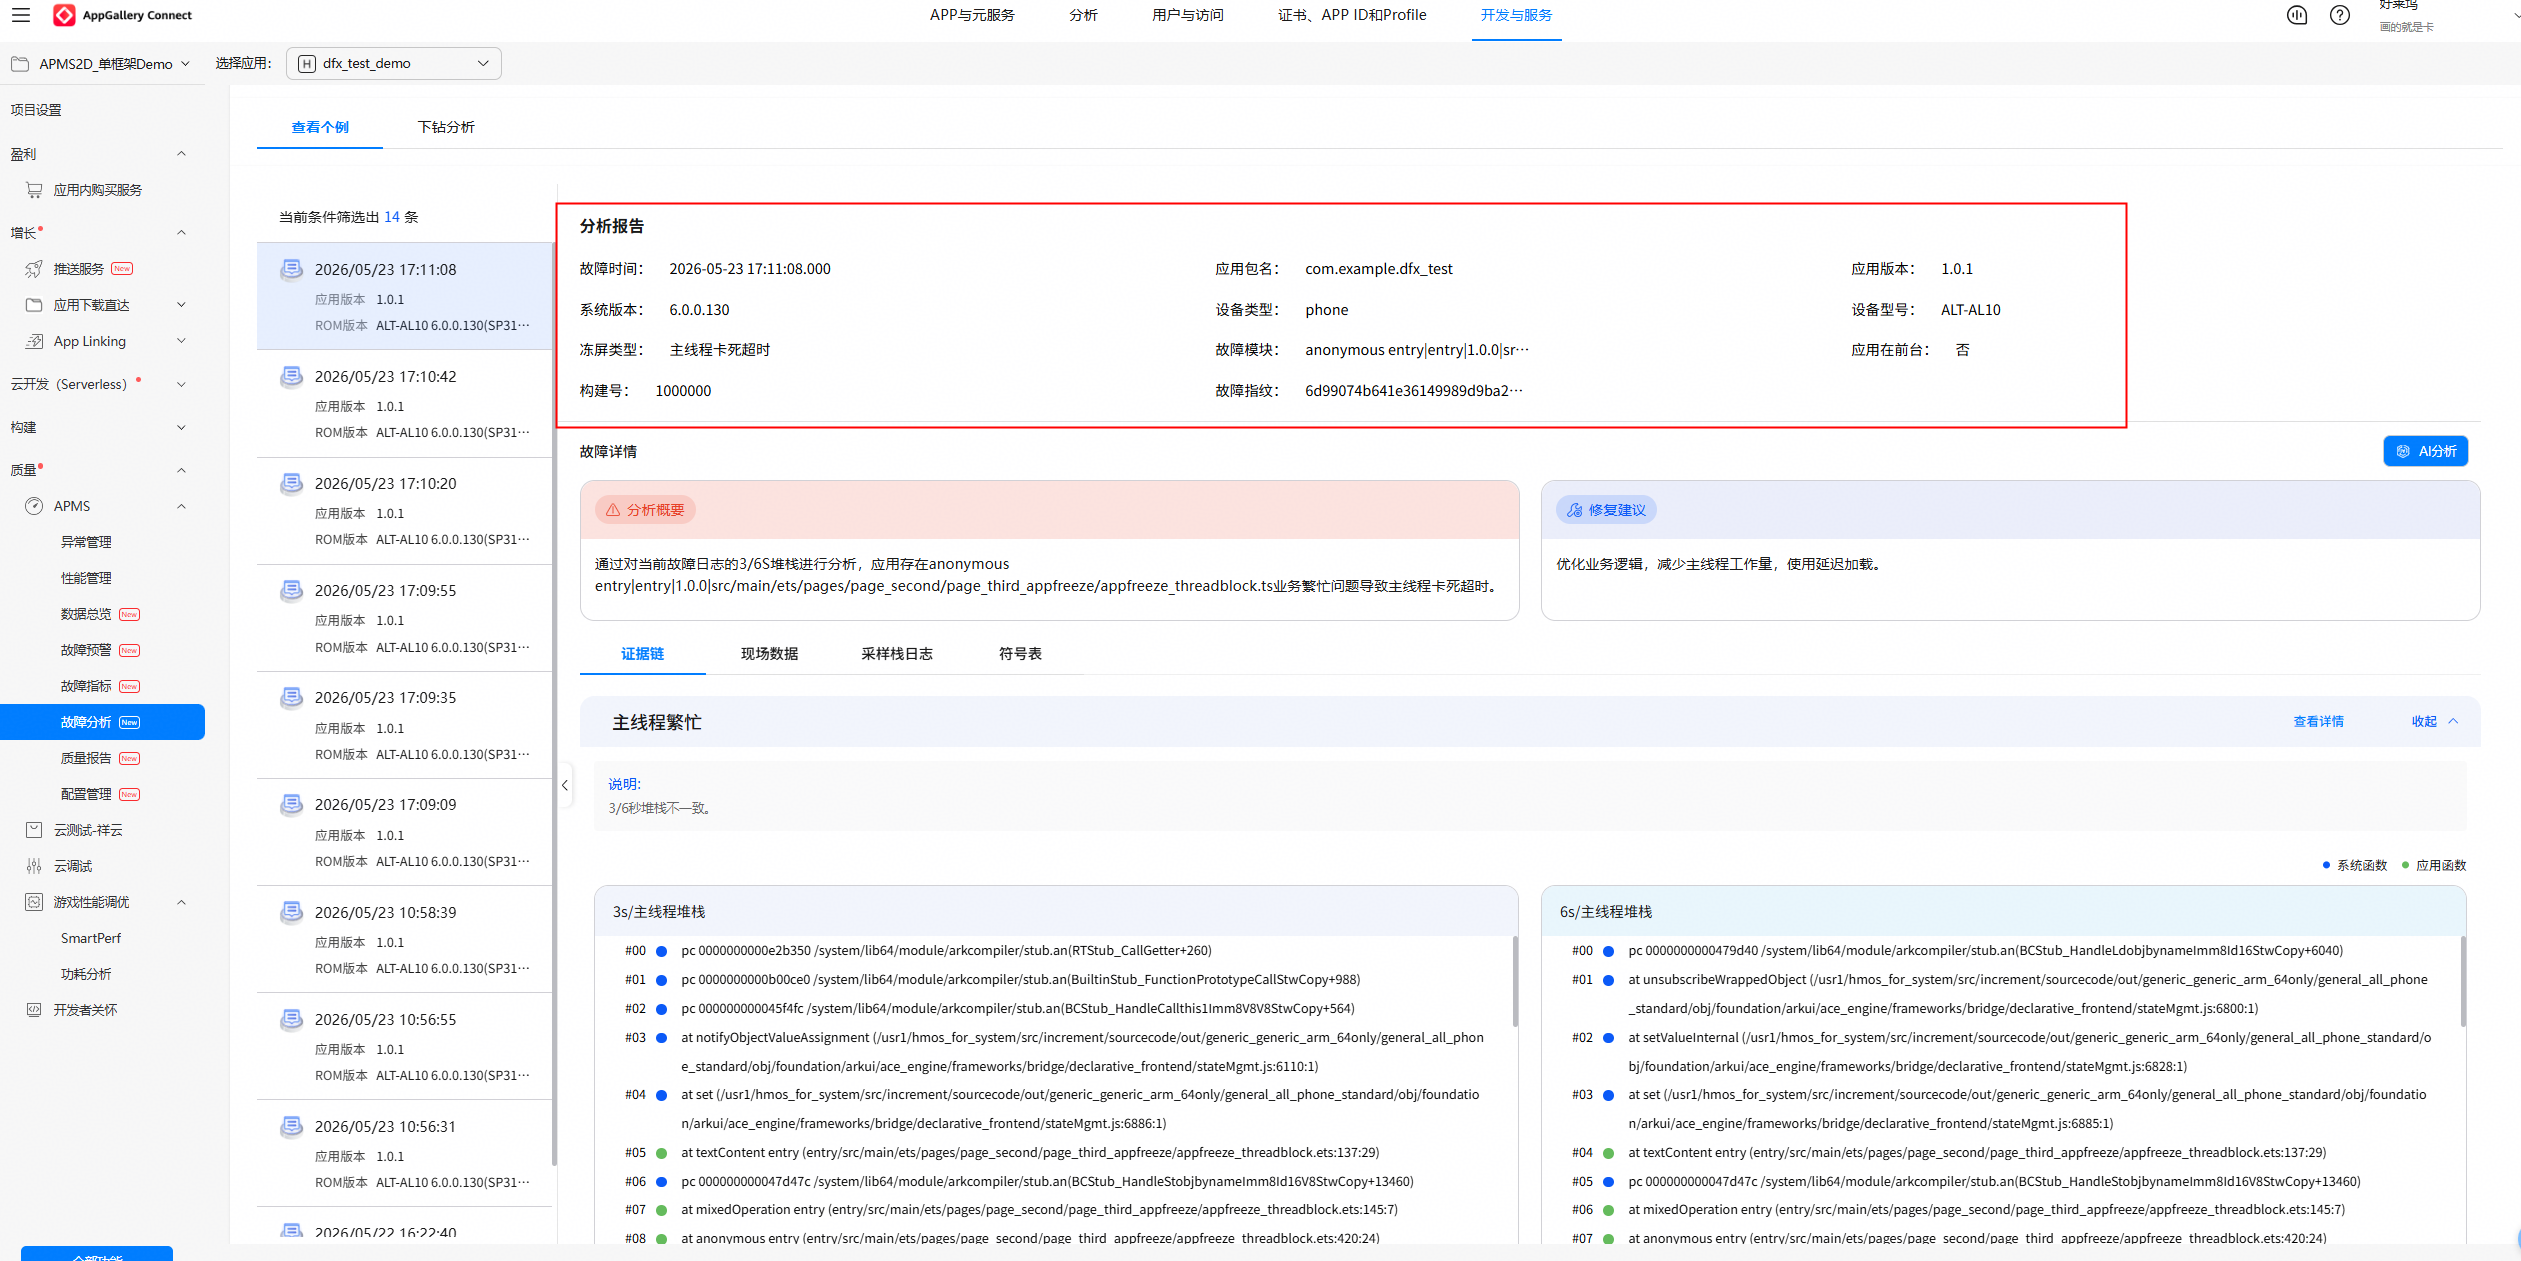
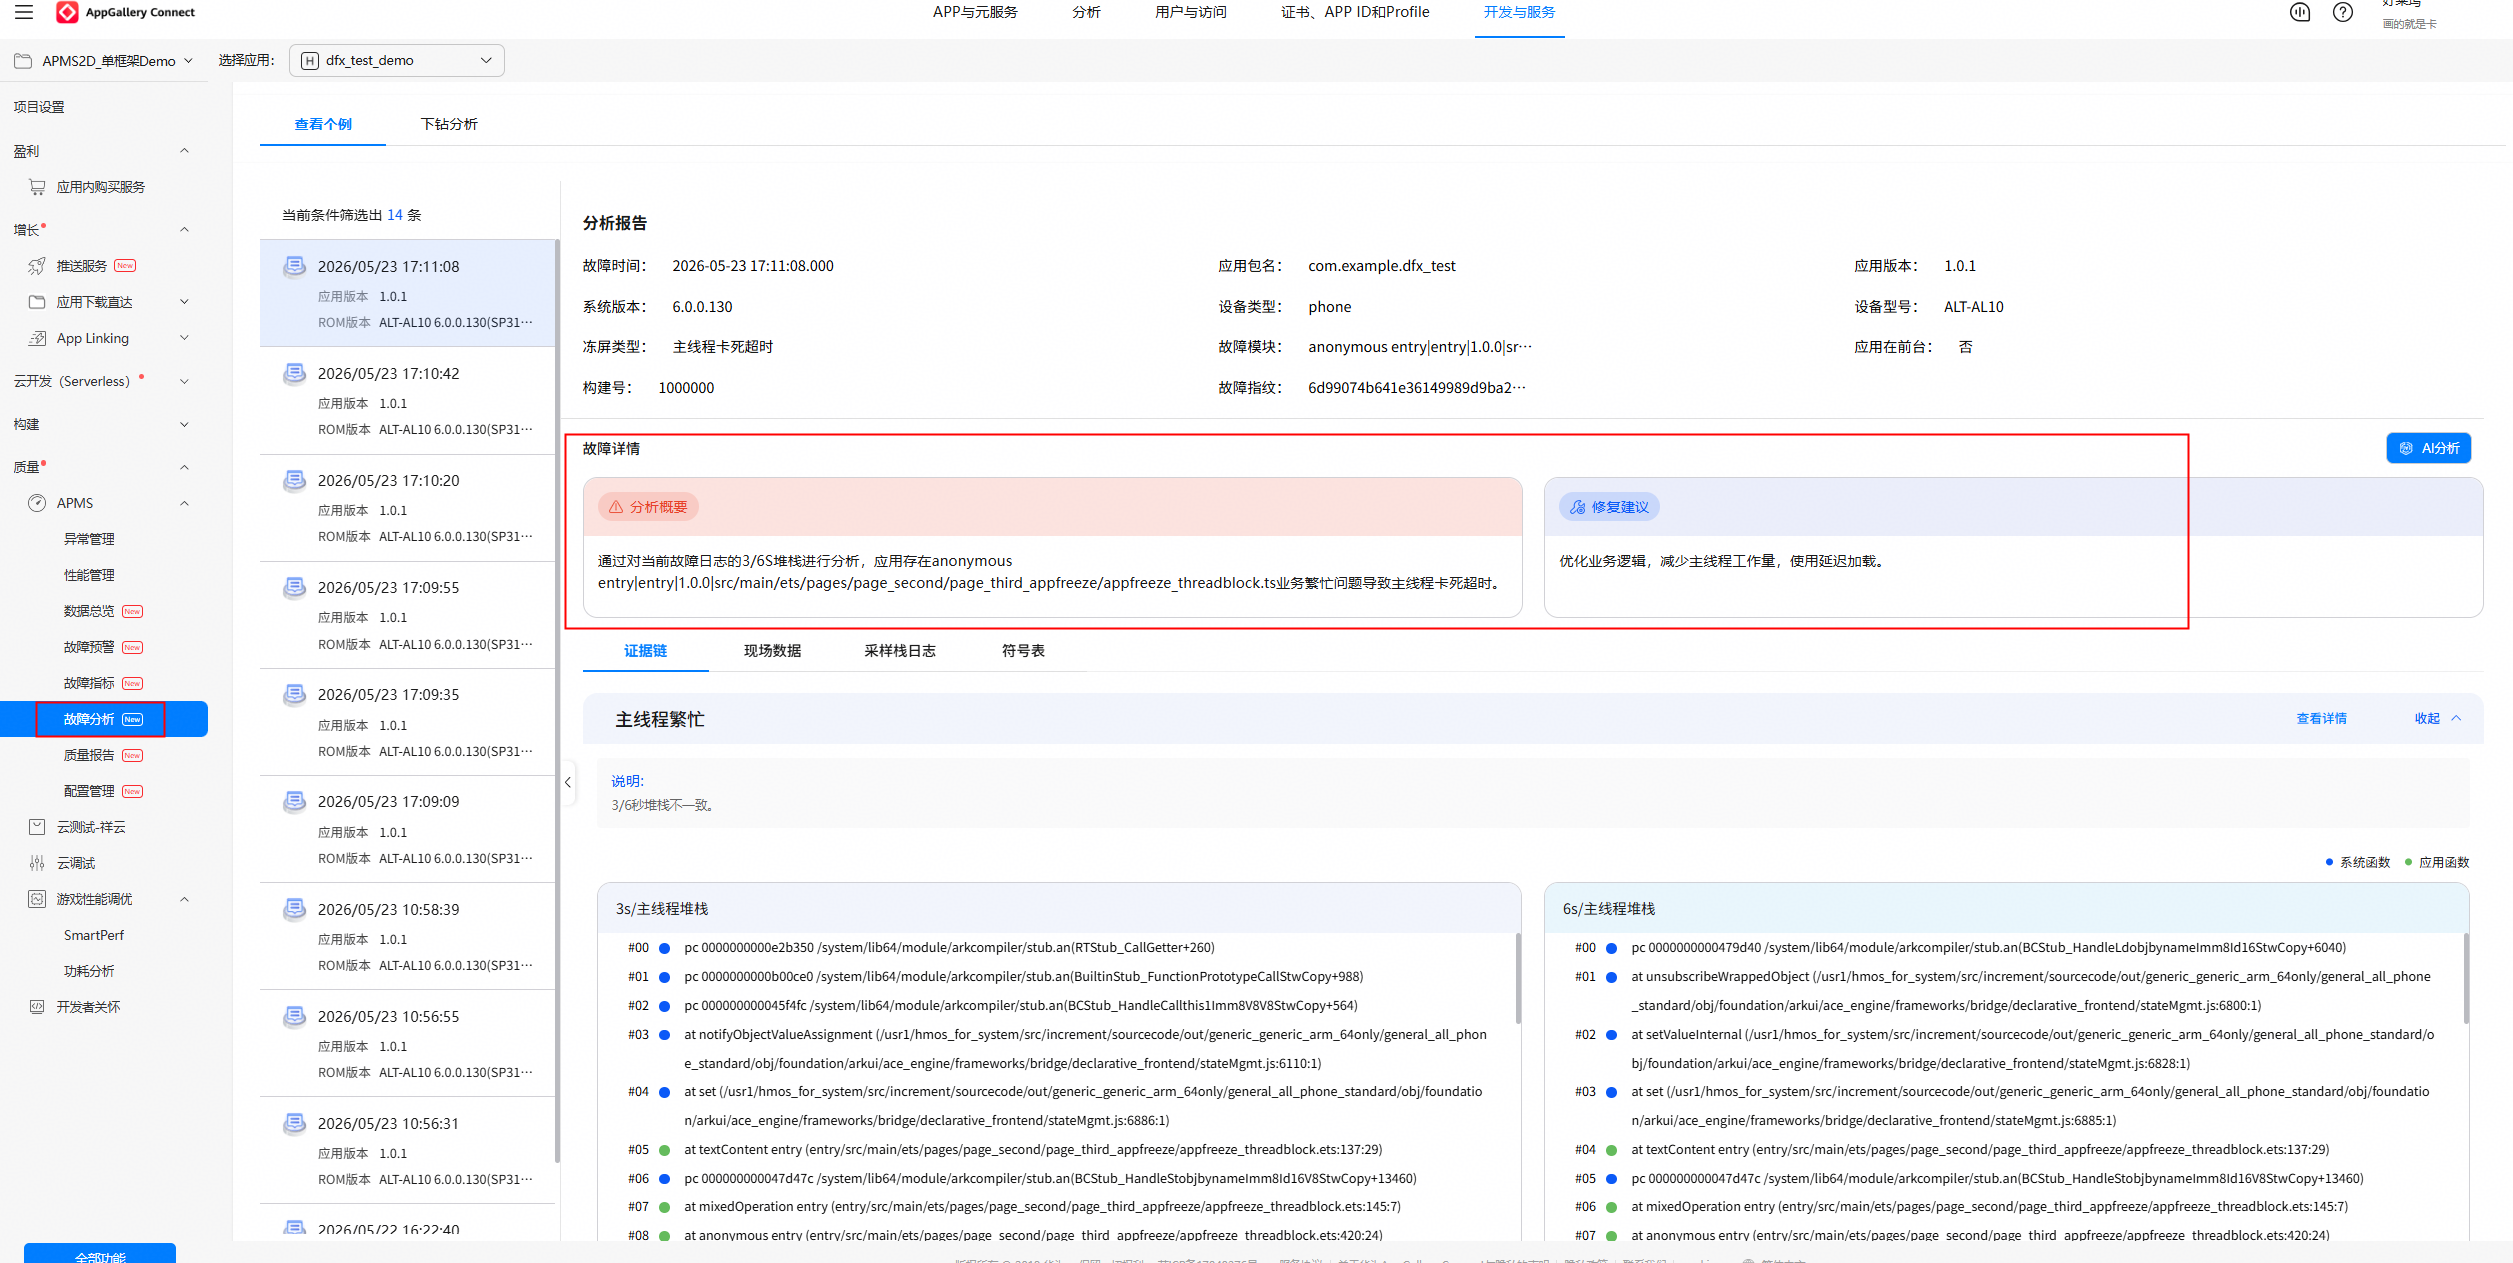
故障详情:可根据平台解析出的故障原因,参照修复建议定位代码问题,完成问题修复与验证。
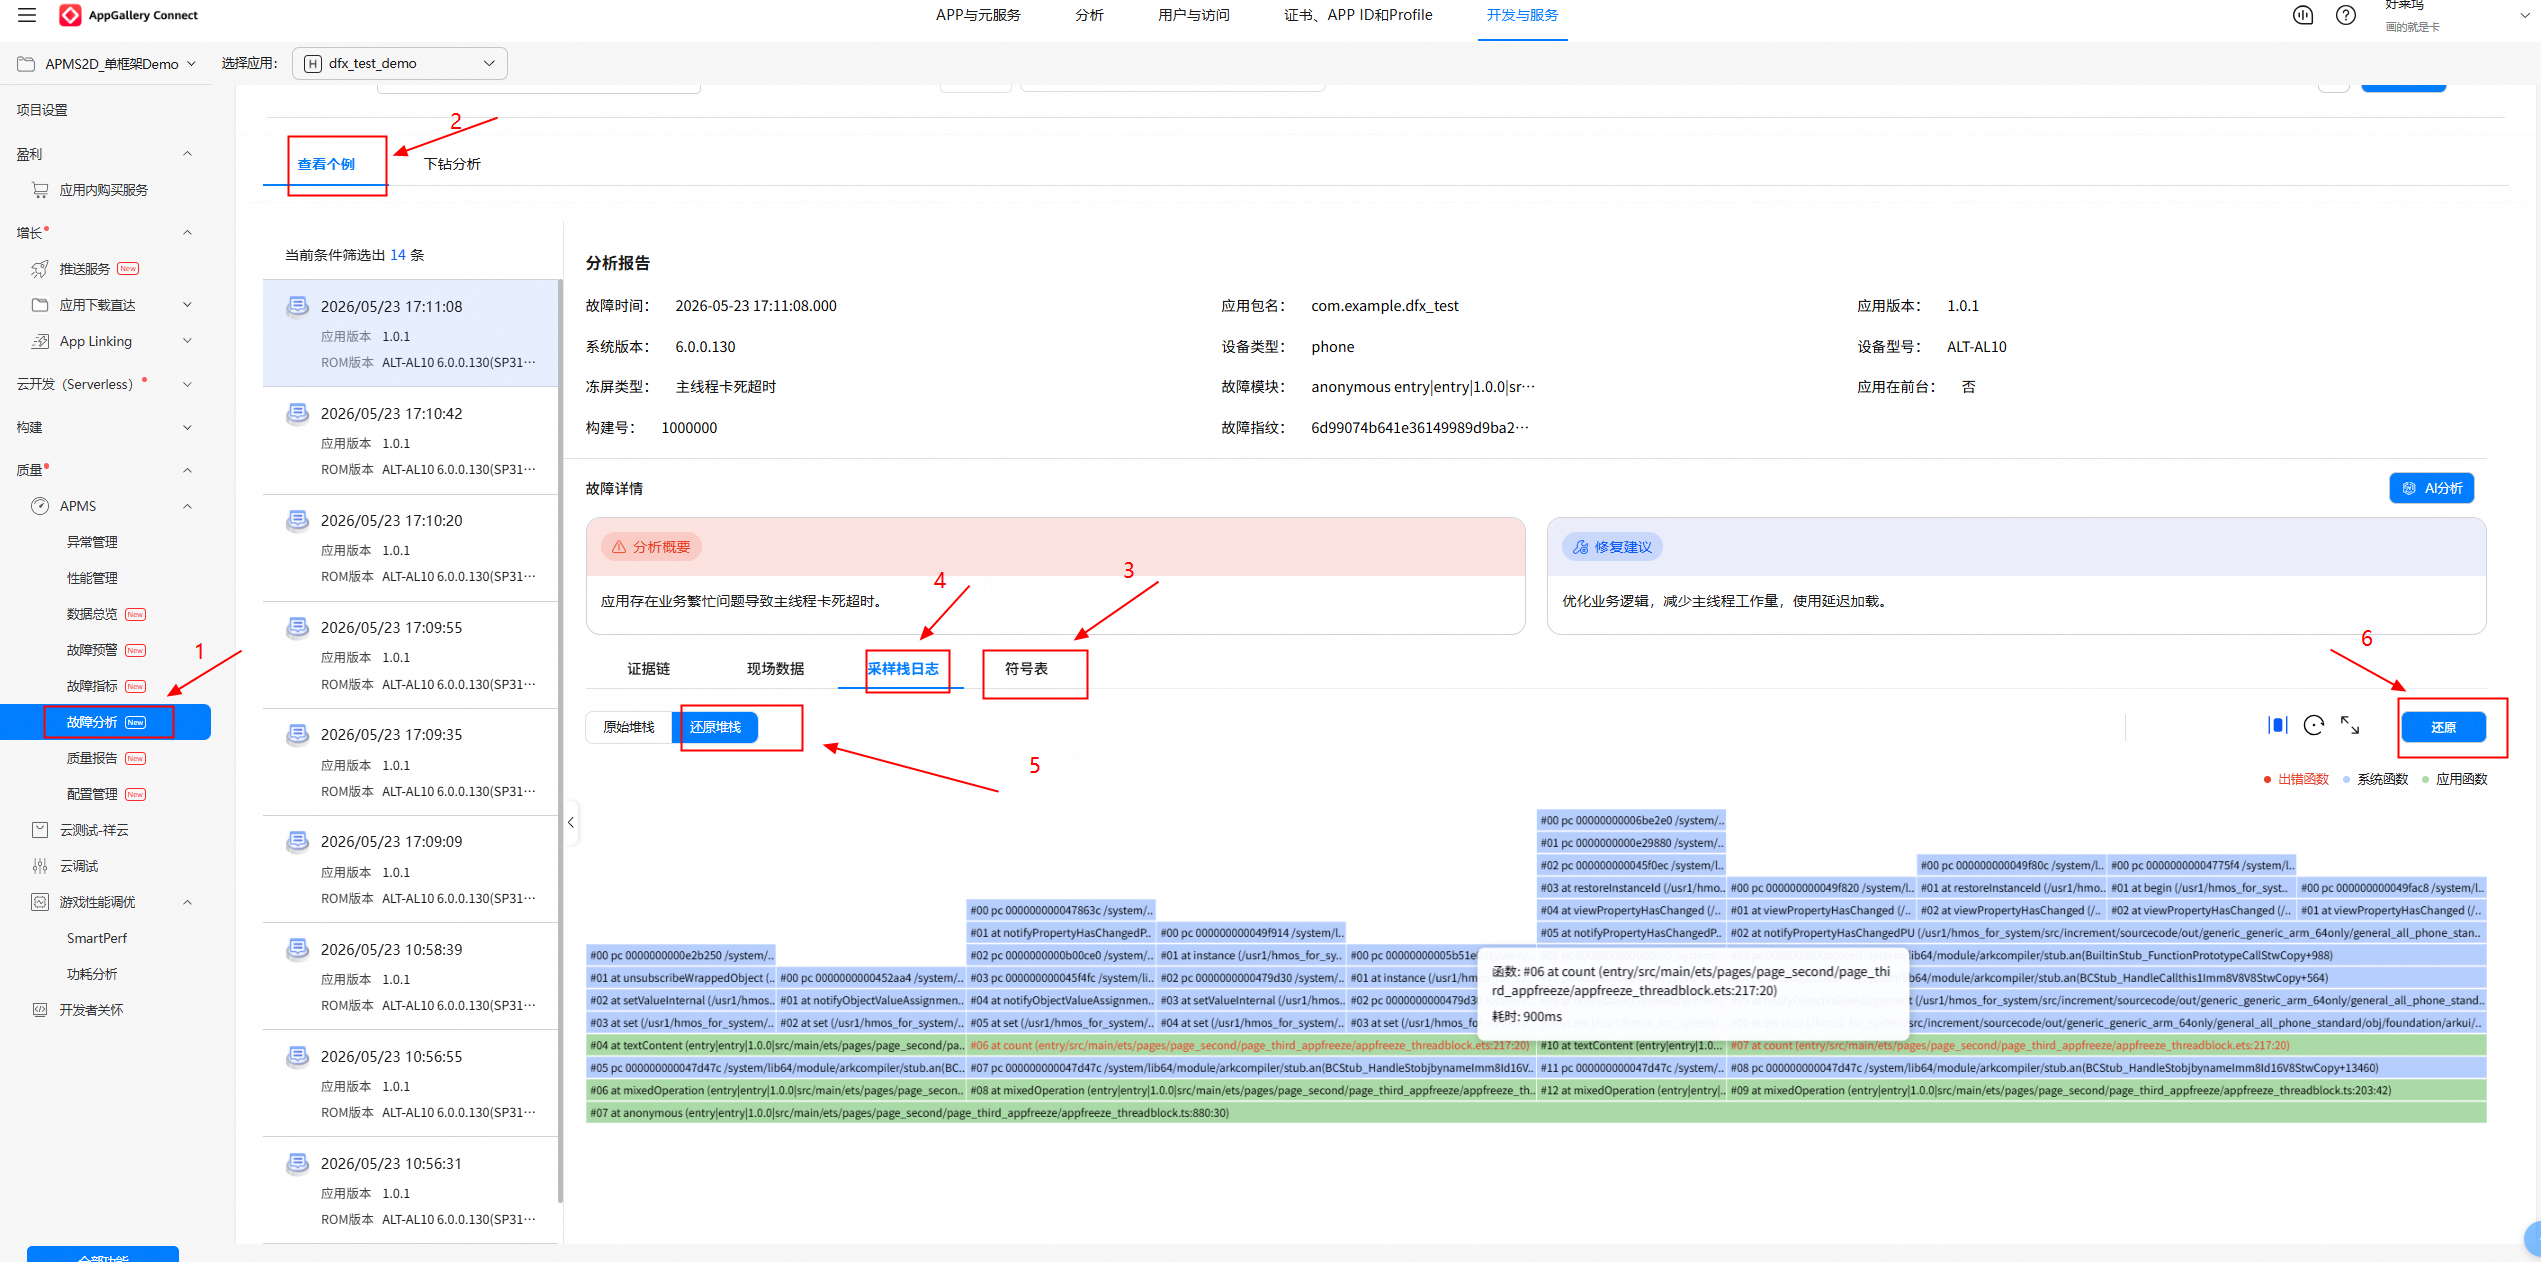
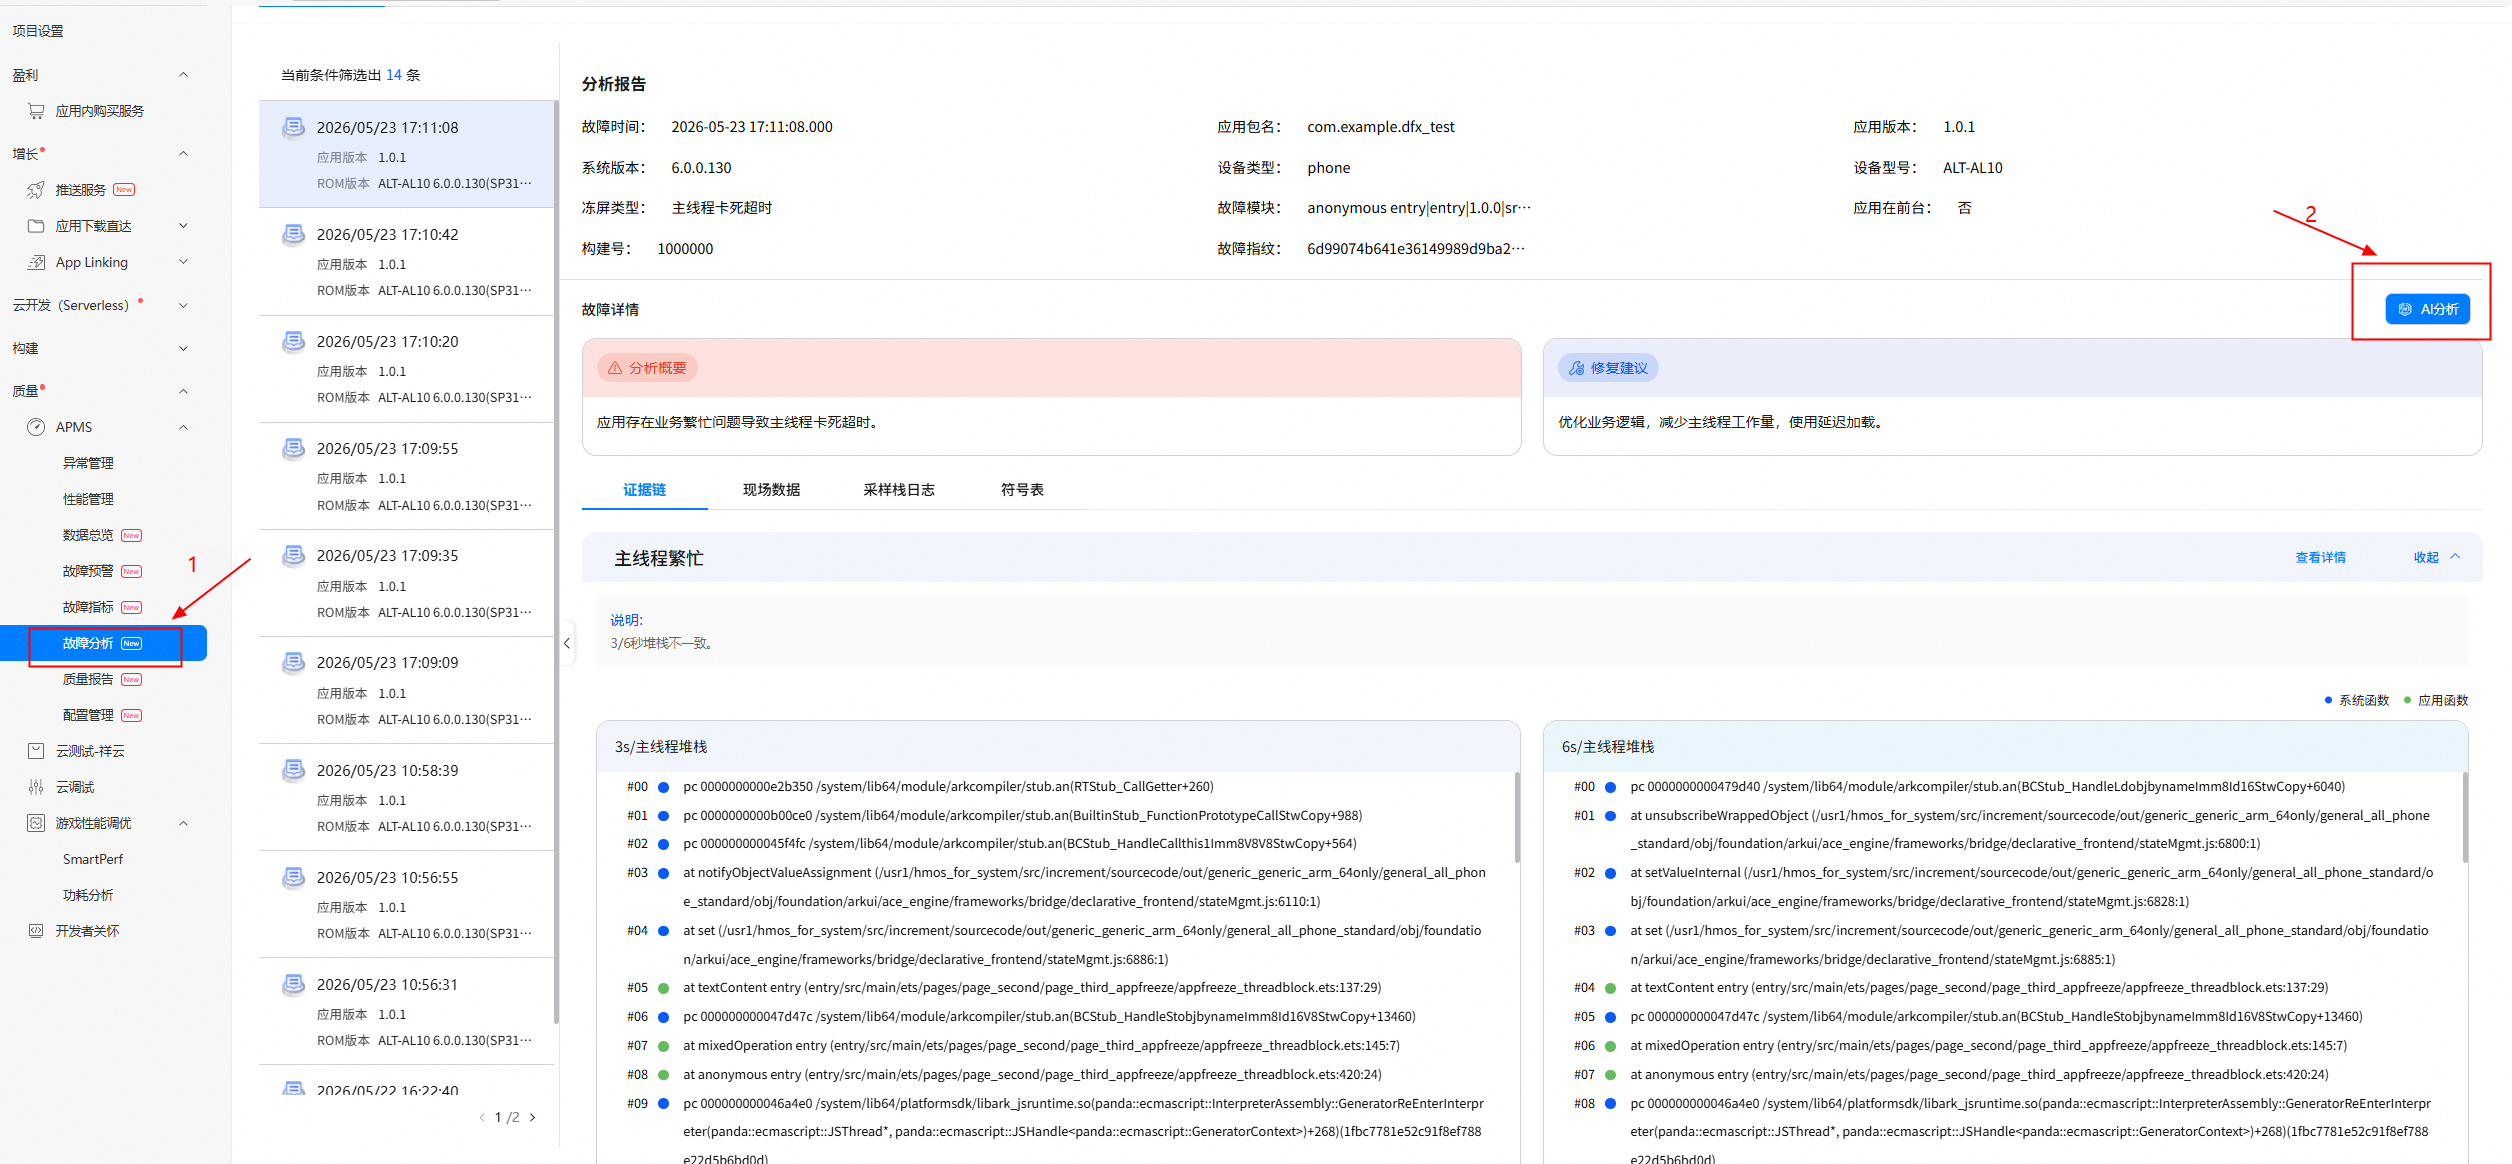
证据链:证据链会展示问题发生的堆栈并标出故障处,同时会说明问题根因的判断依据。
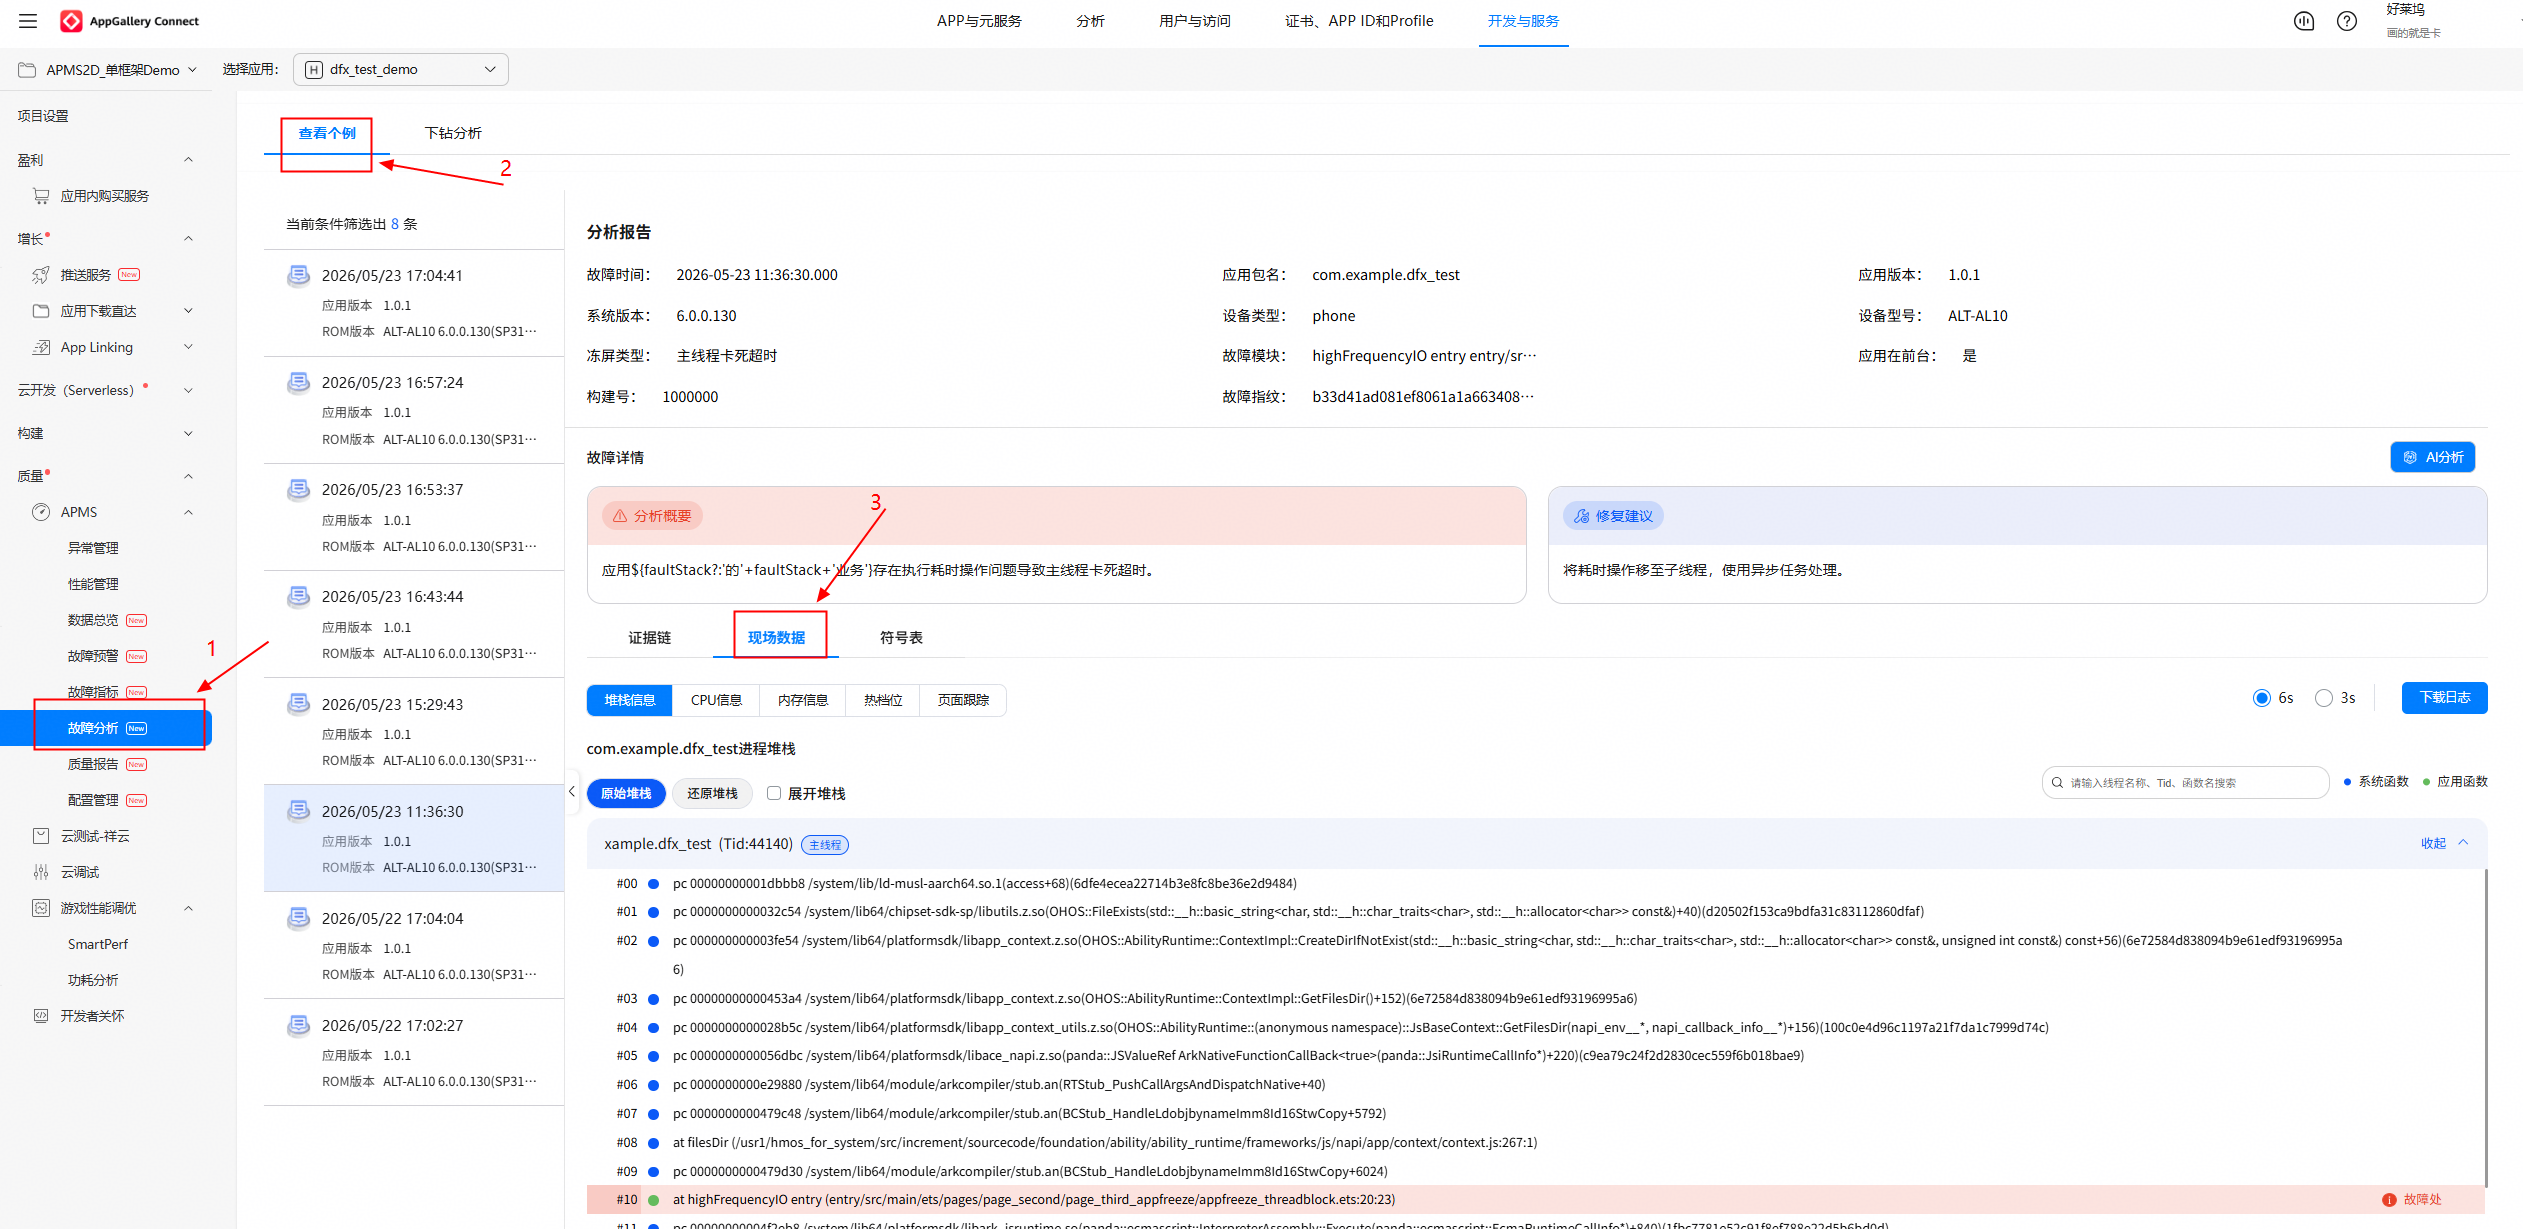
现场数据:现场数据为开发者提供冻屏时刻的完整运行上下文(包含堆栈信息、页面导航轨迹、CPU 信息、内存信息与热档位等),便于精准还原用户操作路径与触发场景。
采样栈还原堆栈:通过上传 SourceMap 或 .so 符号表文件,可将混淆后的堆栈地址还原为可读的代码行号与函数名。
1.2.3.2 下钻分析
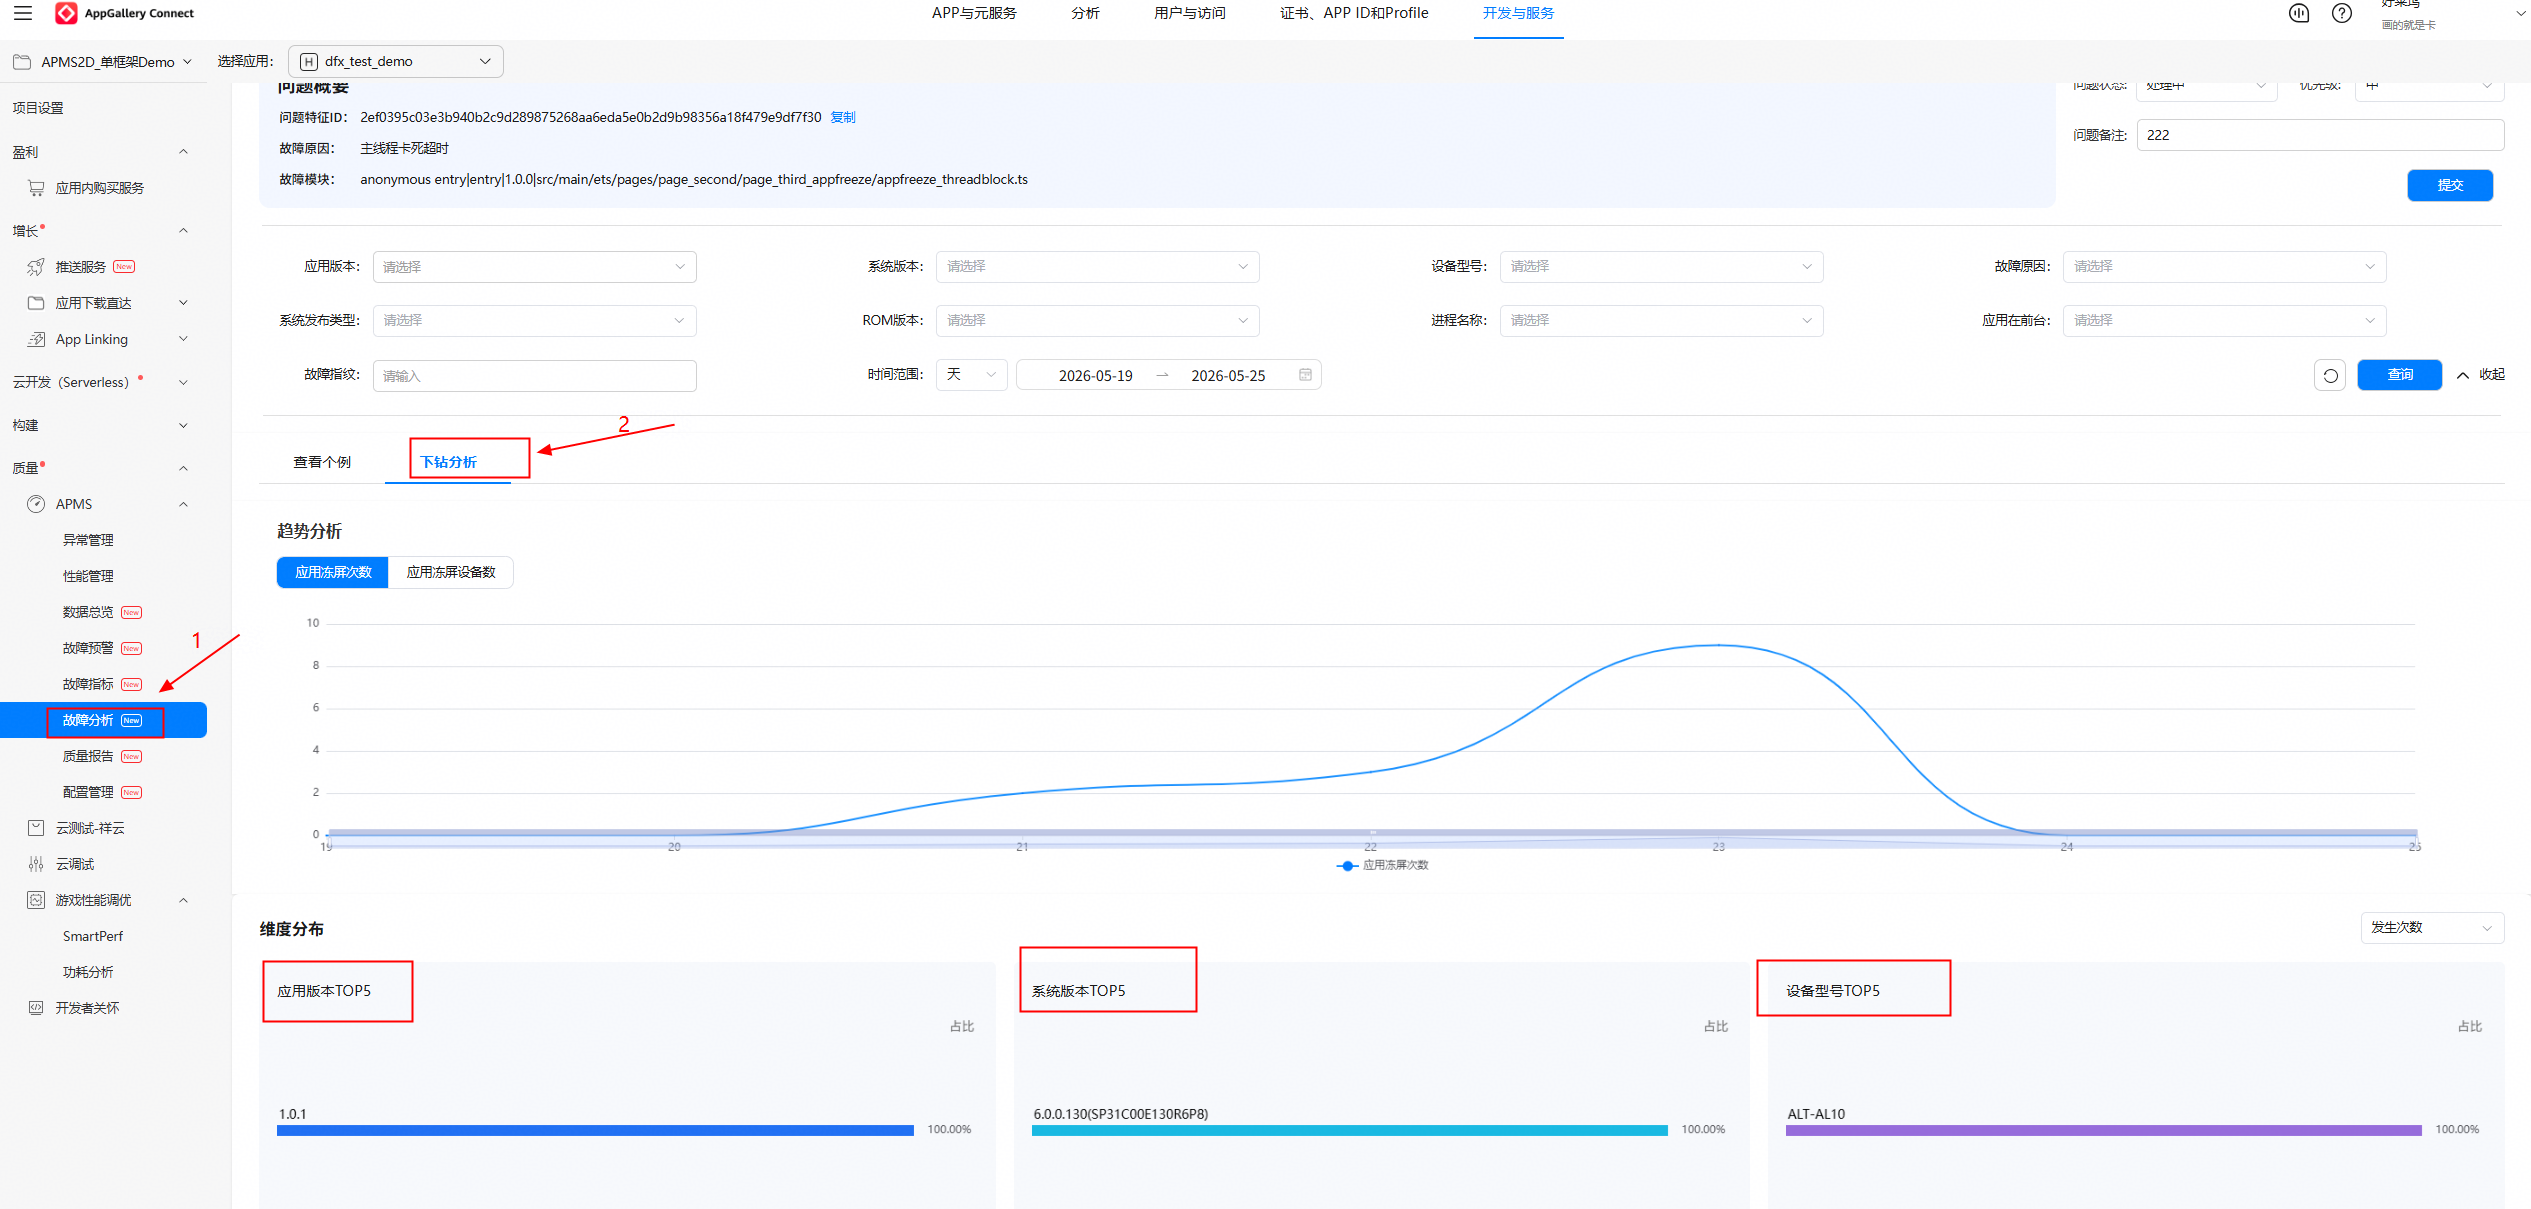
下钻分析的核心逻辑是:一个汇总的指标或表象问题出发,将其拆分成多个组成部分,然后挑出最关键的线索继续向下拆分,不断重复这个过程,直到定位到具体的根因。平台会根据聚类 id 或 pathname(函数/so 路径名称)进行聚类并筛选 top 应用版本,系统版本以及设备型号。开发者可根据此重点关注问题高发的版本及设备,更精确的定位问题。
1.2.3.3 AI 分析
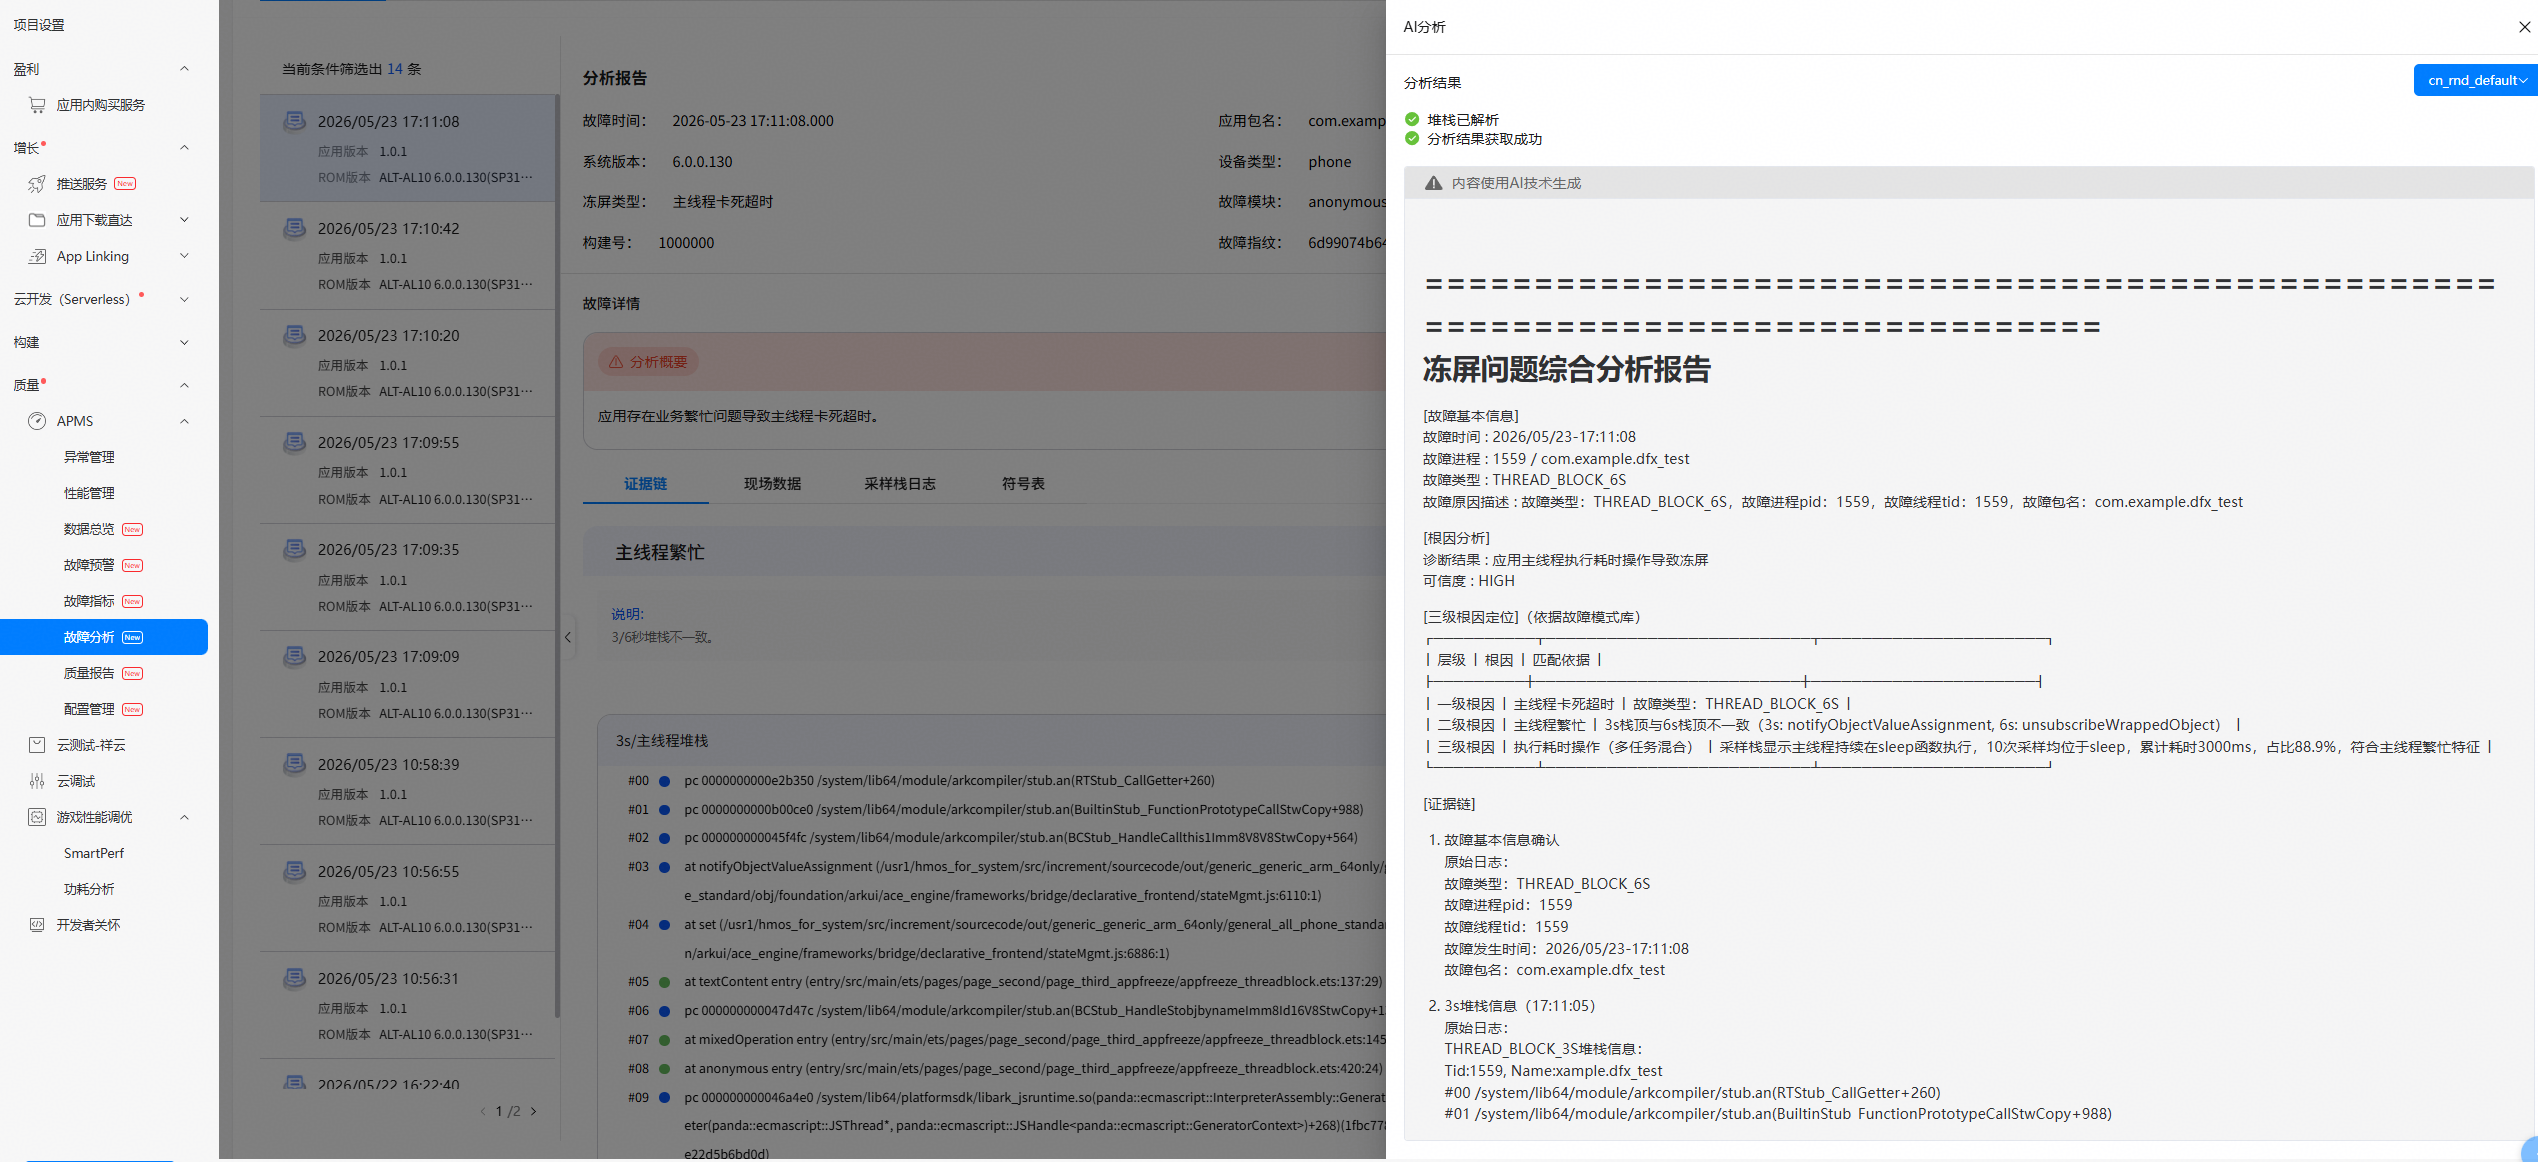
平台提供了 AI 分析日志的功能,会解析问题堆栈,并给出问题根因以及修复建议,协助开发者处理问题。
1.2.4 修复建议验证与闭环
1.2.4.1 修复建议
故障详情页面会给到修复建议,开发者可以通过给出的建议优化代码。
1.2.4.2 修复建议与闭环
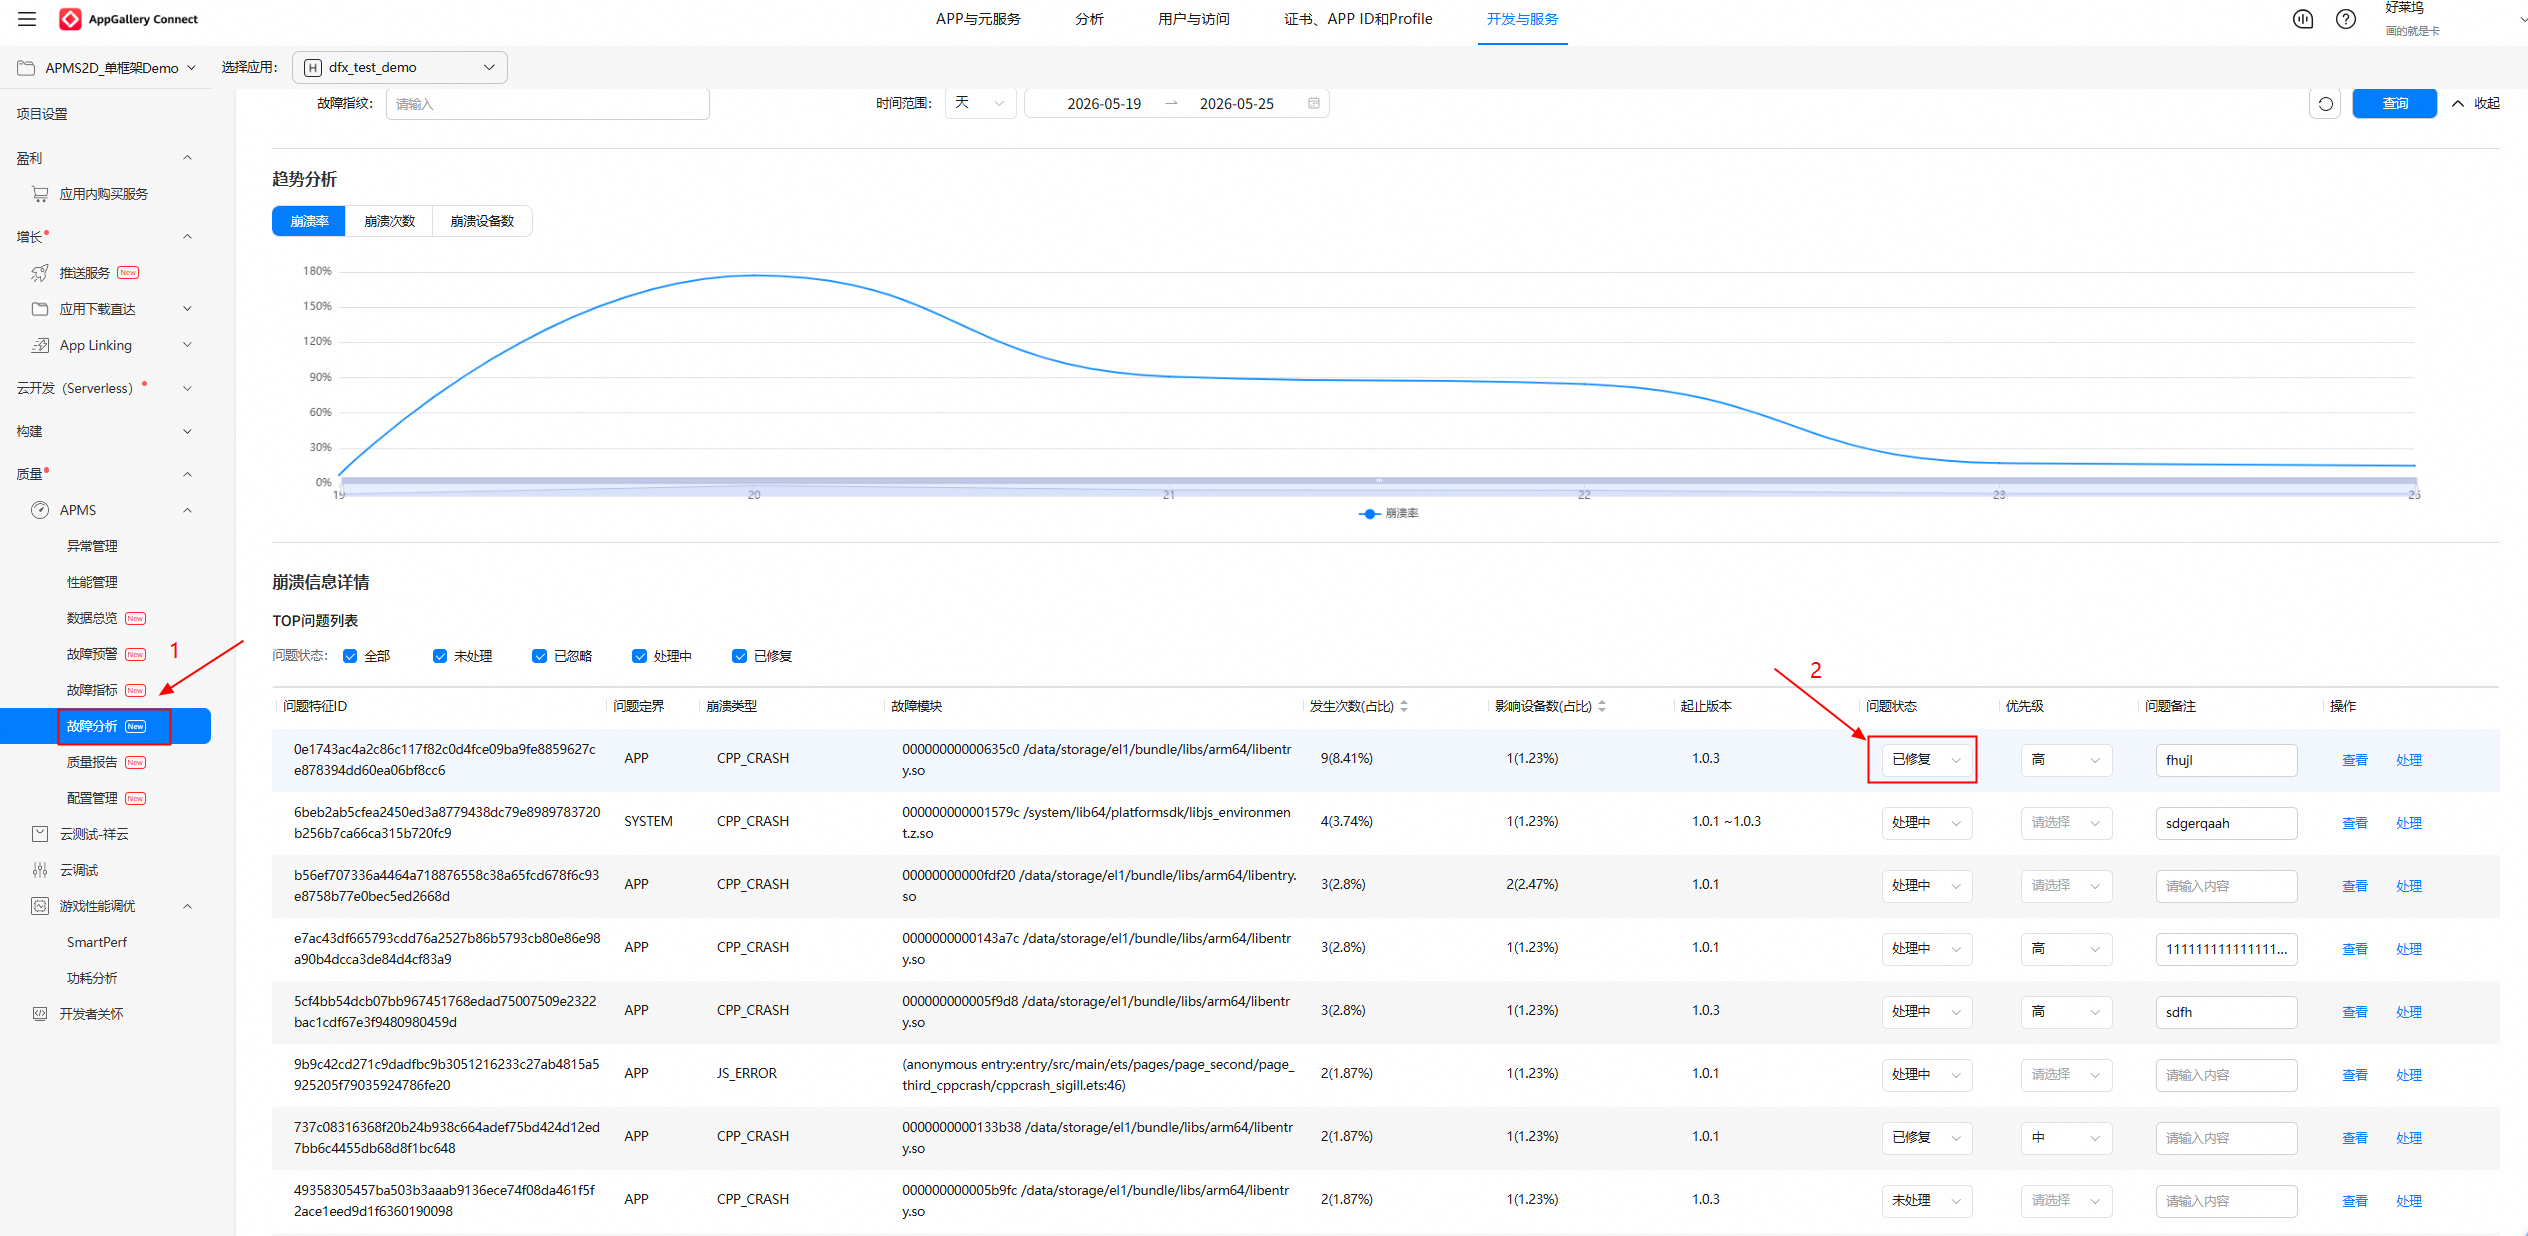
(1)修改问题之后,可以在分析页面的问题列表中,将对应的问题处标记已修改,并关注新版本的冻屏数据。
(2)对比修复前后的问题发生率,确认修复是否有效。
1.2.5 基于 Operation Analyzer 平台分析
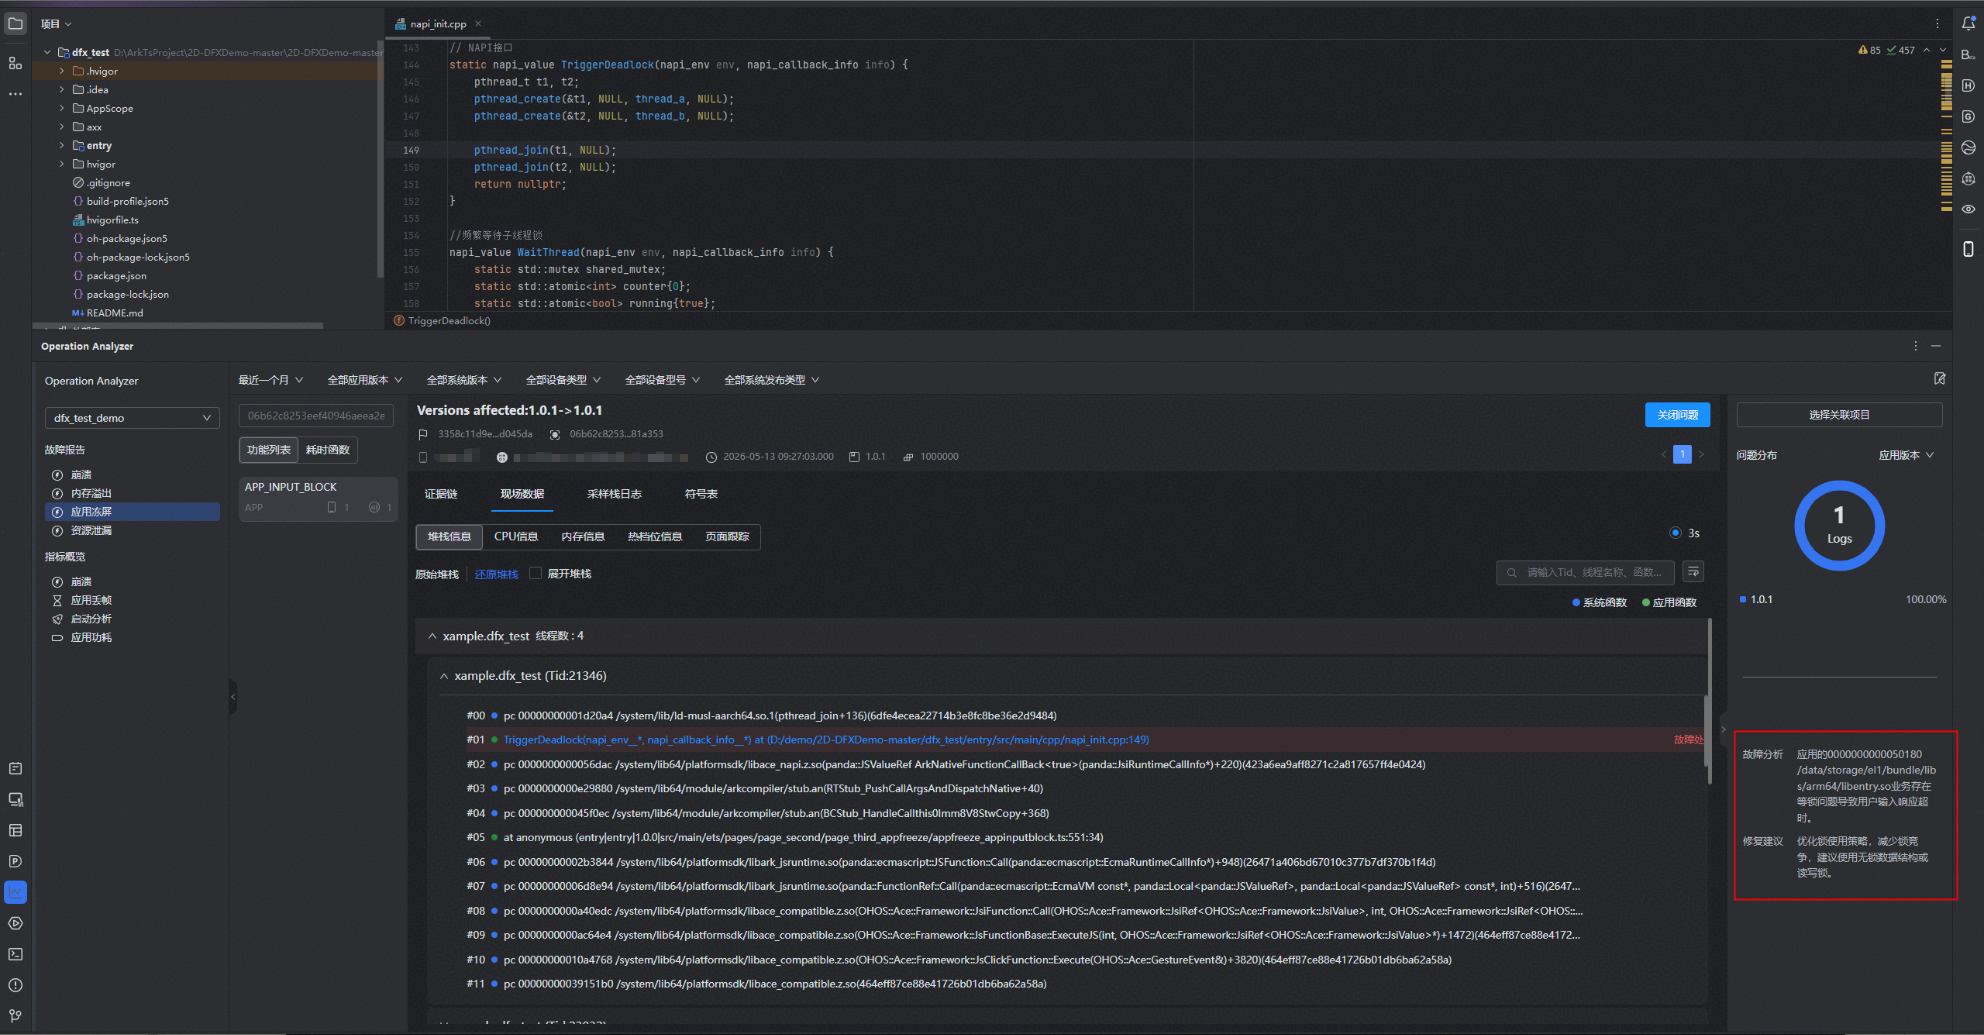
Operation Analyzer 平台是指 IDE 的 Operation Analyzer 插件。在 IDE 上可以通过此插件查看到应用对应的故障数据,数据和 APMS 平台上一致。
1.2.5.1 Operation Analyzer 平台入口
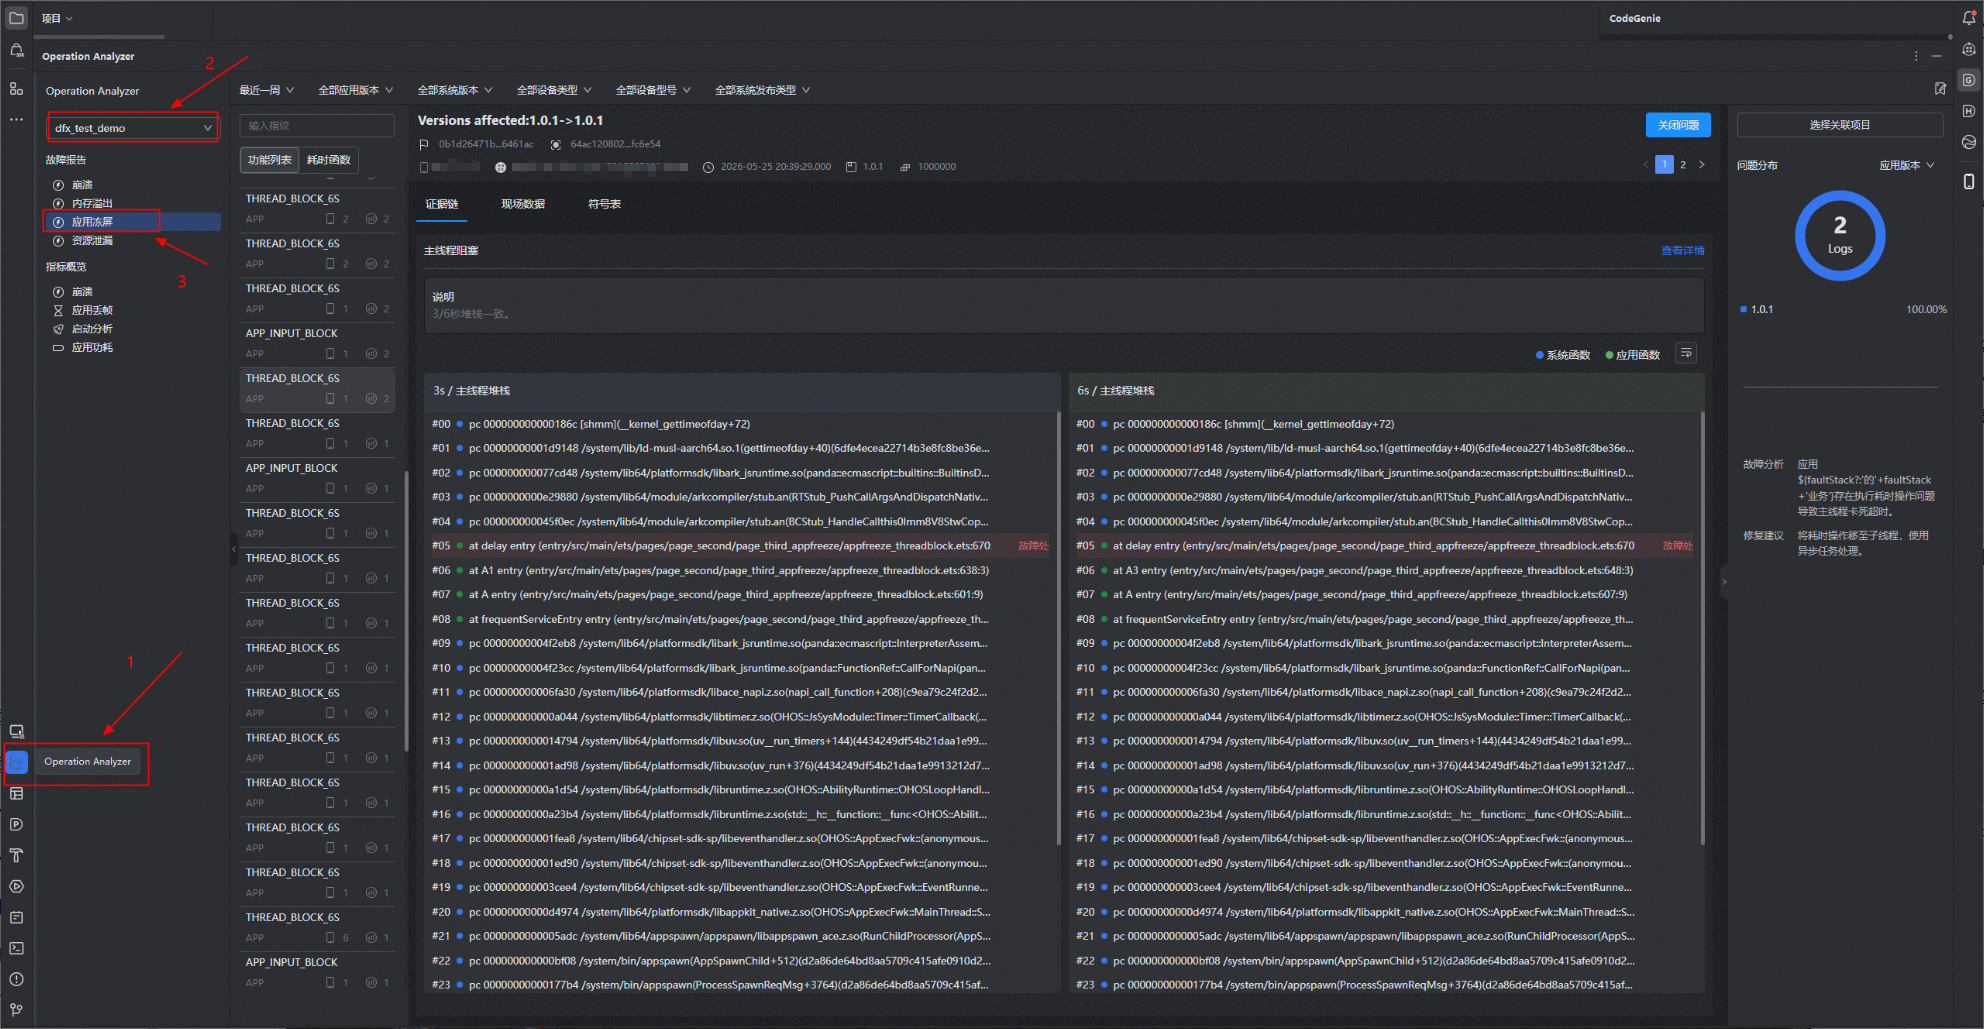
打开 DevEco 后,在左侧可看到 Operation Analyzer 图标,点击后选择应用,再点击应用冻屏即可查看该类故障数据。
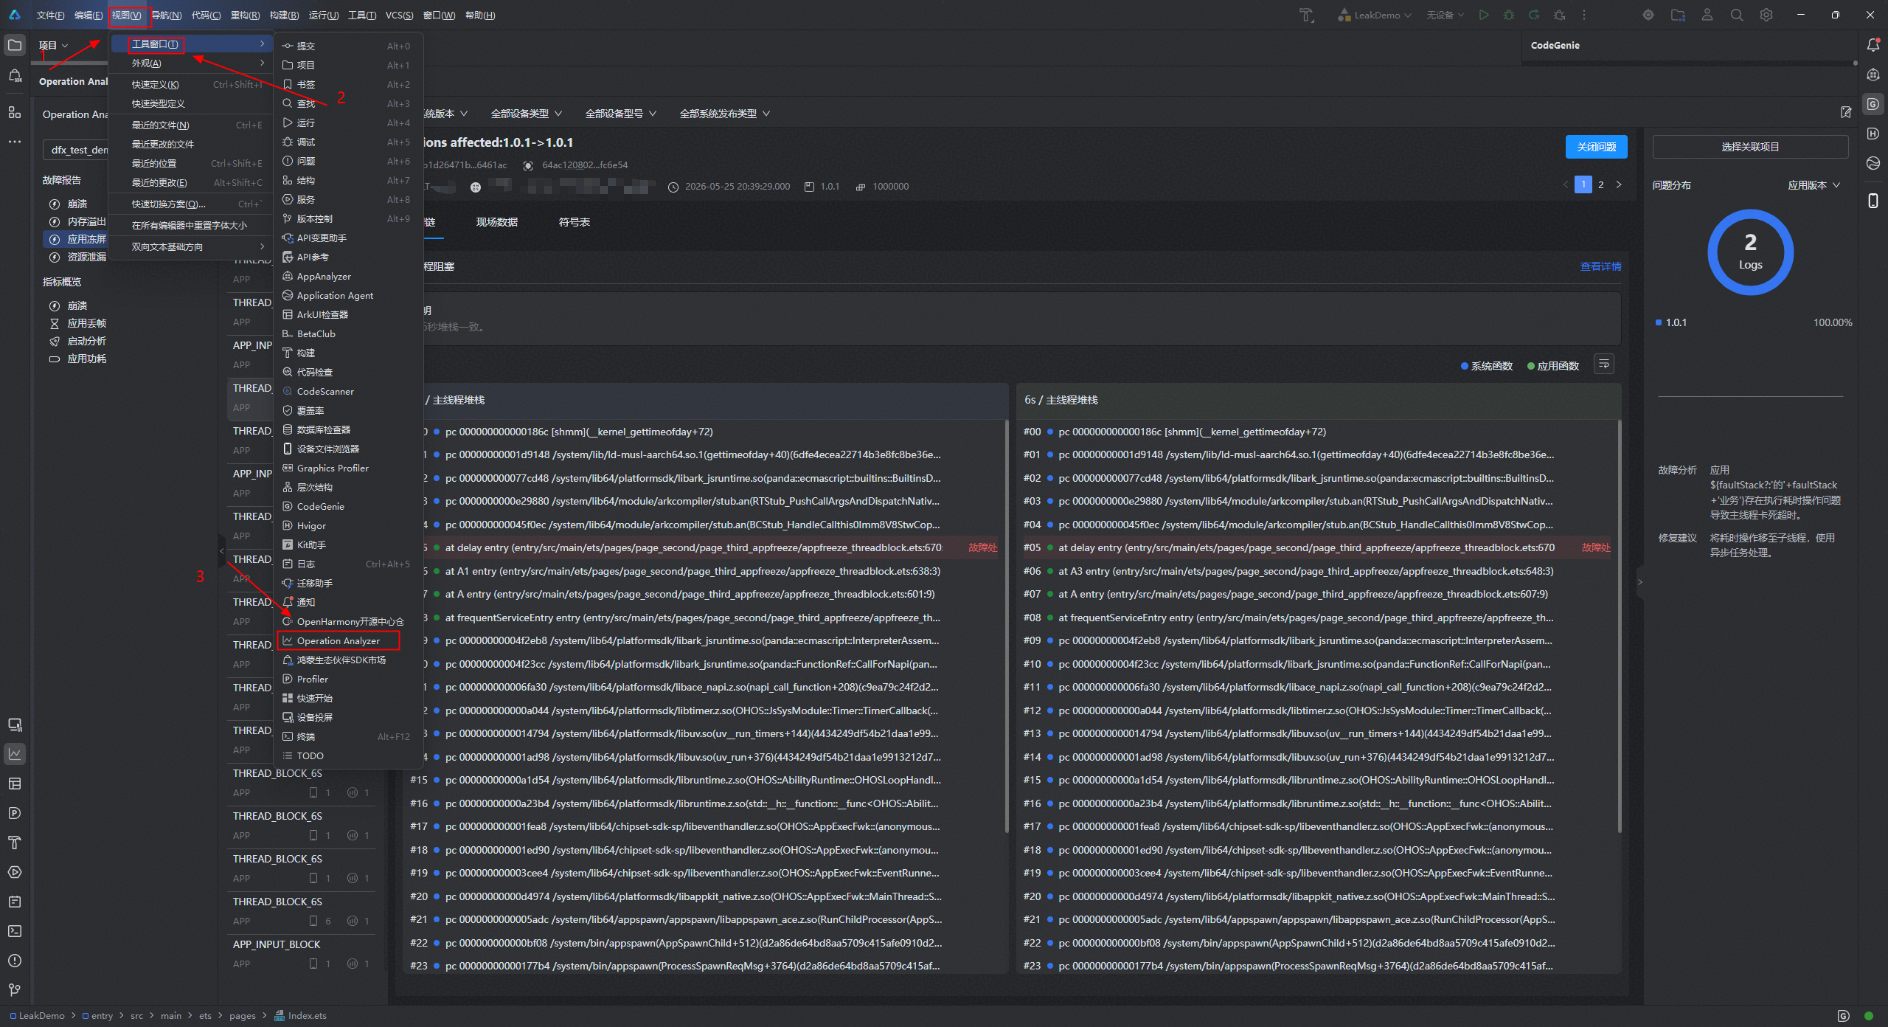
如果左侧没有出现 Operation Analyzer 平台图标,也可通过上方导航栏的视图窗口进入。
1.2.5.2 问题分析
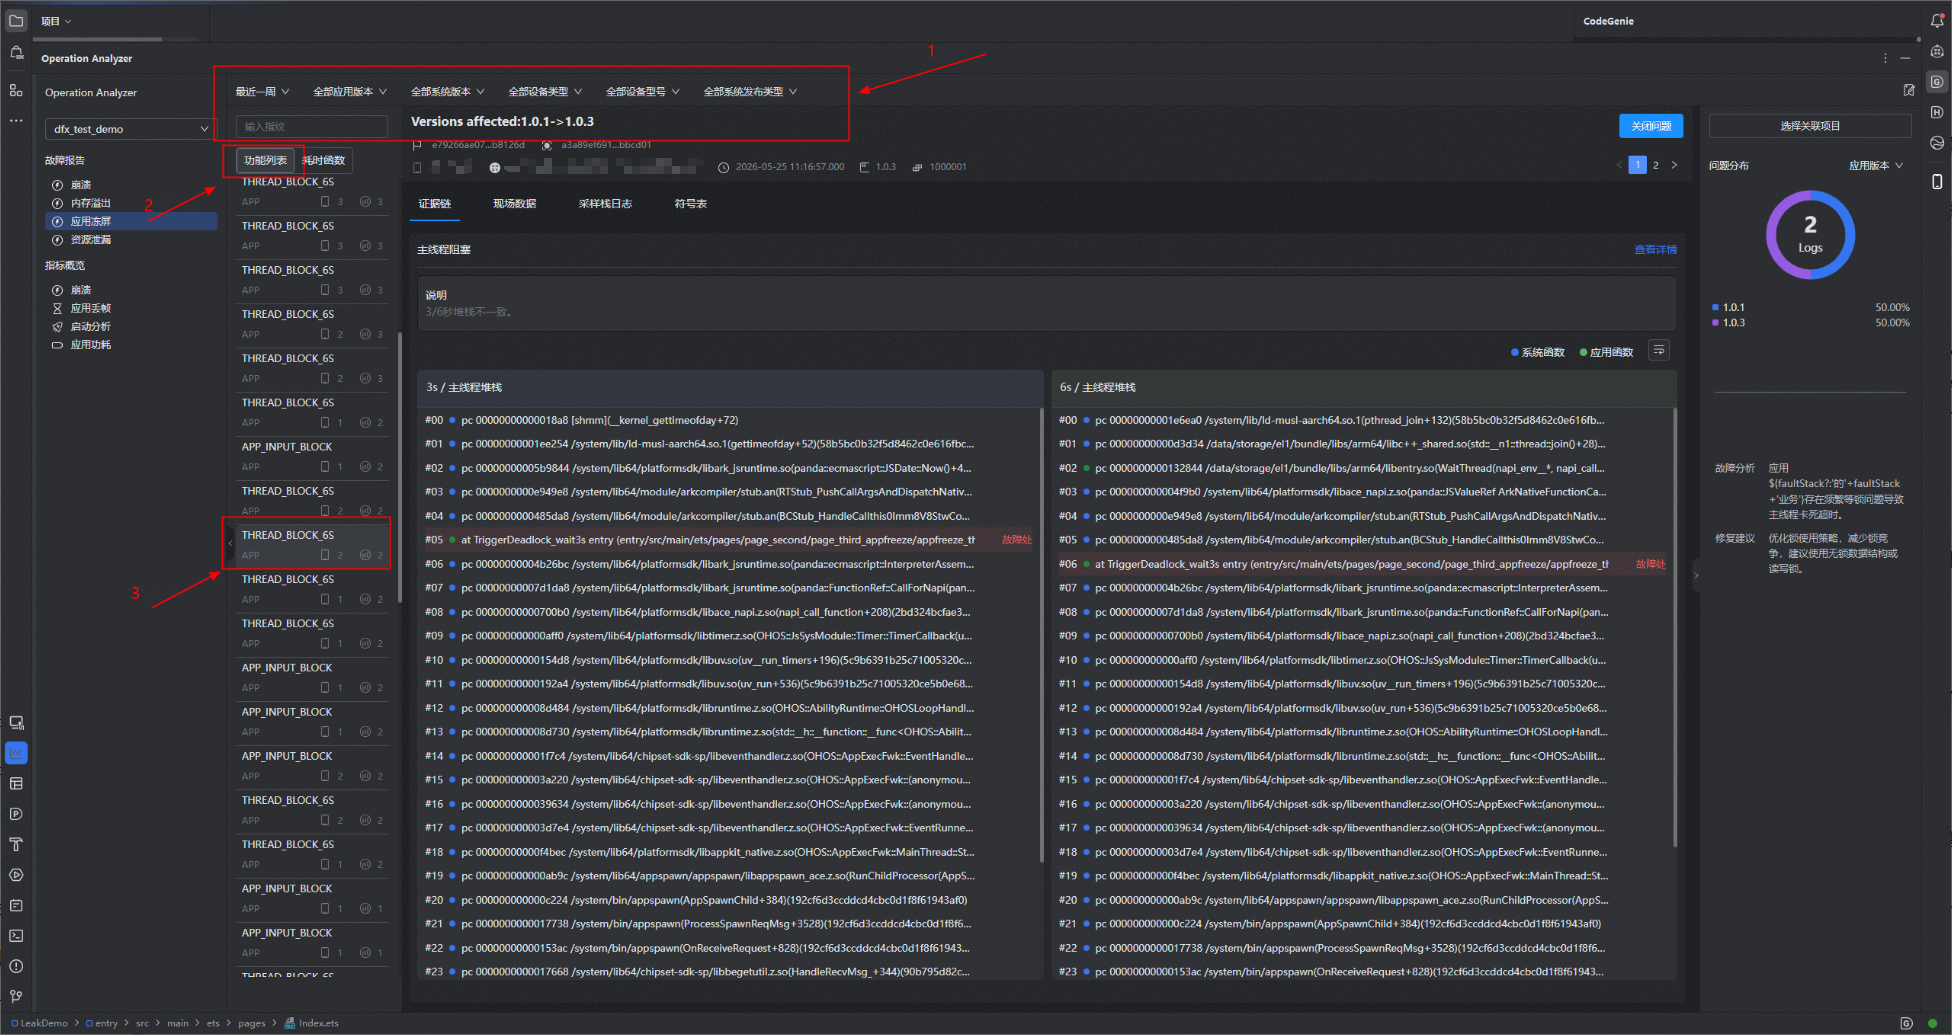
Operation Analyzer 平台问题查看:
开发者可自定义筛选条件筛选需要查看的问题,可点击功能列表下具体的问题进一步查看问题详情。
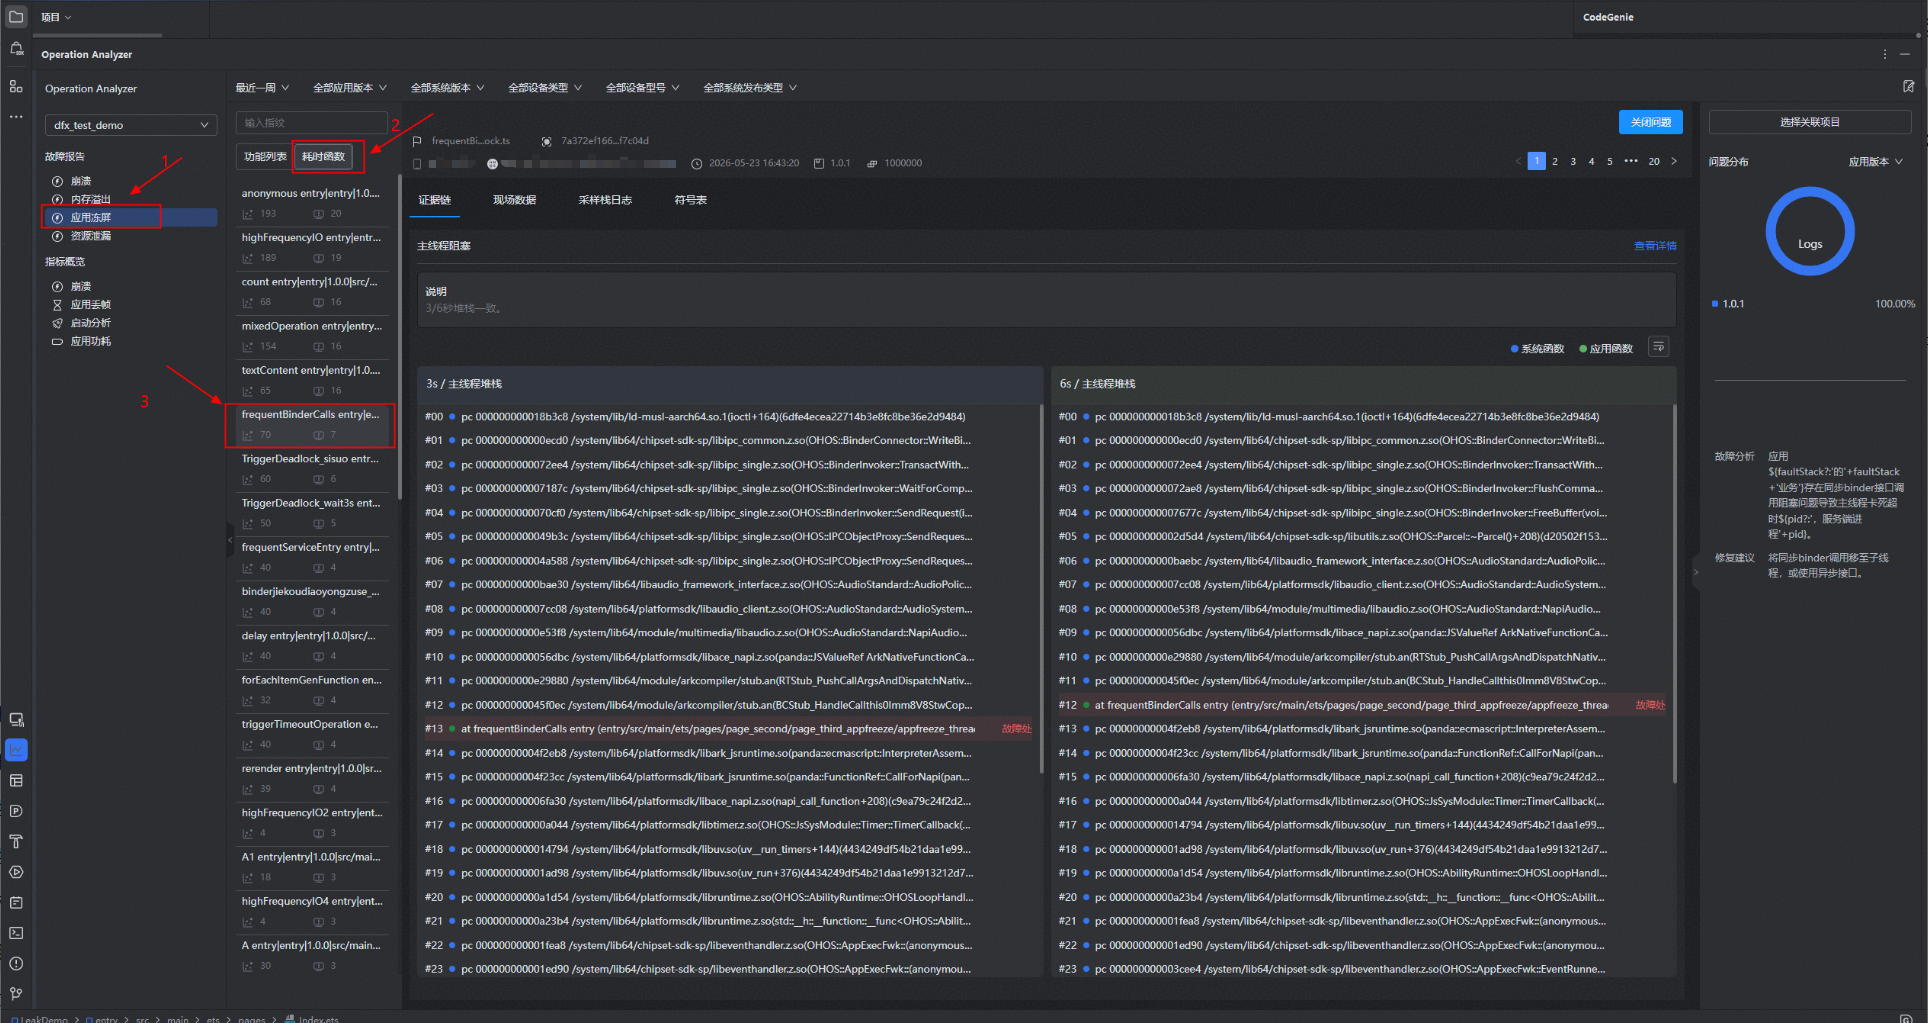
开发者也可以点击耗时函数列表,然后点击具体的耗时函数,进一步查看问题详情。
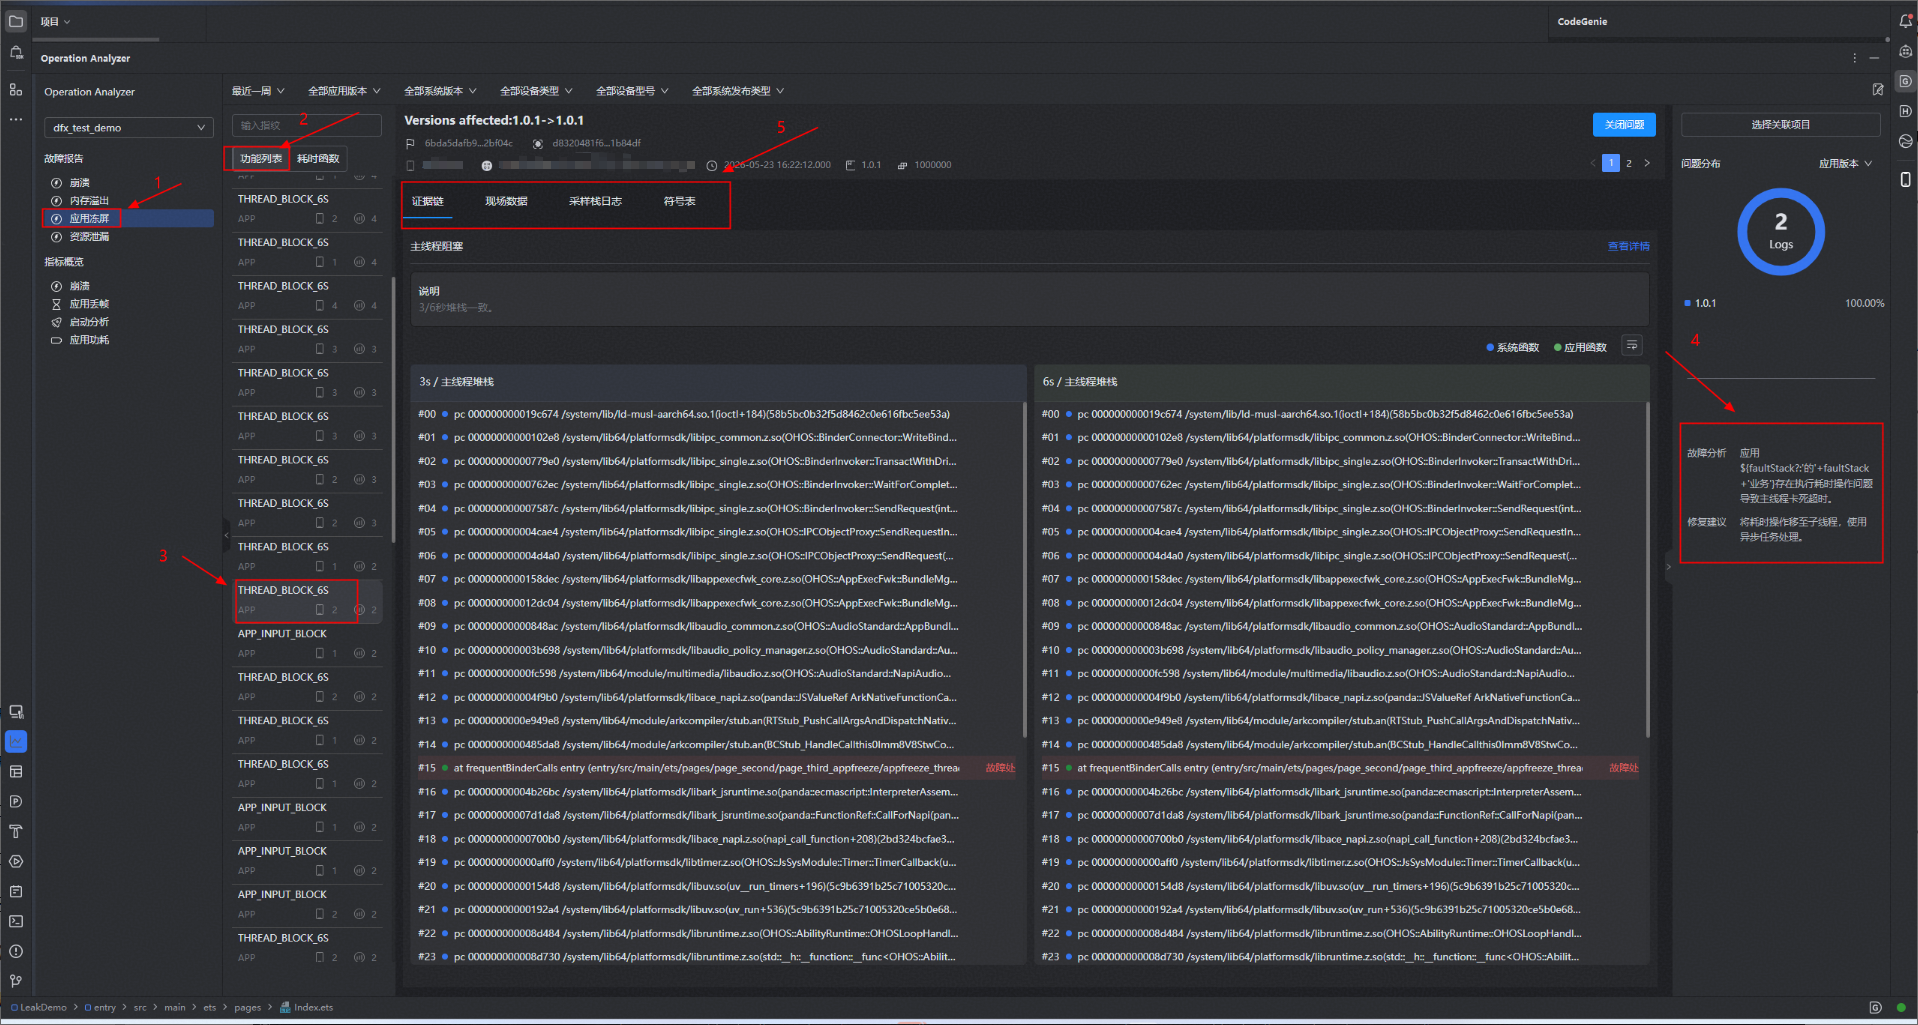
Operation Analyzer 平台问题详情:
平台的问题详情页同 APMS 平台功能相同,开发者可查看故障分析与修复建议排查问题。如果修复建议不能支撑解决,可近一步查看证据链、现场数据、采样栈日志进行具体分析。
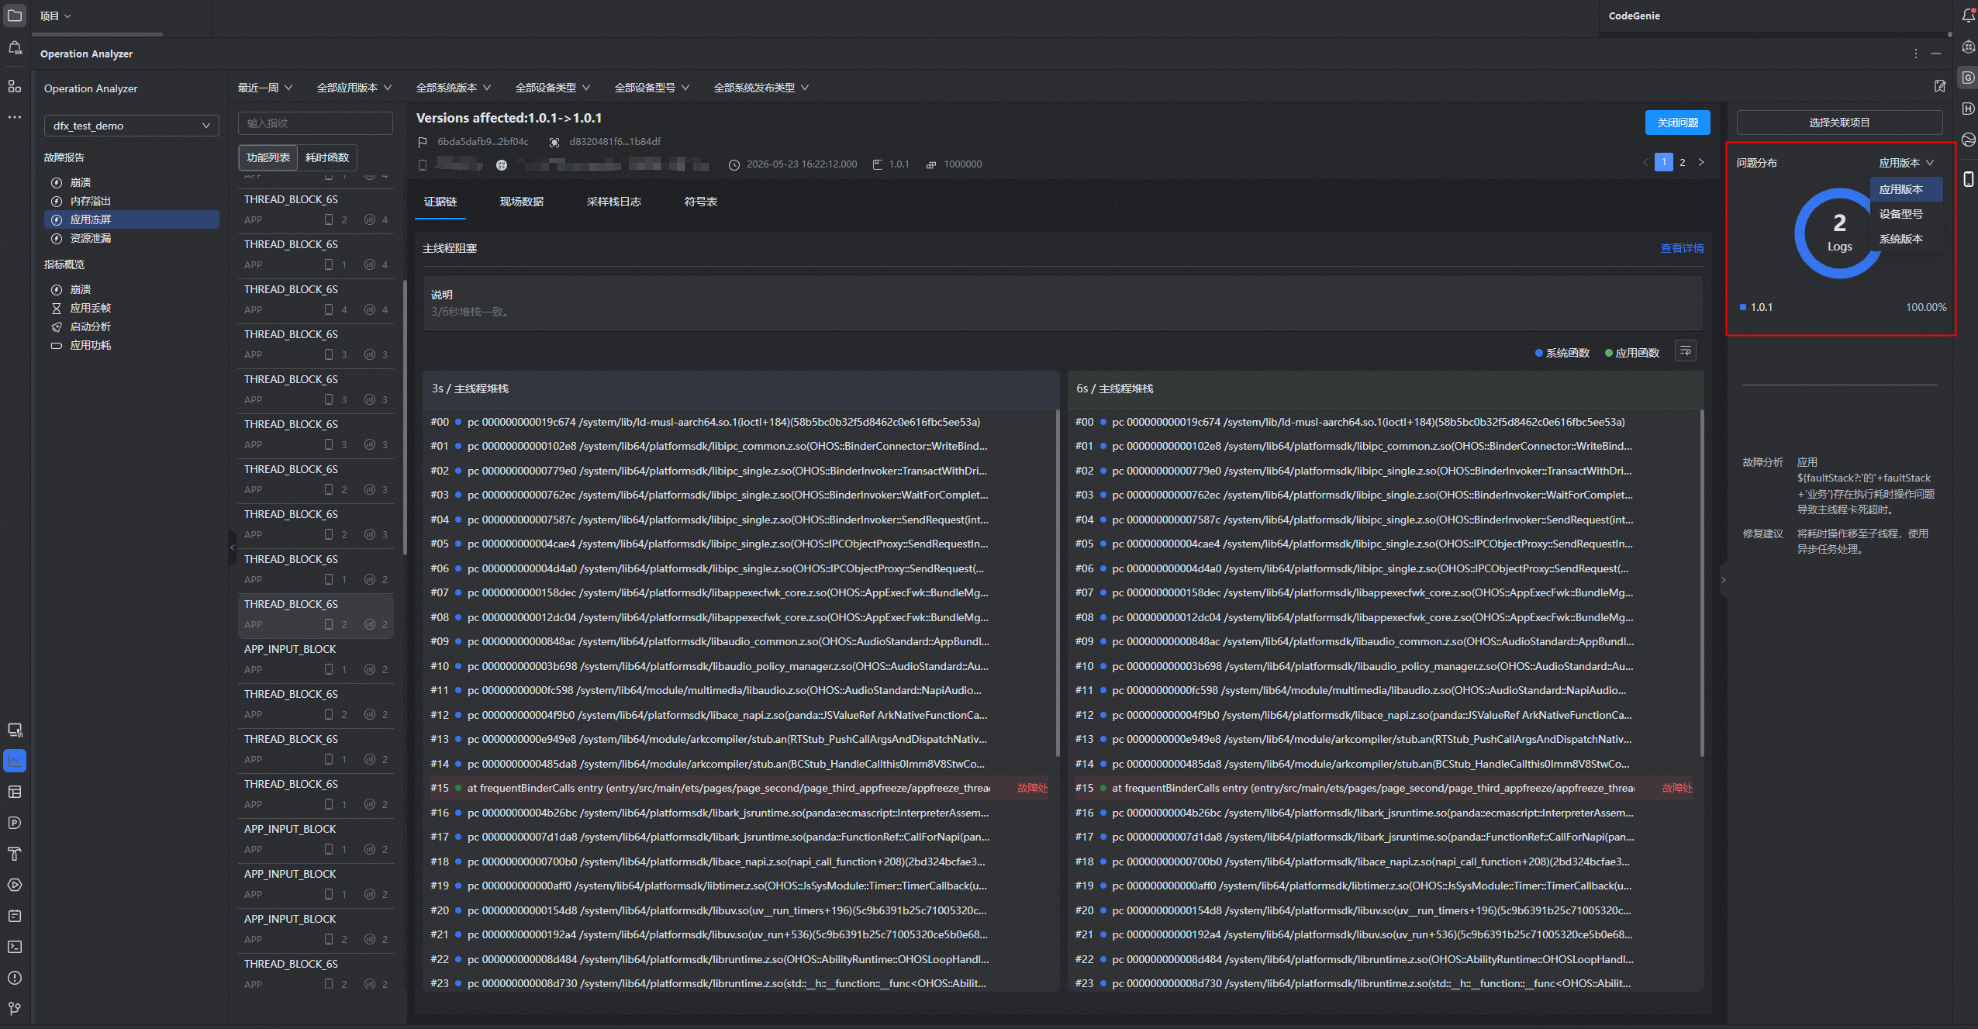
开发者也可以查看问题分布图表,定位问题高发的应用版本、设备型号与系统版本,辅助进一步分析。
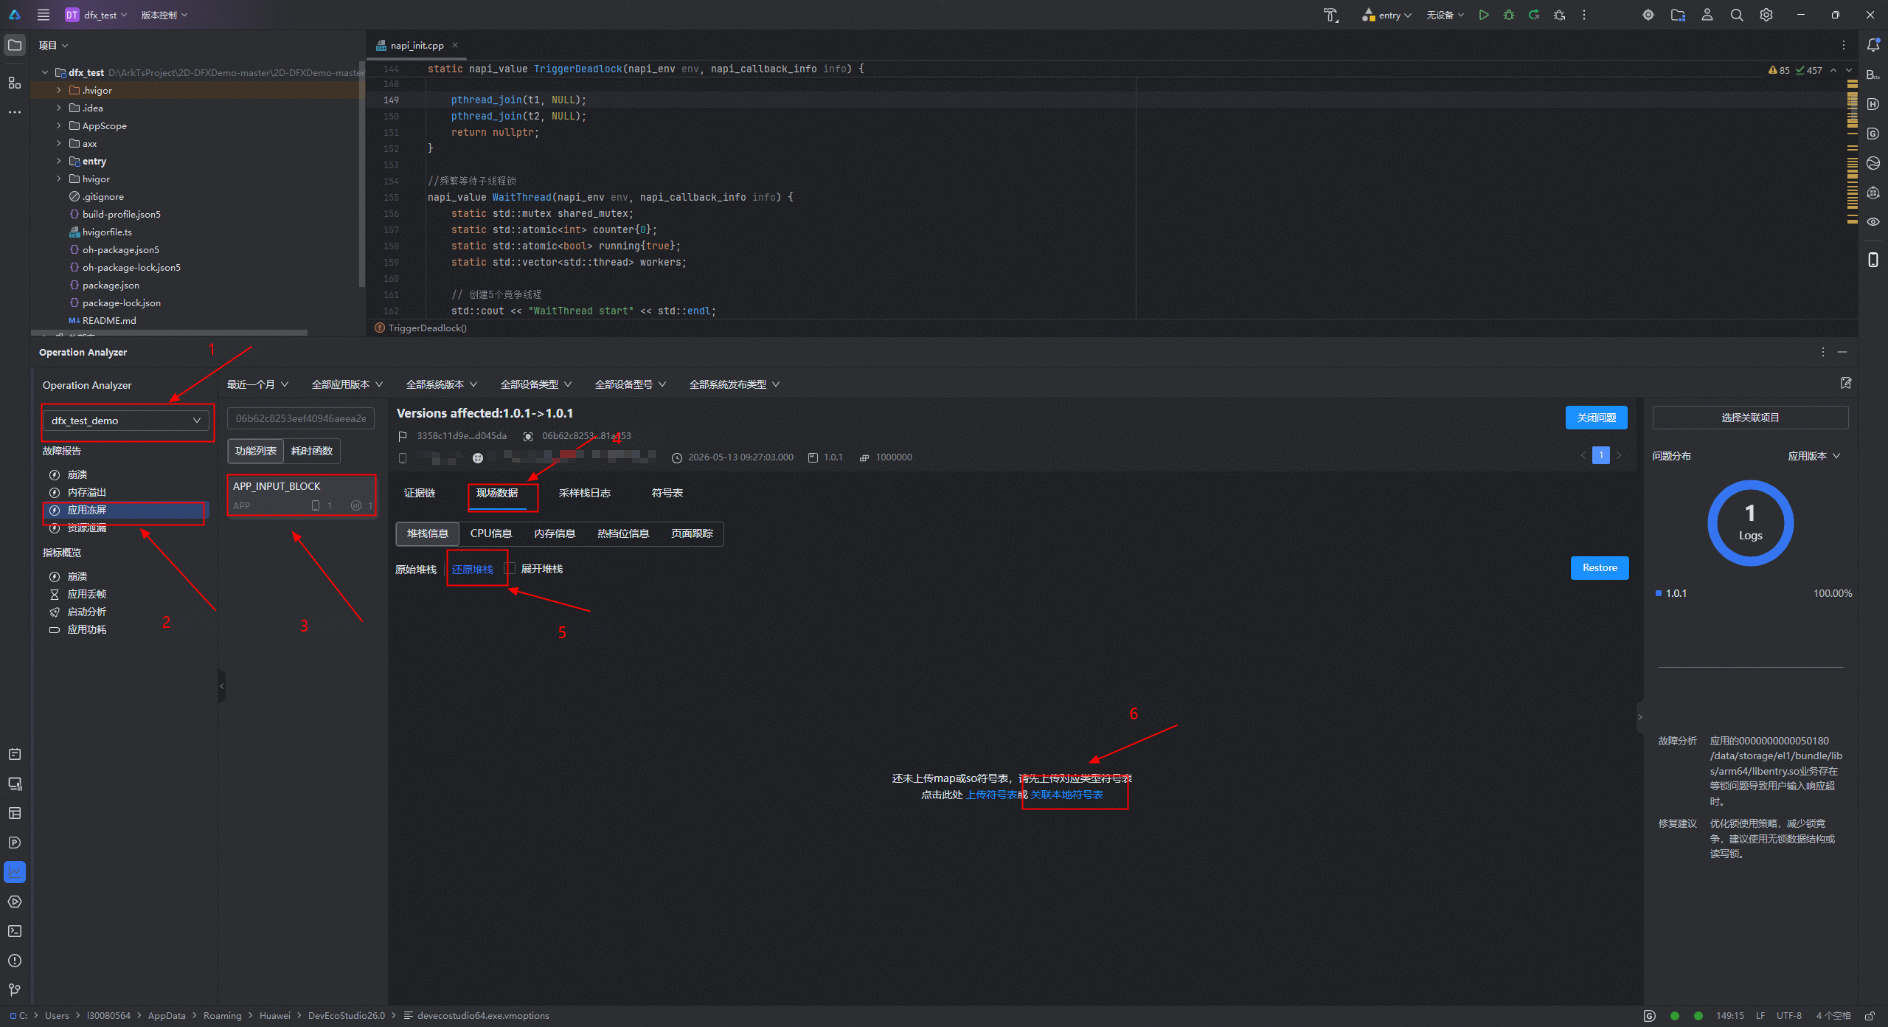
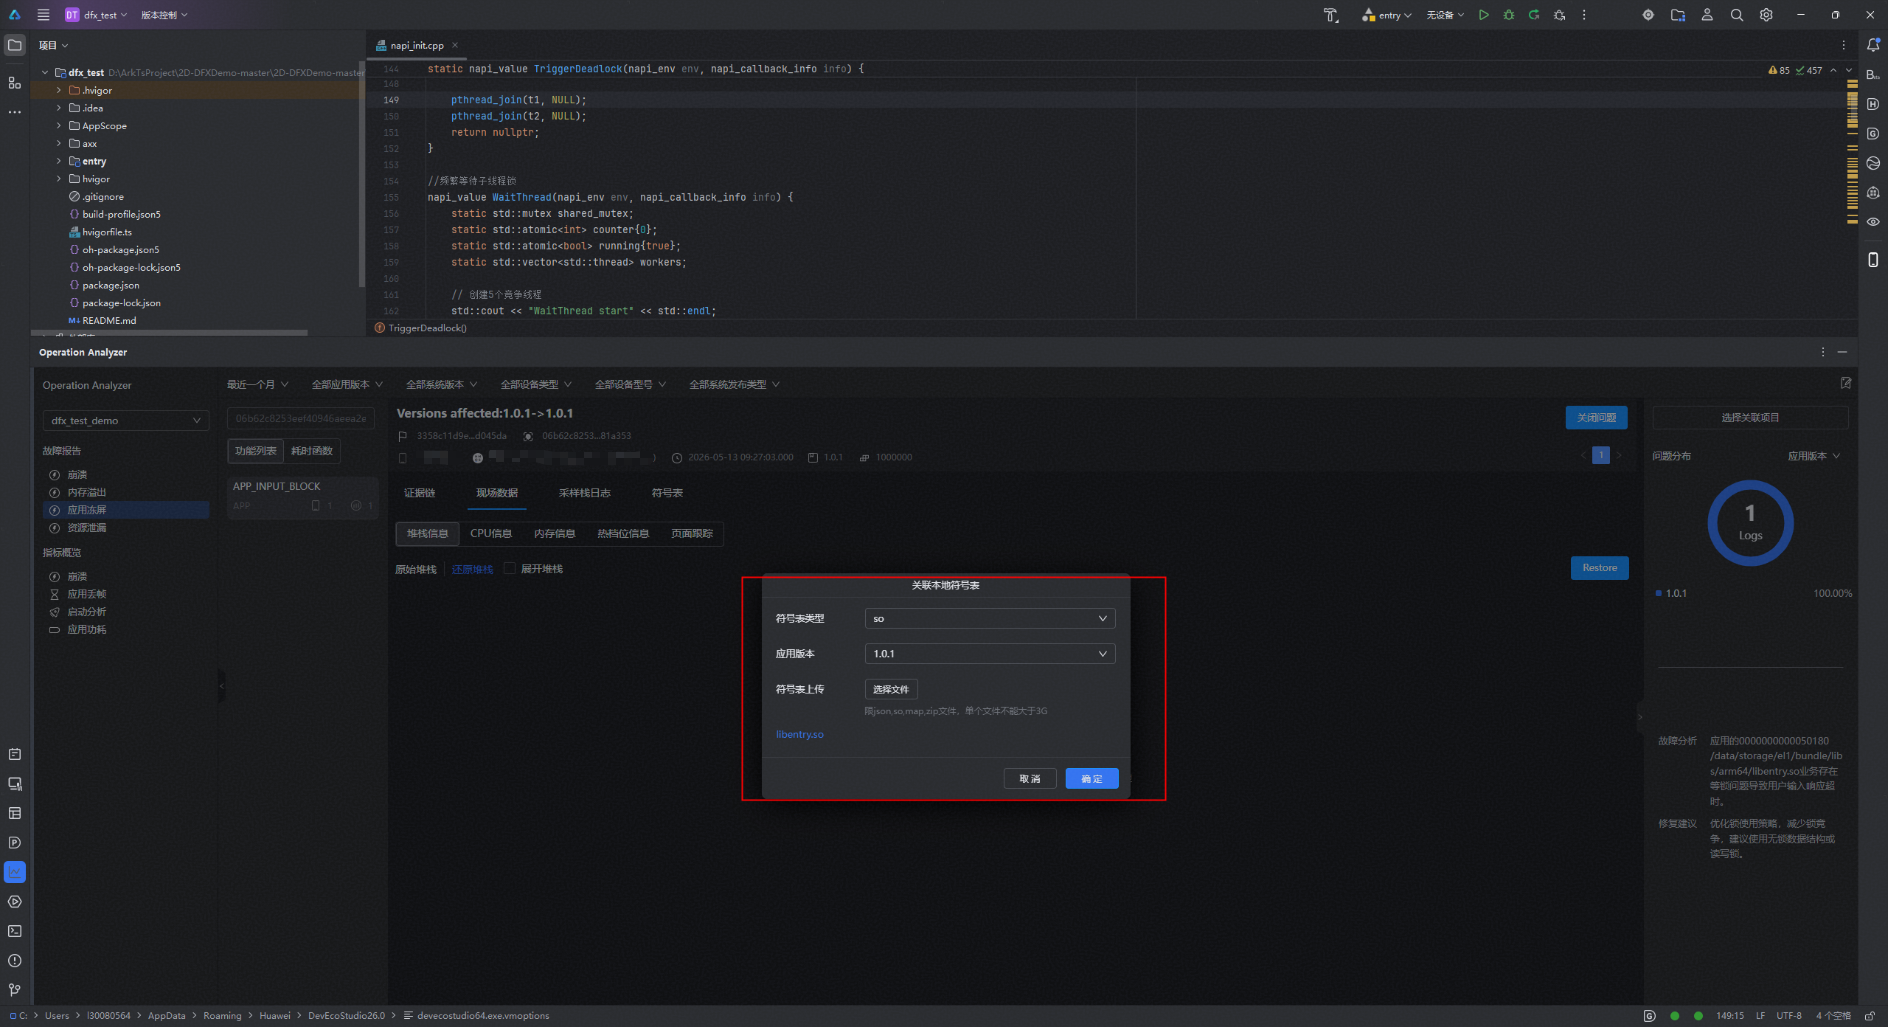
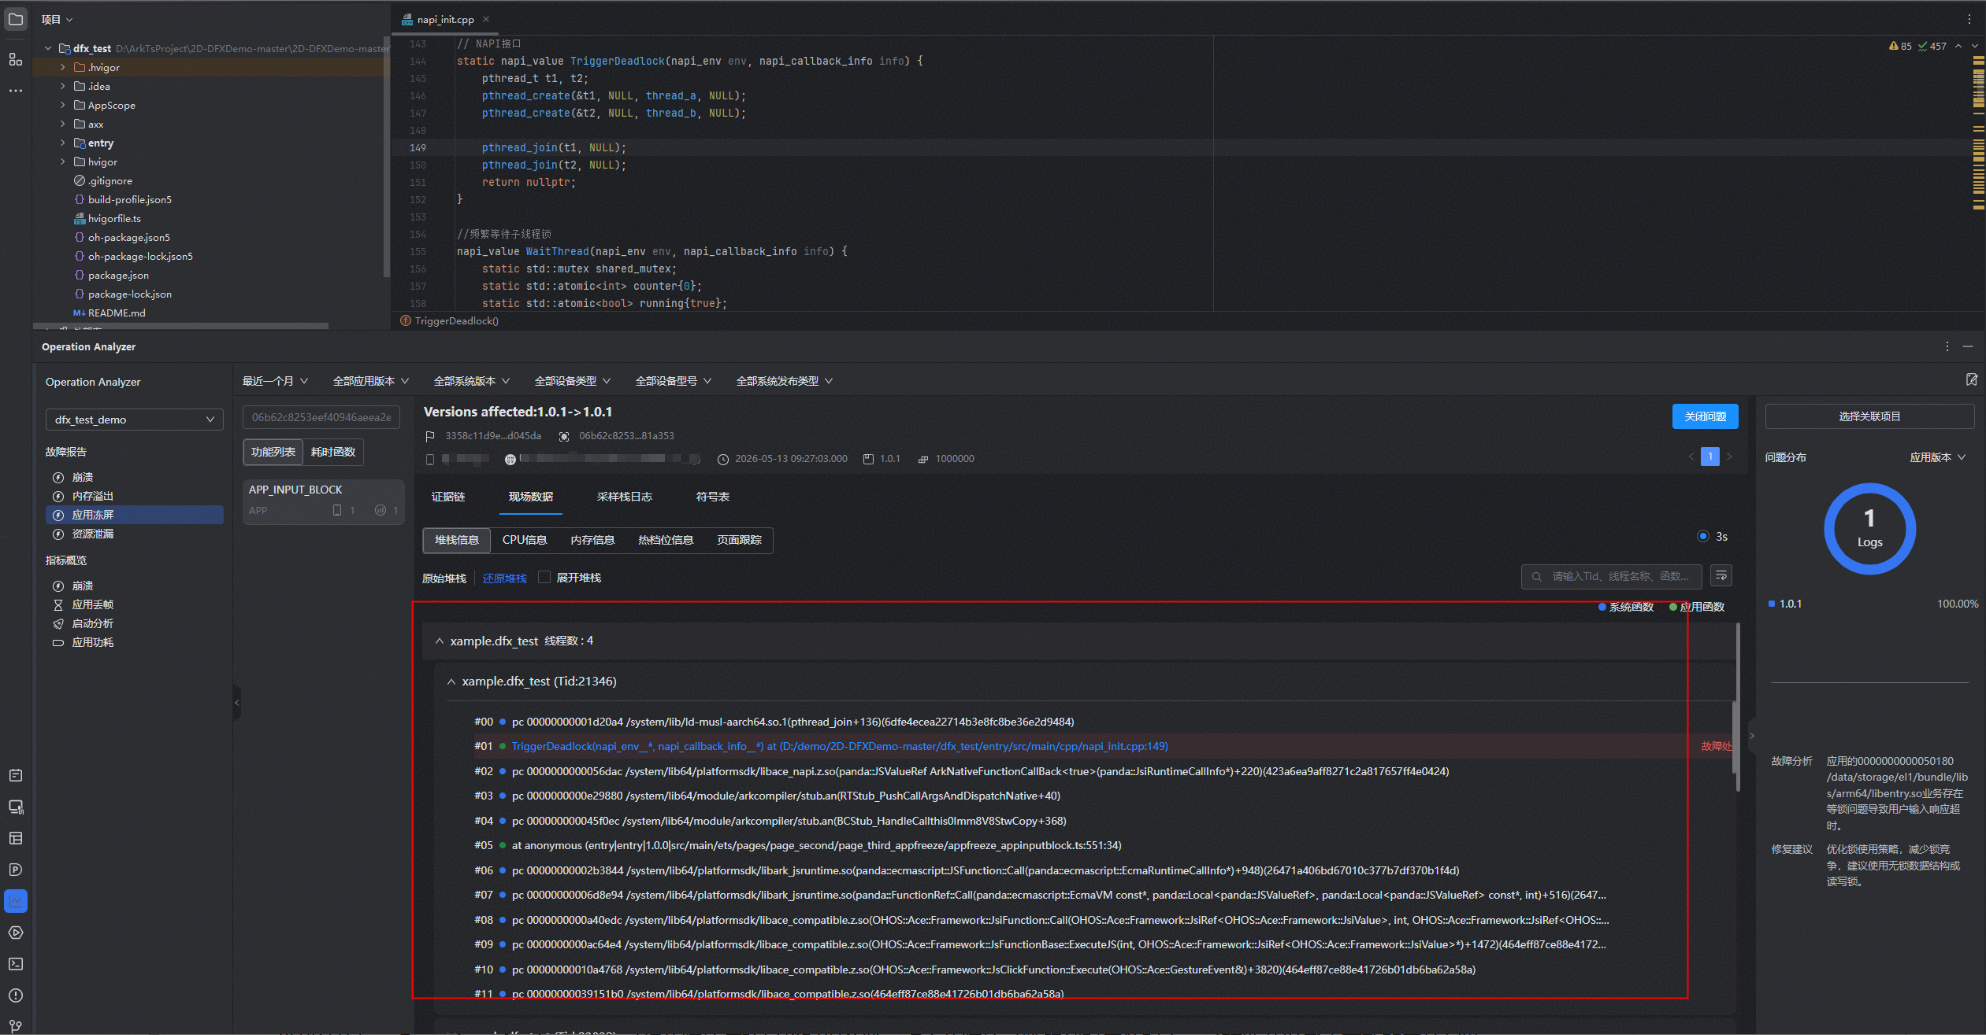
Operation Analyzer 关联离线符号表:
Operation Analyzer 平台提供了堆栈还原的能力,可以通过上传符号表(.so/.map/.json 文件)完成堆栈还原,辅助分析问题。
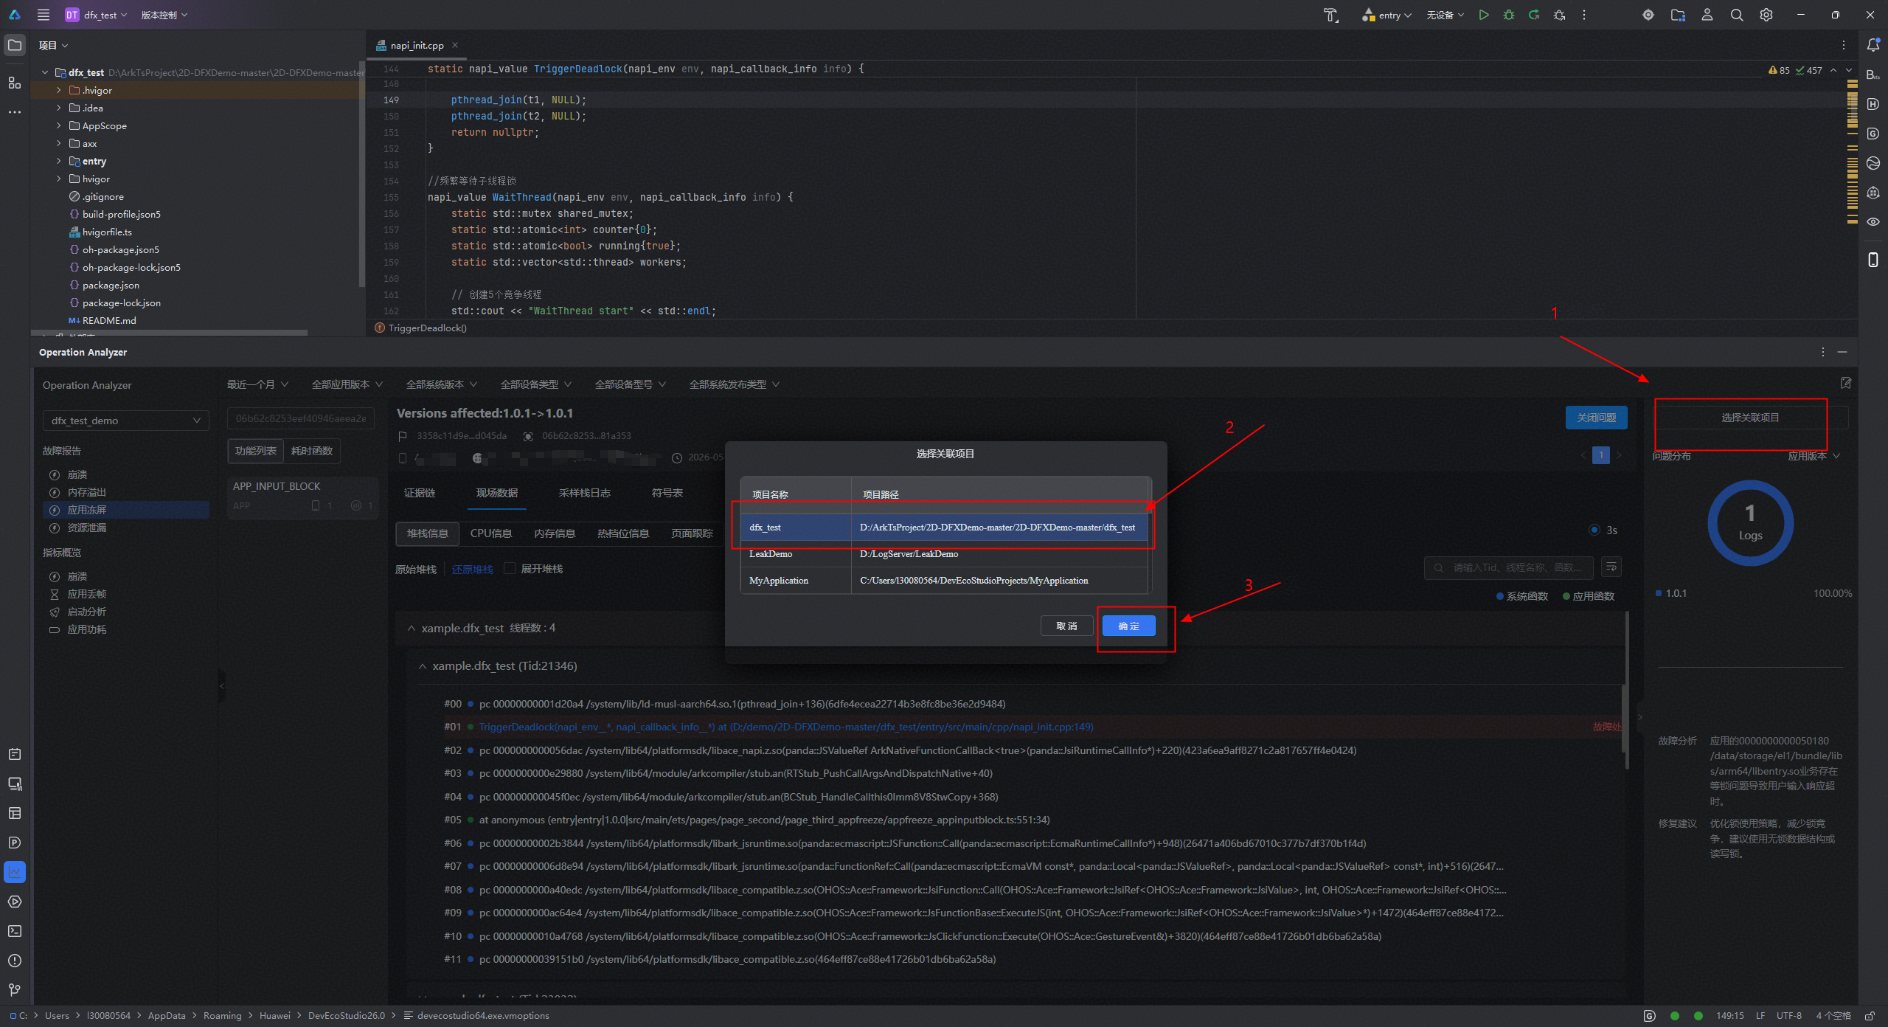
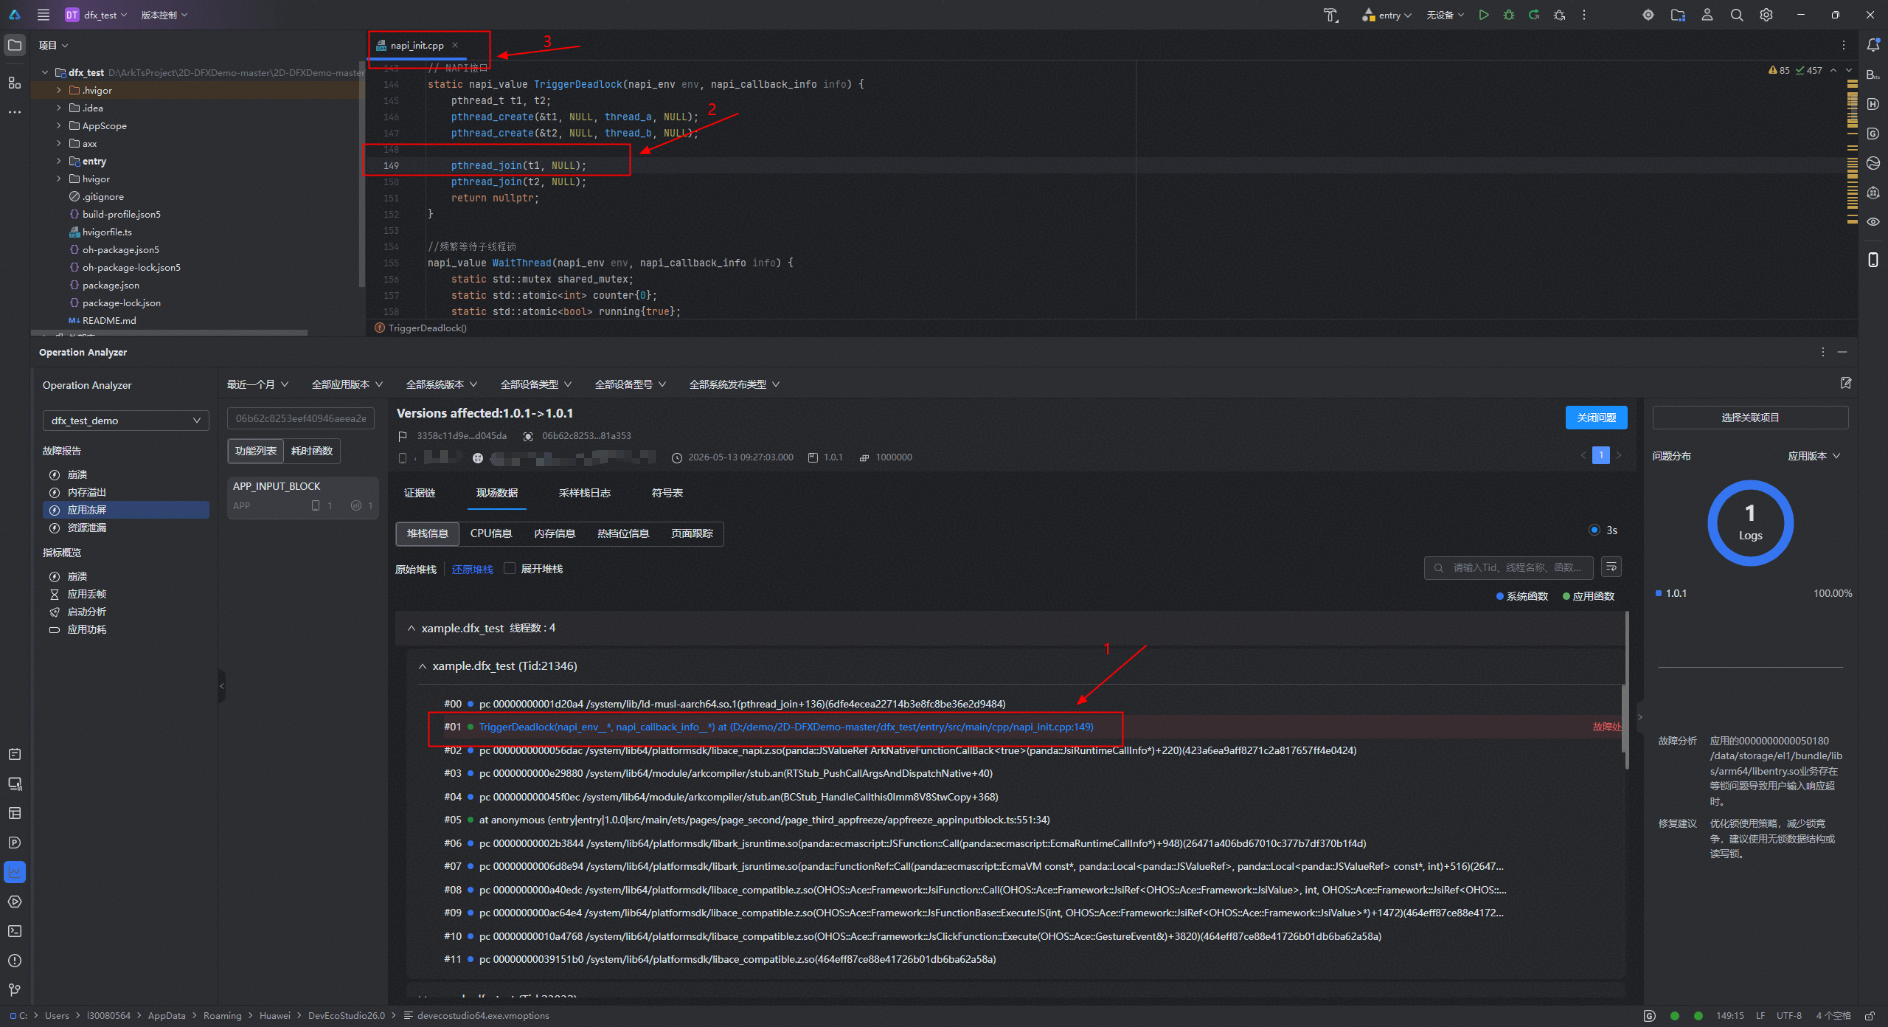
Operation Analyzer 关联代码:
堆栈还原后,Operation Analyzer 平台可将故障处与项目代码相关联,点击故障处可跳转到对应源码中,可辅助开发者更高效的定位问题。
1.2.5.3 问题修复
Operation Analyzer 平台会给出故障分析与修复建议,开发者可根据修复建议修复问题代码。