在 2026 云栖大会技术主论坛上,阿里云提出面向 Model、Harness、Context 三个维度加持 Agent 的落地,其中决定 Agent 能力上限但最难标准化的一环是——面向 Context,让 Agent 持续理解企业知识、业务状态和执行反馈。对此,阿里云智能集团首席技术官李飞飞进一步强调,围绕"存储—计算处理—上下文工程",阿里云的 Context Engine 将企业全域数据转化为实时上下文,让 Agent 从"知道什么"走向"此刻应该做什么"。
基于这一理念,阿里云同步推出 ApsaraLakebase、AI 原生大数据服务 ADA 等产品的发布和重大升级。
上下文不再是会话级临时数据,而是企业新型数据资产
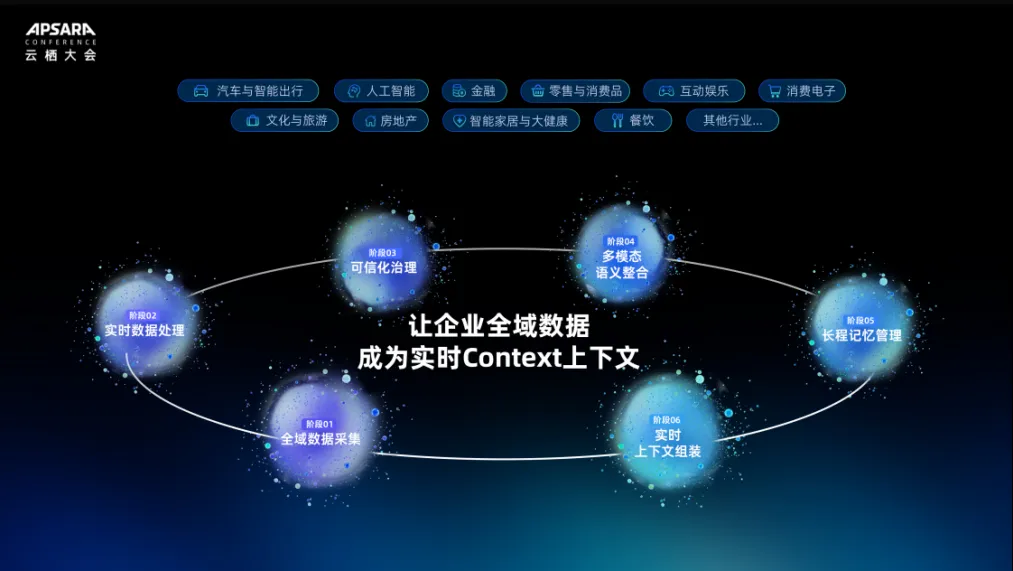
决定 Agent 能力上限的不只是模型参数,还包括能否持续理解企业知识、业务状态和执行反馈。因此,上下文不再是应用侧的一段临时对话数据,而是成为企业需要统一建设和治理的新型数据资产。
OpenLake 迈向 Agentic Lake:一份数据打通 Data+AI 全链路
阿里云智能集团研发副总裁、计算平台事业部负责人汪军华指出数据在三大环节驱动智能进化。从数据到智能——数据作模型训练的燃料形成支撑能力;从智能到应用——智能支撑业务上下游完成工作;从应用到智能化——应用产生的轨迹和反馈经筛选评估后用于下一轮 AI 学习,“三个环节连接模型、Agent 和支撑系统形成持续改进的闭环”。
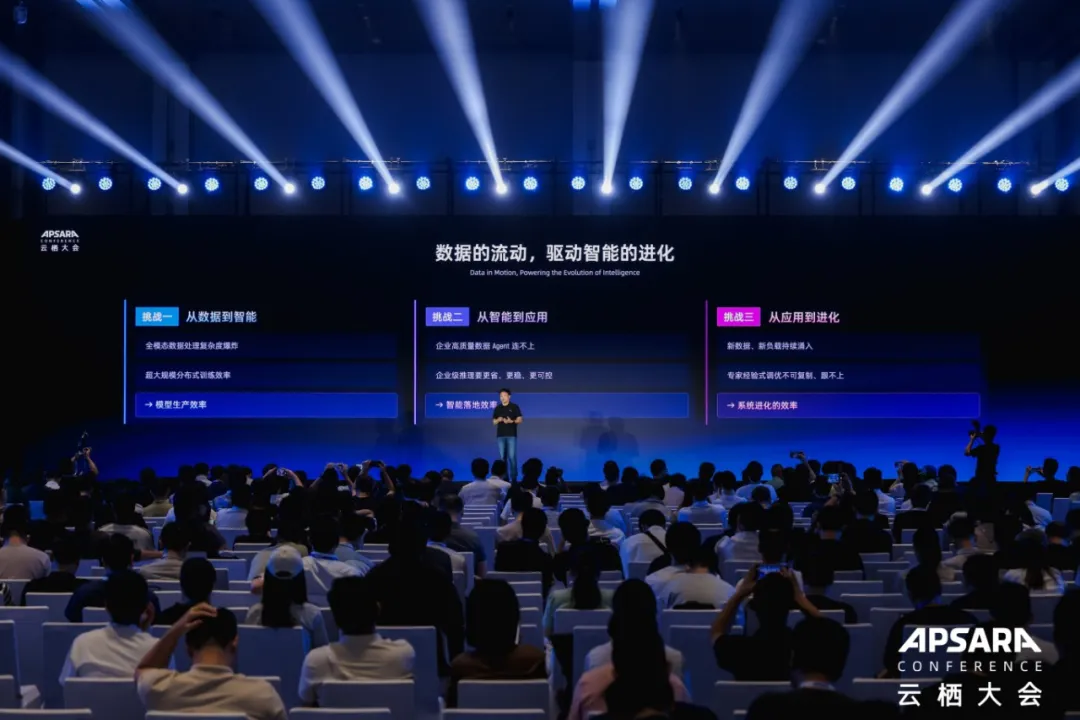
阿里云 OpenLake 进一步迈向 Agentic Lake——以统一、实时的开放湖存储承载全模态数据,推动大数据、搜索与 AI 引擎达到跨引擎协同与智能体就绪。通过 DataWorks 构建的跨引擎语义层将数据赋能智能体服务,并以 AI 原生大数据服务 ADA 支撑多智能体协同企业,企业基于 OpenLake 开放湖仓构建的全模态数据能够服务于 BI、AI 与 Agent,赋能企业步入全模态开放数据湖智能体时代。
在 AI 原生化方面阿里云全新发布 AI 原生大数据服务 ADA——一款智能体形态的产品,采用多智能体协同架构,用户在统一的对话入口用自然语言即可调用离线、实时、流式分析、AI 训推、搜索等不同计算引擎,并驱动多个 Agent 协同完成数据分析、工程、治理、运维和数据科学等端到端任务。
在企业专属模型的训练推理侧,PAI 推出了 PAI-RLS 与 PAI-InferX 组合拳。PAI-RLS 提供云上全托管的强化学习训练服务,结合高性能的强化学习训练架构、全链路轨迹追踪管理、自研训练加速引擎,降低企业模型定制的门槛;PAI-InferX 是面向 Agent 推理负载特性推出的高保障 SLO 推理平台,通过 LLM 智能路由、Cache 感知调度、KV Cache 存储、模型预热与全球算力统筹等核心能力,帮助企业以更低成本、更高 SLO 保障、更强自主可控的方式,构建专属大模型推理服务。
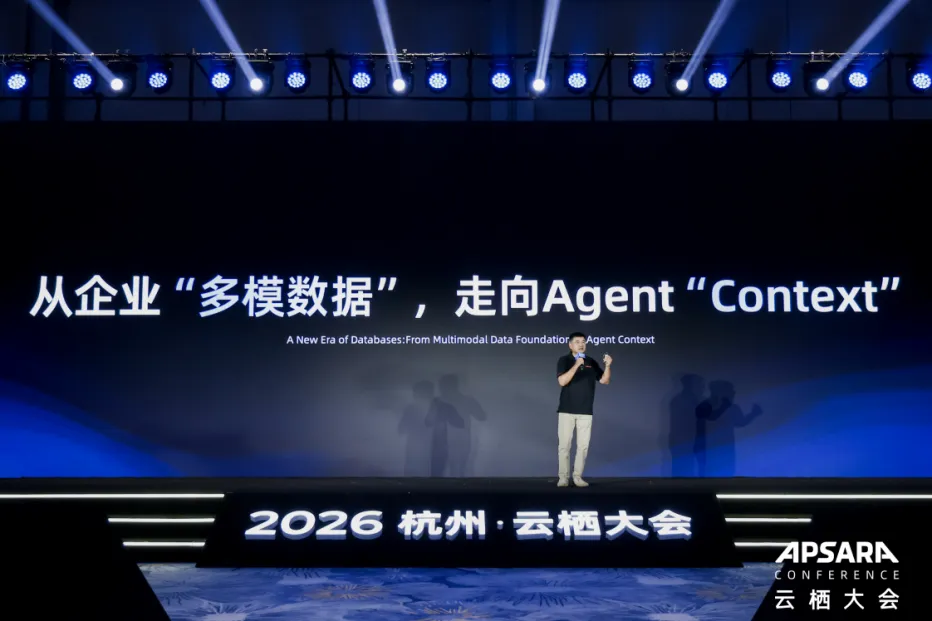
数据底座全面升级:从企业“多模数据”,走向 Agent“Context”
阿里云智能集团研发副总裁、数据库产品事业部负责人杨辛军透露,过去 1 年阿里云 RDS PostgreSQL 的新增实例数量,已环比增长超过 400%+。其中,约 80% 新增实例由 Agent 所创建,输入输出流量中约 50% 由 Agent 交互和驱动。
“企业的数据越来越成为 Agent 的 Context, 不同的数据 Context 决定了 Agent 能力、深度和广度。”为此,阿里云数据库在会上推出 ApsaraLakebase 与 Agent Context 2 大重磅新品,重构从多模态数据存储、实时上下文工程到 Data Agent 平台的全链路数据底座。
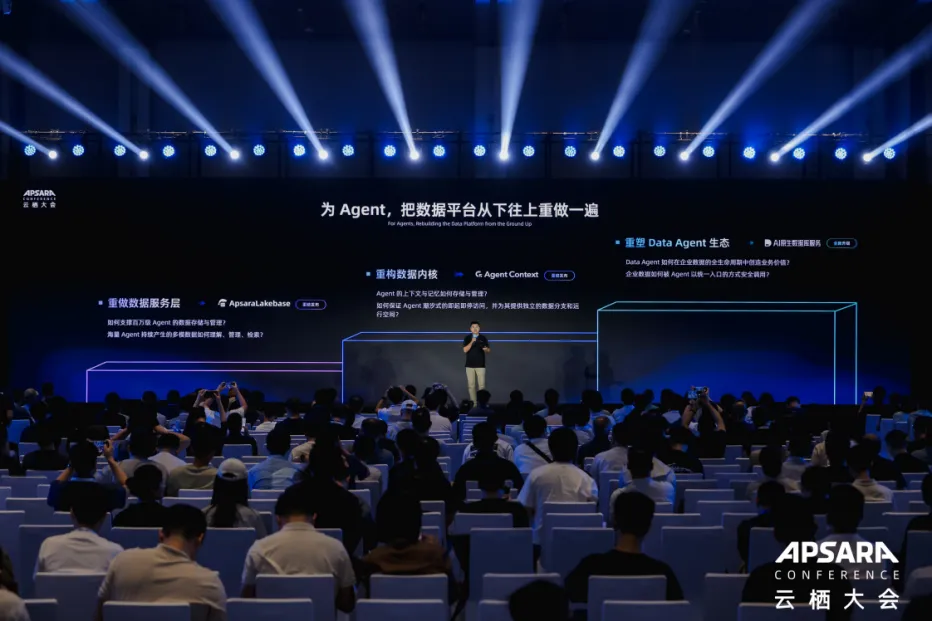
其中,ApsaraLakebase 以“一份数据、多种引擎、统一治理”的架构,同时接住 Agent 的训练和推理数据。它基于云原生共享底座构建,以对象存储为单一事实数据源,数据只存一份。ApsaraLakebase 支持 Lance、Apache Iceberg、Apache Paimon 等开放数据格式,叠加缓存、引擎、语义与接口能力,让结构化数据、非结构化文件、向量索引、图关系和上下文记忆在同一套体系内流转,真正实现“数据不搬家,一次入湖,处处可用”。
头部基模厂商昆仑万维的 Agent 平台深度应用了 ApsaraLakebase,构建可快照、可共享的弹性存储底座,支撑了海内外 300 万+ Agent 的独立工作空间、10W 级并发连接峰值,深度睡眠后沙箱拉起挂载 P99 达秒级。
另一款全新发布的 Agent Context,是面向企业级 Agent 提供实时上下文与记忆底座的数据服务,也是让数据库从“可调用”,走向“可托付”的关键一步。
Agent Context 把各类文档、业务系统、个人经验、图片和音视频等信息源统一接入,基于业务语义管理记忆、知识与 Skill,让上下文可以跨会话、跨任务、跨 Agent 复用,让知识在工作中持续生长,让企业 Agent 越用越懂业务,Token 使用效率可提升 3 倍以上。围绕研发协同、运维支持、技术服务、数据分析等知识密集型场景,Agent Context 对复杂知识任务的准确率可提升高达 50 个百分点,并能在单个工作空间内调度上万个智能体。
以小红书为例,小红书以 Agent Context 为数据管理智能体搭建统一上下文底座,支撑 DBA、开发、算法等 3000+ 员工的子 Agent 协同作业,让整个 Agent 集群在同一业务知识域下共享同一套 Context。业务规则一次更新,所有具备权限的 Agent 在后续调用中即可获取最新上下文,无需再逐个喂料,从源头消除经验孤岛与规则失准。
在应用层,阿里云数据库也对企业级 Data Agent Platform——AI 原生数据库服务(AIDBS)进行了全面升级。围绕数据发现、数据管道、分析与机器学习、预测、治理和安全运维等环节,AIDBS 为用户提供了面向企业数据全生命周期的 Agent 能力,实现数据应用从“由人构建”到“Agent 自主构建”的跃迁。
阿里云数据库已升级为“可被托付”的 Agentic 数据平台。数据库不再只是保存数据、响应查询,而是要成为 Agent 理解世界、积累经验和创造业务价值的数据底座,让 AI 真正进入生产流程、走向价值创造。
围绕 Context Engine,阿里云正打造覆盖数据旅程所有阶段的高质量 Agent-Native 数据服务——从多模态数据的入湖存储、语义抽象与上下文装配,到实时计算、记忆管理与自然语言访问,让企业全域数据真正成为 Agent 可理解、可调用、可持续进化的实时上下文。


