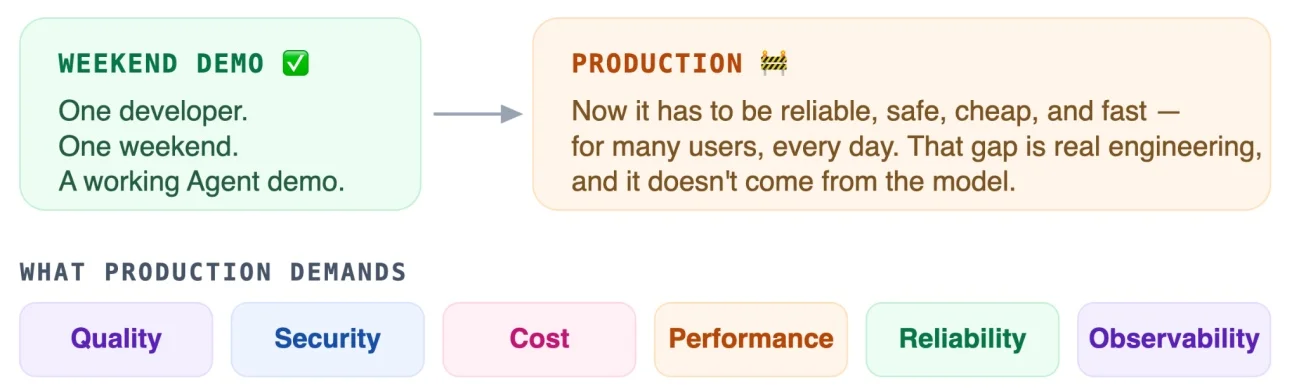
搭一个 AI Agent Demo,可能一个下午就够了。但要把它真正做到可以投入生产,完全是另一回事。
一个生产级 Agent 必须稳定在线、足够安全、控制好成本,而且当它不可避免地出问题时,你还得有足够的可观测性去弄清楚到底哪里出了错。这些能力几乎都不是模型本身提供的,而是来自你围绕模型搭出来的所有东西:记忆、工具访问、模型路由、护栏、成本控制,以及当 Agent 开始乱来时,你不得不翻进去排查的各种 trace。
这一层,就是我们所说的 Agent Harness。
接下来这篇文章会带你了解什么是 Agent Harness,以及它的两大组成部分:开发和运维。然后,我们会看看团队该如何决定哪些东西自己管理,从完全托管的 Harness-as-a-Service 到自主管理的技术栈。最后,我会用两种方式分别构建同一个 Agent——FinBot,并逐项对比它们如何实现同样的能力。读完之后,你应该会更清楚,如何利用本文介绍的 Harness 能力来构建真正可投入生产的 Agent。
Agent = Model + Harness
“Agent Harness”这个说法是今年才真正流行起来的,但背后的工作早就存在了。如果你去年就在做 Agent,其实已经在干这些事:把各种工具接起来、反复调 Prompt、补上重试和日志,再在系统半夜把人叫醒之后,第二天继续修复故障。现在真正发生的变化,只是大家终于给这些工作起了一个统一的名字。这个名字很有用,因为它让你可以把这些零散能力当成一个整体来设计,而不是每出一次问题,就往系统里再塞一个临时修复。
我最常用的一种理解方式,来自 Vivek Trivedy 的文章 The Anatomy of an Agent Harness:Agent = 模型 + Harness。换句话说,如果你负责的不是模型本身,那你做的基本都属于 Harness。用汽车来类比,这件事就很好理解了。
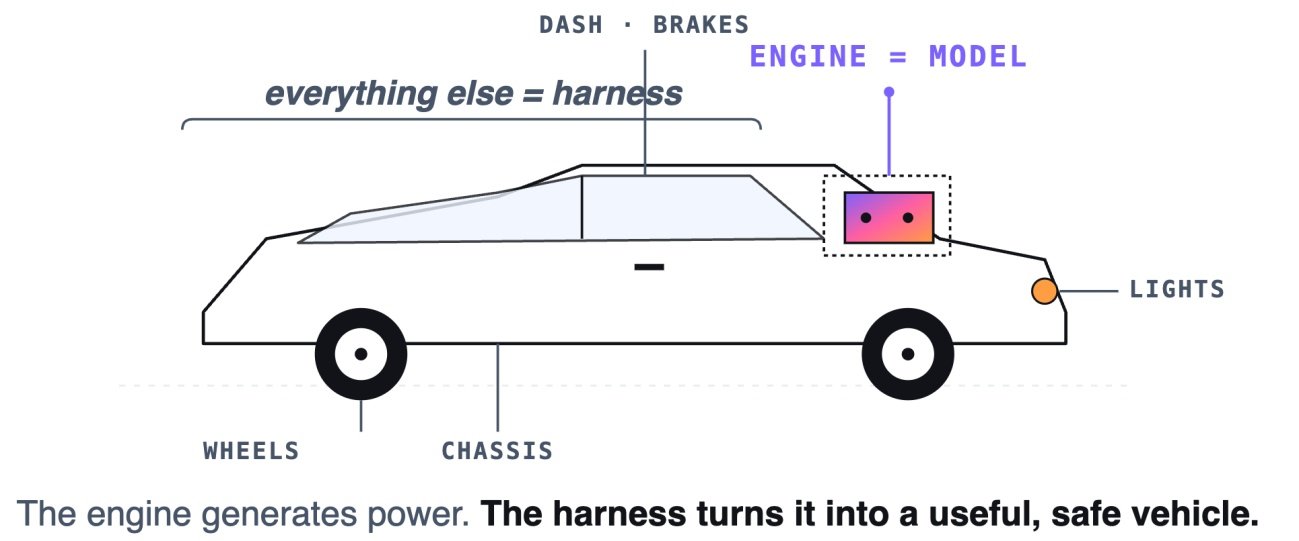
模型就像发动机,动力来自这里。但没有人会把一台裸发动机固定在托盘上,然后直接交付给客户。底盘、刹车、仪表盘和安全带,才让它成为一辆你愿意让家人坐进去的车。模型只是发动机;真正让产品变得安全、可靠、好用的,是你围绕它搭出来的 Harness。
Harness 分成哪两部分?
在我看来,Harness 大致可以分成两部分。开发侧负责扩展模型能做什么,包括跨会话记忆、工具和 MCP、检索、Prompt,以及编排。运维侧负责在真实用户进来之后,让整个系统稳定运行,包括可观测性、评估、护栏、路由、漂移和成本监控、部署,以及扩缩容。
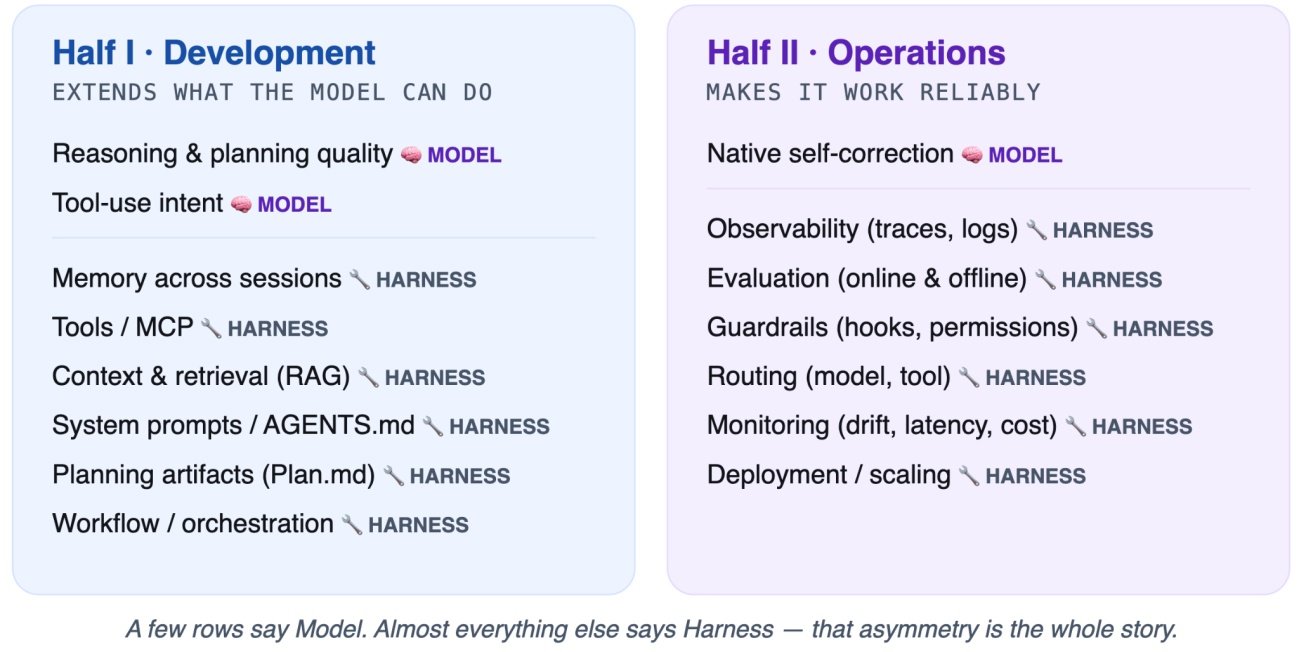
这里需要说明一下:看到这样一张两边明显不对称的图,很容易误以为模型没那么重要。当然不是。真正困难的认知工作依然由模型完成,模型越强,上层能力也会一起受益。这里想强调的是:一个 AI Agent 并不只是模型,它最终是一个产品。做出一个好产品,远不只是给模型包一层 API,而那些让它真正能被用户使用的额外工作,大多都落在 Harness 上。如果你过去做过线上服务,这里面很多东西其实并不陌生:尤其运维这一半,本质上就是换了个名字的 DevOps。
两条路线:托管还是自己管?
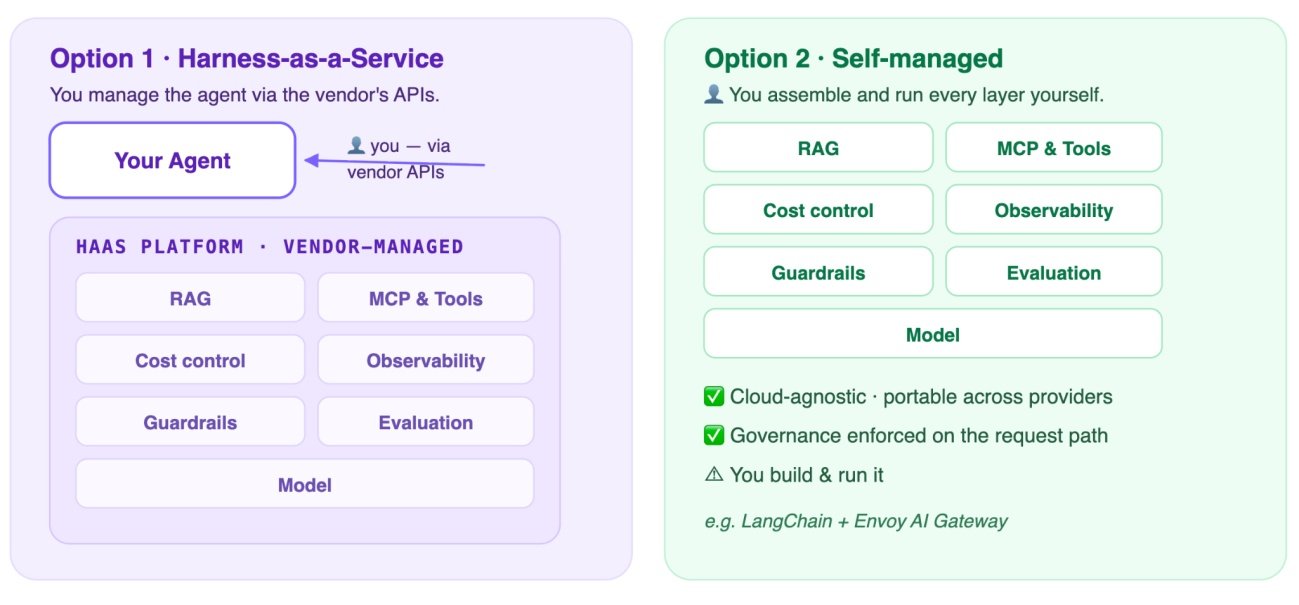
有一点最好先想清楚:HaaS 和自主管理方案,本质上解决的是同一类问题——它们都是构建和运行 Agent 的基础设施。底层也都是那几块能力:模型访问、检索、工具和 MCP、路由、护栏等等。
真正不同的,是这些能力如何交到你手里,以及你如何使用它们。HaaS 把它们做成托管 API,你负责配置;自主管理方案则把这些组件交给你,由你自己组装、部署和维护。这个差异最终会落到几个很实际的问题上:你能多快上线、能保留多少控制权,以及 Harness 最后要花多少钱——一边是供应商账单,另一边是基础设施和工程人力的成本。零件其实没变,变的是谁来装,以及坏了以后谁会在半夜被叫醒。
该选托管,还是自己搭?
Harness-as-a-Service 在一端,自主管理在另一端,很多团队最后都会落在中间,这很正常。两者之间有多种选择,具体选哪一种,主要看下面几个问题:
团队能力——你们能不能长期维护 Kubernetes、Gateway,并安排值班?或者说,你们其实真的不想管这些?
现有云投入——你们已经完全押注 AWS,还是有意保持多云?
成本——你更想要一张可预测的供应商账单,还是基础设施成本再加自己运行它所需的工程时间?HaaS 更容易做预算;而在规模扩大之后,如果无论如何你都已经要投入人力运营系统,自主管理有可能更便宜。
治理——护栏、审计记录和数据路径是否必须留在你自己的边界之内?有些企业要求所有这些东西都必须运行在自己的 VPC 中。
可移植性——只用一家供应商没有问题,还是你必须保持云无关?
预期规模——为了支撑这个规模,你愿意承担多复杂的一套运维体系。
对运维复杂度的容忍度——你真的愿意长期处理集群维护、升级,以及偶尔凌晨 3 点响起的告警吗?
用 FinBot 看看生产级 Agent 真正缺什么
FinBot 是一个很小的 Agent,两种方案都会使用同一个场景。用户提出一个财务问题:“总结第三季度营收”。FinBot 会从文档存储中取出该季度的财报,把数字交给代码解释器,再调用模型写出总结,最后返回答案。
要让这套流程真正进入生产环境,关键并不在于选一个更聪明的模型,而在于围绕模型搭建什么。再强的模型,自己也不会记住上一轮对话,不会访问财报,不会在失控循环产生巨额账单之前停下来,也不会在出错之后告诉你问题到底发生在哪。这些都是 Harness 要解决的事情,它们围绕着同一条请求路径展开。接下来,我会让同一个请求分别走过两套方案,完成同样的任务,只是按照各自技术栈最自然的方式来实现。
一套真正的 Harness 包含很多相互配合的组件(可以回头看看前面那两大部分),一篇文章不可能全部讲完。我会从两边各挑几项:先看 FinBot 本身如何构建,再看三个运维能力。在我的经验里,它们往往最能决定一个 Agent 是否达到了生产要求。护栏、评估、Prompt 编排、部署和扩缩容,以及多 Agent 工作流,这里都不会展开。这些确实是本文没有覆盖的部分,并不意味着可以将它们排除在外,因为要把 Demo 真正做到生产可用,这些问题也都必须处理。下面先说明所选的几项能力为什么重要,这样后面的方案 1 和方案 2 就可以专注于各自如何实现它们。
构建 Agent
开发侧只保留 FinBot 真正需要的东西:System Prompt、它能访问的工具(一个用于财报的 MCP Server,以及一个运行 MCP 代码执行服务器的容器)、针对这些财报的检索,以及跨轮次记忆。这也是两套技术栈差异感最明显的地方。一边是一个配置对象,另一边则是一组需要你自己部署和维护版本的进程。
统一模型访问
每一家模型供应商都有自己的 SDK、认证方式和响应格式,自托管模型还会再多一套。你真正需要的是一个统一入口,这样无论是新增模型、给新模型做金丝雀测试,还是故障时切到另一家供应商,都只需要改配置,而不是改应用。供应商密钥也只需要放在一个地方,而不是散落在每个服务中。
成本控制
一个有 Bug 的循环,或者一个没考虑周全的功能,都可能让 Token 用量瞬间失控,最后变成一张巨额账单。你需要计量、预算,以及当达到限制时还能优雅处理的机制,例如直接设一个硬上限终止循环,或者切到备用方案继续服务,而不是等账单来了才发现出了问题。
可观测性
Agent 本身就像黑盒,如果还接了多个供应商,情况只会更糟。如果没有一个统一视图把 Prompt、工具调用和响应串起来,再加上延迟和成本,你连 Debug 都做不到,更别说优化了。
接下来,我们来看同一个 Agent 和同样三个能力,如何用两种方式实现。
先看两套方案分别长什么样
在进入具体能力之前,先快速看看两种方案到底由什么组成。两边提供的是同一组基础能力,只是组织和交付方式不同,接下来几节主要讲的就是这些差异。
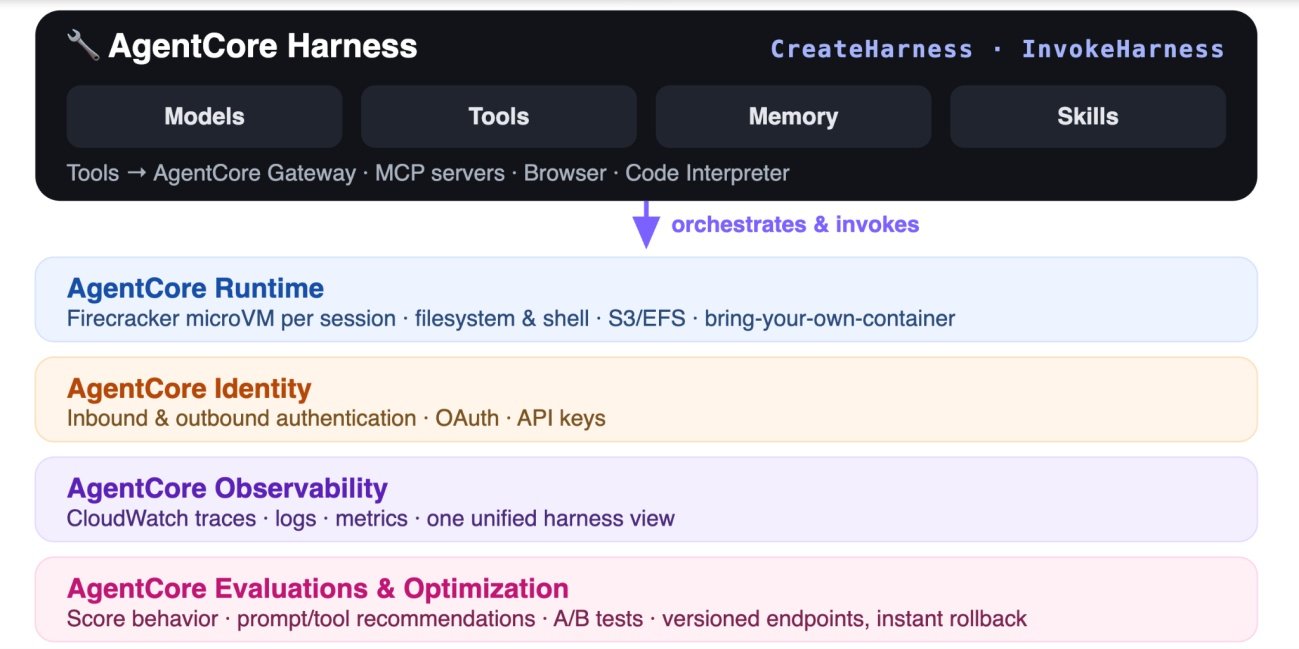
Amazon Bedrock AgentCore 提供 Runtime、Memory、Identity、Gateway、Observability、Code Interpreter 和 Browser 等生产环境基础能力。AgentCore Harness 则是在它们之上的一层托管封装,把原本“自己把这些组件一个个接起来”的工作,变成“填配置”。你通过 CreateHarness 和 InvokeHarness 两个调用描述 Agent,Harness 就会负责连接底层组件:每个会话对应一个 Firecracker microVM,再加上托管记忆、身份管理和自动追踪。
当配置无法满足需求时,可以用一个命令把 Harness 导出成可编辑的 Strands 代码,并继续运行在原来的 Runtime 上。80% 的通用功能交给配置,真正属于你自己的那 20%,再用代码解决。
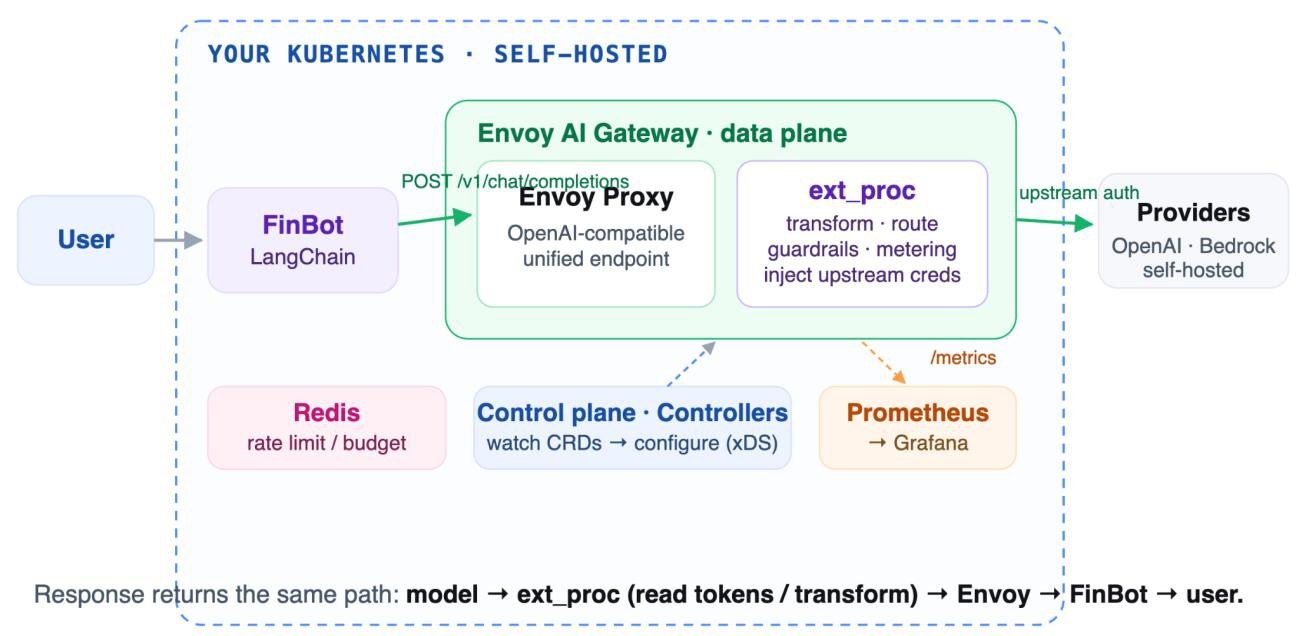
自主管理方案则让 FinBot 保持为一个普通 LangChain Agent,运行在你自己的集群上,并把 Harness 中负责模型访问的那部分交给请求路径上的 Gateway。
Agent Router(原 Envoy AI Gateway)是一个建立在 Envoy Proxy 和 CNCF Envoy Gateway 之上的开源 Gateway,专门面向生成式 AI 流量:它在多个模型供应商前面提供一个兼容 OpenAI 的统一 Endpoint,并支持基于 Token 的限流、路由和故障切换、可观测性,以及一个 ext_proc 扩展 Hook,同时明确拆分控制平面和数据平面。请求路径也很容易理解:FinBot 向 Gateway 发起一个 OpenAI 风格的调用;数据平面(Envoy Proxy 加一个 ext_proc 服务)会先完成认证、按模型路由、执行护栏、统计 Token,并注入上游凭证,之后请求才真正到达模型供应商。控制平面则由一组 Controller 组成,它们监听你的 Kubernetes CRD,然后通过 xDS 下发配置。整个系统都运行在你自己的集群里,也不绑定任何一家云厂商。只要是 Kubernetes 都可以,无论 EKS、GKE、AKS 还是本地部署。
本文示例运行在 EKS 上,后端连接 Bedrock。如果你把整套技术栈迁到另一家云,比如用 GKE 对接 Vertex,那么这就是云无关带来的好处:FinBot 的代码和它调用的 Endpoint 都不用改。你只需要重新配置底层,包括 Backend Schema、模型 ID、凭证、Workload Identity 和部署配置。
构建 FinBot:工具、MCP、记忆与检索
方案 1 把 FinBot 跑在 AWS AgentCore 上,也就是供应商运行的 Harness Runtime;方案 2 则在你自己的集群中运行同一个 LangChain Agent,并让它位于 Agent Router 后面。两边都需要同样四样东西:System Prompt、可以访问的工具、对财报的检索,以及跨轮次记忆。在 AgentCore 上,这些内容都是一次控制平面调用里的字段:
import boto3control = boto3.client("bedrock-agentcore-control")runtime = boto3.client("bedrock-agentcore")harness = control.create_harness( harnessName="finbot", executionRoleArn=ROLE_ARN, systemPrompt=[{"text": "You are FinBot, a finance assistant."}], model={"bedrockModelConfig": { "modelId": "us.anthropic.claude-sonnet-4-6", "apiFormat": "converse_stream"}}, tools=[ {"type": "agentcore_code_interpreter", "name": "code"}, {"type": "remote_mcp", "name": "filings", "config": {"remoteMcp": {"url": "https://mcp.internal/filings"}}}, ], memory={"managedMemoryConfiguration": { "strategies": ["SEMANTIC", "SUMMARIZATION"], "eventExpiryDuration": 60}},)resp = runtime.invoke_harness( harnessArn=harness["harnessArn"], runtimeSessionId=SESSION_ID, messages=[{"role": "user", "content": [{"text": "Summarize Q3 revenue."}]}],)检索本身并不是 Harness 的一个独立字段:Amazon Bedrock Knowledge Base 会以 Gateway Connector Target 的形式接入,并像其他工具一样挂上去。 在自主管理方案中,同样四块能力,则由你自己部署和维护版本的多个独立组件拼起来:
from langchain.agents import create_agentfrom langchain_openai import ChatOpenAIfrom langchain_mcp_adapters.client import MultiServerMCPClientfrom langchain_core.tools.retriever import create_retriever_toolfrom langgraph.checkpoint.postgres.aio import AsyncPostgresSaverfrom psycopg_pool import AsyncConnectionPoolfrom psycopg.rows import dict_rowmodel = ChatOpenAI(model="finbot", base_url="http://ai-gateway/v1", api_key="unused", default_headers={"x-ai-eg-model": "finbot"})async def build_agent(): # once, at startup pool = AsyncConnectionPool(DB_URI, open=False, kwargs={"autocommit": True, "row_factory": dict_row}) await pool.open() # long-lived, shared checkpointer = AsyncPostgresSaver(pool) await checkpointer.setup() # migration: run once, not per request mcp = MultiServerMCPClient({"filings": {"url": "http://filings-mcp:8000/mcp", "transport": "http"}, "code": {"url": "http://code-sandbox:8000/mcp", "transport": "http"}}) tools = [*await mcp.get_tools(), create_retriever_tool(vector_store.as_retriever(search_kwargs={"k": 4}), name="search_filings", description="Search quarterly filings.")] return create_agent(model, tools, system_prompt="You are FinBot, a finance assistant.", checkpointer=checkpointer)async def answer(agent, question, session_id): # per request return await agent.ainvoke( {"messages": [{"role": "user", "content": question}]}, {"configurable": {"thread_id": session_id}}) # memory keyed by session两边用的还是同样四块积木,走的也是同一条请求路径。区别在于,一边它们只是配置对象里的几个字段;另一边则是各自拥有生命周期的独立进程。就这两个标识符来看,差别只是 runtimeSessionId 和 thread_id。
模型访问
每个供应商前面都建立一个统一入口,这样新增模型、对新模型做金丝雀测试,或者发生故障时切换,都只是改配置,而不是改应用。
在 AgentCore 上
指定模型只是配置,而且每次调用时都可以覆盖。AgentCore 底层可以处理 Bedrock、OpenAI、Gemini,以及所有兼容 LiteLLM 的供应商,也可以在不丢失上下文的情况下,在一次 Session 中途切换供应商,并把第三方密钥保存在 AgentCore Identity 的 Token Vault 中。model 字段是四种配置的联合类型(bedrockModelConfig、openAiModelConfig、geminiModelConfig、liteLlmModelConfig),既可以配置在 Harness 上,也能在每次调用时单独覆盖:
resp = runtime.invoke_harness( harnessArn=harness["harnessArn"], runtimeSessionId=SESSION_ID, model={"openAiModelConfig": {"modelId": "gpt-4o"}}, # swap provider per call messages=[{"role": "user", "content": [{"text": "Summarize Q3 revenue."}]}],)自主管理
Agent Router 提供一个兼容 OpenAI 的统一 Endpoint,并把模型别名映射到具体 Backend,供应商凭证则保存在 Gateway 上:
kind: AIGatewayRoutespec: rules: - matches: - headers: [{ name: x-ai-eg-model, value: finbot }] backendRefs: - name: bedrock-claude modelNameOverride: us.anthropic.claude-sonnet-4-6 # alias -> real model id---kind: AIServiceBackend # translate OpenAI schema -> Bedrockspec: { schema: { name: AWSBedrock } }FinBot 用普通客户端指向这一个 Endpoint 即可,完全不会接触供应商密钥;切换模型或供应商,只需要换它发送的别名。凭证始终留在 Gateway。对于 Bedrock 来说,这意味着使用一个由 EKS Pod Identity 或 IRSA 支撑的 AWSCredentials Policy,因此集群里不需要存放静态密钥:
apiVersion: aigateway.envoyproxy.io/v1beta1kind: BackendSecurityPolicyspec: targetRefs: - {group: aigateway.envoyproxy.io, kind: AIServiceBackend, name: bedrock-claude} type: AWSCredentials # Bedrock uses AWS auth awsCredentials: region: us-east-1 # credentials via EKS Pod Identity or IRSA两种方式都提供一个统一入口。AgentCore 的入口是一个 API,你通过不同的配置对象调用;Gateway 的入口则是一条你自己部署的 Route。真正体现差异的地方,是供应商密钥放在哪里:要么放在 AgentCore Identity 的 Token Vault 中,要么通过 Pod Identity 或 IRSA,把 IAM Role 挂到 Gateway 上。
成本控制:别等账单来了才发现 Agent 跑疯了
成本控制意味着两件事:要有一个硬上限,能直接停掉失控循环;也要有真正可以在账单到来之前执行的预算。
在 AgentCore 上
AgentCore 直接针对失控循环这个故障模式下手,提供单次调用级别的硬上限,包括 maxIterations(默认 75)、maxTokens 和 timeoutSeconds,另外还有用于成本分摊的 Tag,以及 CloudWatch 中的 Token 指标:
aws bedrock-agentcore-control update-harness \ --harness-id "finbot-UuFdkQoXSL" \ --max-iterations 50 --max-tokens 8192 --timeout-seconds 1800自主管理
Gateway 会把 Token 作为一次请求的成本进行计量。这里,我们给每个用户设置一个每日 Token 预算,并根据响应实际消耗扣减。一旦预算耗尽,Gateway 就会用 HTTP 429 拒绝后续请求(尽管字段名叫 limit.requests,但这里实际限制的是 Token 预算):
kind: AIGatewayRoutespec: llmRequestCosts: - { metadataKey: llm_total_token, type: TotalToken } rules: - matches: [{ headers: [{ name: x-ai-eg-model, value: finbot }] }] backendRefs: [{ name: bedrock-claude }] ---kind: BackendTrafficPolicy spec: rateLimit: global: rules: - clientSelectors: [{ headers: [{ name: x-user-id, type: Distinct }] }] limit: { requests: 5000000, unit: Day } cost: request: { from: Number, number: 0 } response: { from: Metadata, metadata: { namespace: io.envoy.ai_gateway, key: llm_total_token } }AgentCore 限制的是 Agent 本身,而 Gateway 限制的是流量。一个可以在单次调用过程中直接终止循环,另一个则会在某个租户的 Token 预算耗尽之后拒绝下一次请求。只有后者知道“租户”是什么。
可观测性:出了问题,至少要知道发生了什么
你需要的是一个统一视图,把 Prompt、工具调用和响应串起来,同时附上延迟和成本。
在 AgentCore 上
在 AgentCore 上,这部分几乎是现成的。每次调用都会自动把 Trace、日志和指标发送到 CloudWatch,包括模型调用、工具调用和记忆操作,并集中展示。账号层面做一次前置配置之后,后续调用都会自动进入追踪:
# one-time, account levelaws logs put-resource-policy --policy-name MyResourcePolicy \ --policy-document file://xray-to-logs.json # logs:PutLogEvents for xray.amazonaws.comaws xray update-trace-segment-destination --destination CloudWatchLogs你也可以额外加一条索引规则来设置采样比例,但这不是必须的。
想知道它到底帮你省掉了多少工作,可以和自己给 Agent 做埋点对比一下。如果 Agent 托管在 Runtime 之外,你需要设置 AGENT_OBSERVABILITY_ENABLED、OTEL_PYTHON_DISTRO 和 OTEL_PYTHON_CONFIGURATOR,还要用 opentelemetry-instrument 包住启动命令。如果把自己的容器带到 AgentCore Runtime 上,Runtime 会自动设置 ADOT 默认项,这时只剩 opentelemetry-instrument 这一层包装。再进一步,如果使用 AgentCore CLI 部署,它在打包阶段就会自动加入 Instrumentation,连这个 Wrapper 都不用你自己加。Harness 开发者完全不用写这些东西。
自主管理
Agent Router 会按照 OpenTelemetry 的语义约定输出生成式 AI 指标,包括 Token 使用量、首 Token 时间,以及 Token 间延迟,Prometheus 可以直接抓取:
scrape_configs: - job_name: envoy-ai-gateway relabel_configs: - source_labels: [__meta_kubernetes_pod_container_port_name] regex: "metrics|aigw-admin" action: keep# exposed GenAI metrics (OTel semconv):# gen_ai.client.token.usage# gen_ai.server.time_to_first_token因此,真正发生事故时最常问的两个问题——谁在烧 Token,谁最慢——各自只需要一条查询。由于指标名采用标准语义,所以换模型供应商也依然可用:
sum(gen_ai_client_token_usage_sum{gateway_envoyproxy_io_owning_gateway_name="finbot"}) by (gen_ai_request_model, gen_ai_token_type)指标可以告诉你消耗了多少、哪里慢。但如果想知道具体发生了什么,还需要 Trace。整体结构很简单:两个数据生产端、一个采集器,再加一个后端。
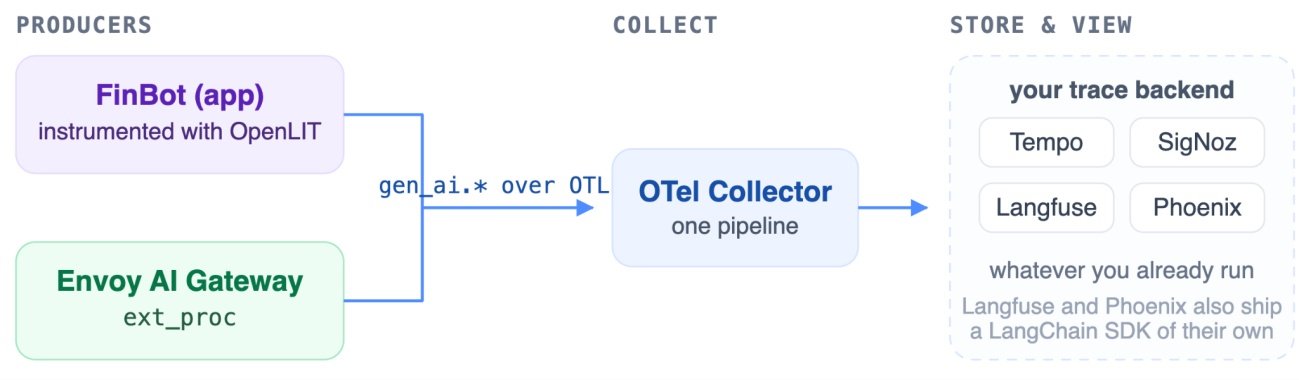
两边都会通过 OTLP 输出同一套 gen_ai.* 语义,这也是为什么它们的 Span 最后能对齐。Instrumentation 和 Backend 可以独立选择:Langfuse、Phoenix 和 OpenLIT 都既提供 LangChain SDK,也提供后端,因此你完全可以用一个做埋点,再把数据存进另一个。在 Gateway 侧,只需要让 ext-proc 指向 Collector:
kind: GatewayConfigspec: extProc: kubernetes: env: - { name: OTEL_EXPORTER_OTLP_ENDPOINT, value: "http://otel-collector:4317" } - { name: AI_GATEWAY_TRACING_SEMCONV, value: "gen_ai" } # gen_ai.* span names这些 Span 覆盖请求路径中的模型调用。循环剩下的部分——工具调用、Agent 自己的控制流、Prompt 拼装——从来不会离开应用进程,所以应用本身还需要 Instrumentation。OpenLIT 只需要一行代码,而且使用同一套语义:
import openlitopenlit.init(otlp_endpoint="http://otel-collector:4318") # once, at startupOpenTelemetry 项目本身也提供 LangChain Instrumentation,不过截至本文写作时还处于 Beta。无论你选哪种方式,有一点几乎所有人都会踩坑:消息内容默认不会被采集。所以,如果你希望 Trace 里能看到 Prompt 本身,需要在两边都设置 OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=SPAN_ONLY,同时也得认真考虑一旦打开之后,到底谁有权限读取这些内容。
把两边都指向同一个 Collector,你就能得到一条从 Prompt 到工具再到响应的完整链路。这其实和你把自己的代码带进 AgentCore Runtime 时需要做的 Instrumentation 工作是一样的;真正不同的是,只有 Harness 会替你把整个 Agent Loop 自动 Trace 下来。
最后:生产级 Agent,本质上还是架构问题
本文介绍了 Agent Harness 这个概念,并展示了两种构建方式:一种是使用 Harness-as-a-Service 的托管方案,另一种是自主管理方案。篇幅有限,我们只用 FinBot 演示了 Harness 的其中几项能力,其余部分就留给你继续探索。
无论最后选哪条路线,构建和运行 Agent 最终都会面对相似的问题,而这些更多是架构问题,并没有什么魔法。你需要先想清楚产品要完成什么、什么才算做好,以及哪些边界绝对不能越。模型提供推理能力,Harness 负责提供控制,让这种推理能力真正成为可以交付的产品。你定义目标和边界,工具负责在这个范围内完成工作。
原文链接:https://www.infoq.com/articles/agent-harness-build-one/


