昨夜,Meta 正式发布新一代轻量级 AI 模型 Muse Ember。据介绍,这是 Meta 迄今推出的体积最小、效率最高的模型,主要面向复杂推理执行,以及 AI Agent 在日常工作中需要反复处理的任务,包括工具调用、编程子任务、任务路由、信息提取和长文档解析等。
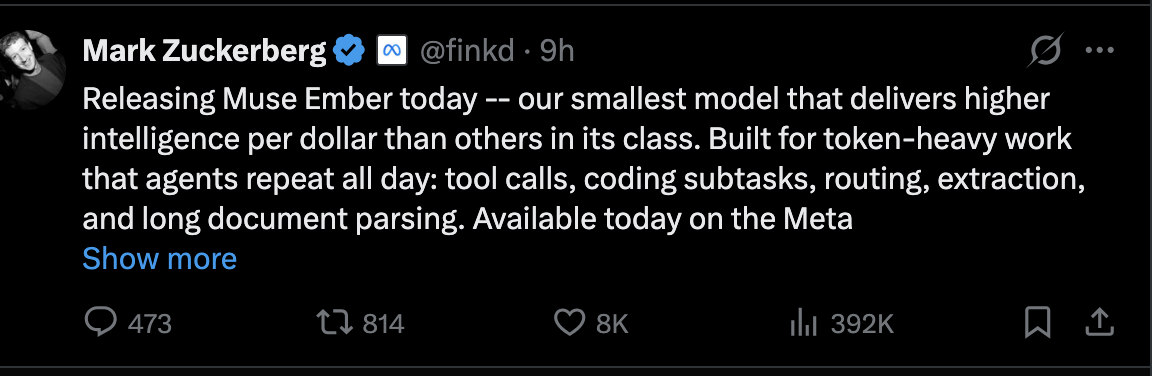
Meta CEO 扎克伯格在 x 上发文写道:“这是我们最小的模型,在同类模型中,每美元所能提供的智能更高。它专为智能体全天重复执行的高 token 消耗型工作而打造:工具调用、编码子任务、路由、信息提取和长文档解析。今天起可在 Meta Model API 和 Muse Code 中使用。”
与此前各家厂商围绕旗舰模型性能展开的竞争不同,Muse Ember 的卖点是成本。
Meta 在官方博客中表示,根据 Artificial Analysis 的评测结果,Muse Ember 在不同推理强度下的智能表现与成本比优于 Claude Haiku 5.5 和 GPT-6 Luna。它能够以约三分之一的成本,达到 Claude Haiku 5.5 最高推理强度下的接近水平,并超过 GPT-6 Luna 所有推理档位的成绩。
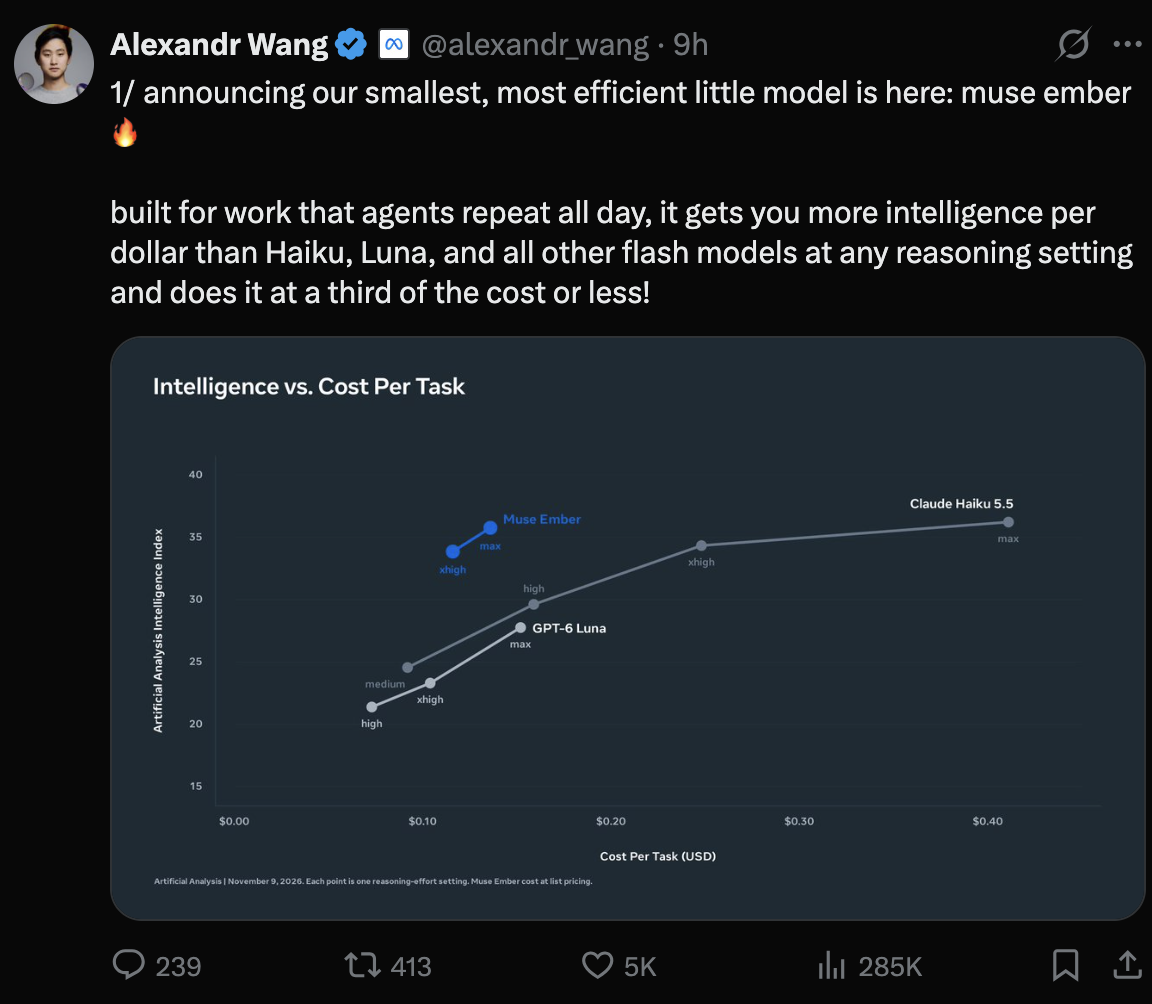
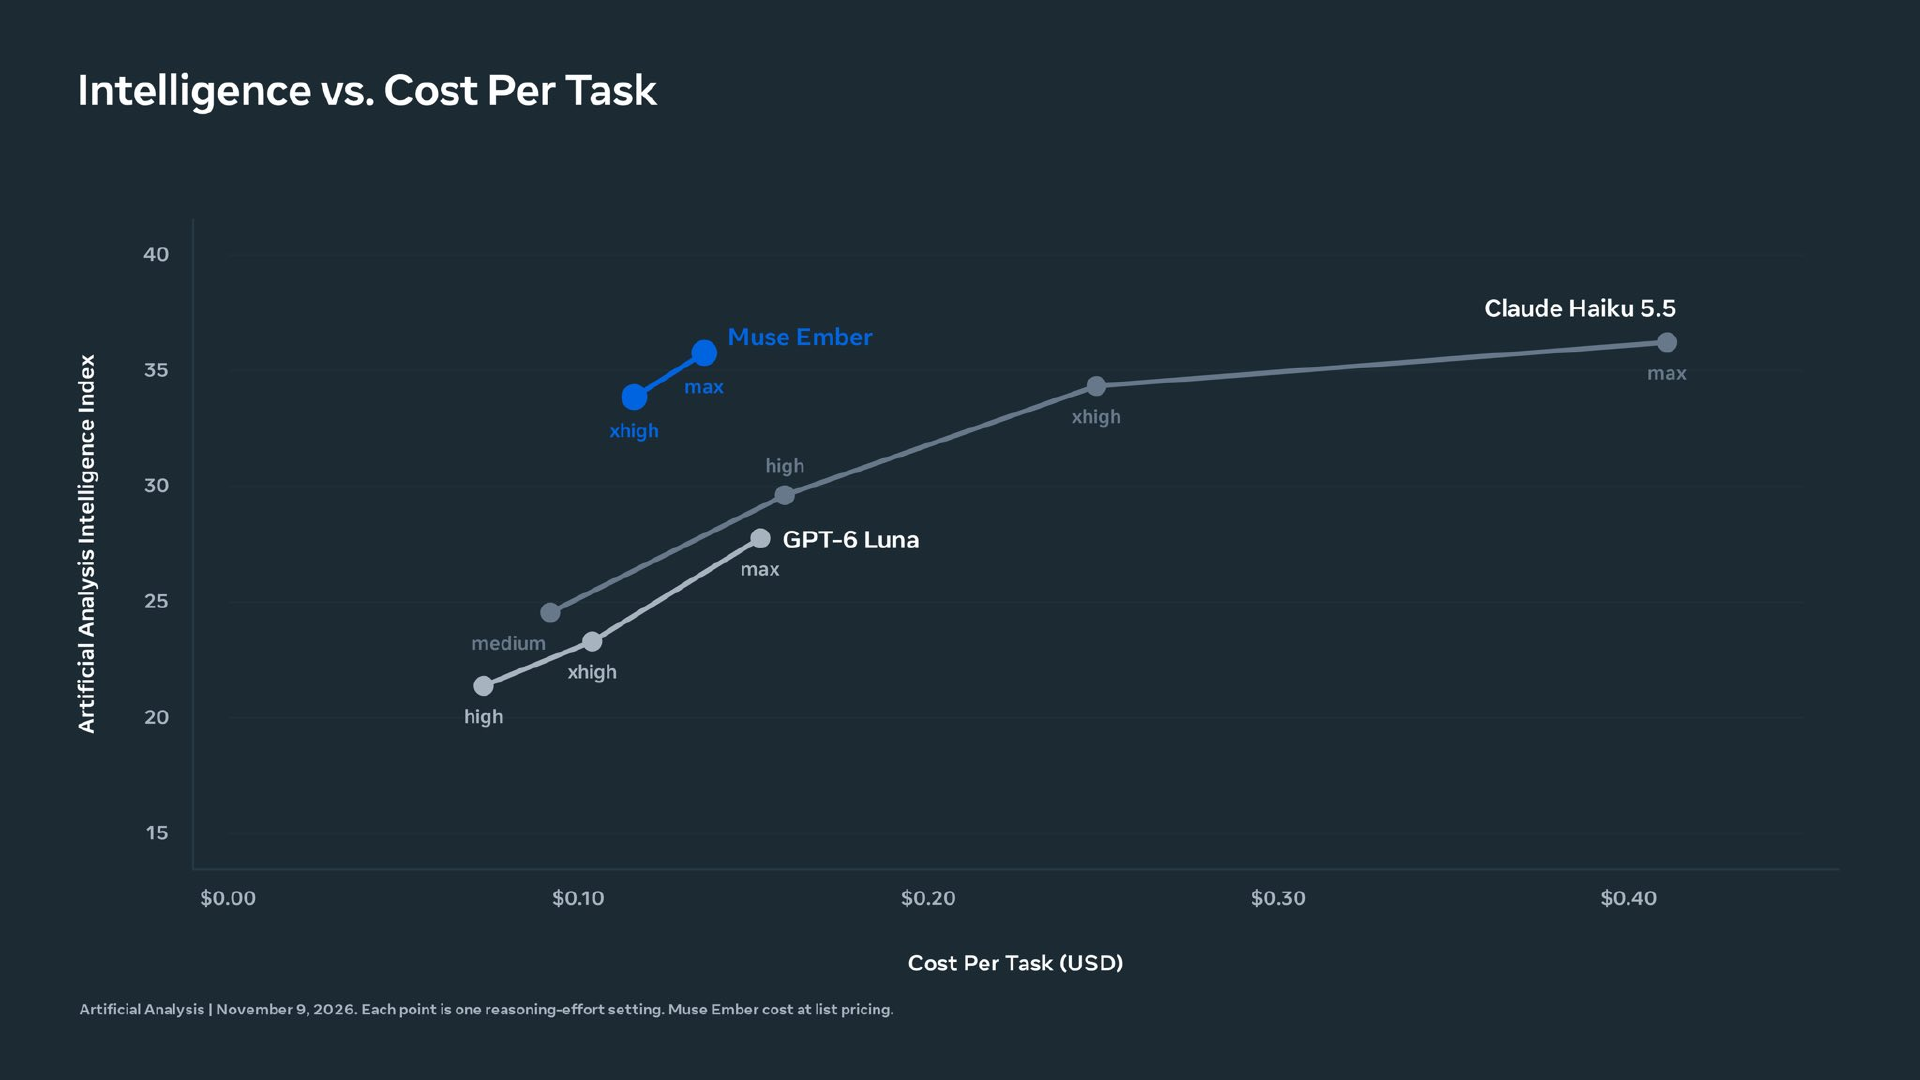
更值得关注的是,Muse Ember 在 Artificial Analysis 智能指数与单任务成本构成的效率前沿上占据了有利位置:在相近或更低的单任务成本下,没有其他参评模型取得更高的智能指数。
这意味着,Meta 此次并不打算让一款小模型承担所有复杂任务,而是试图解决 Agent 规模化应用中的另一个问题:当 AI 系统每天需要执行成千上万次工具调用、代码修改和信息处理任务时,如何把每次执行的成本降下来?
成本只有三分之一,Meta 要重新定义小模型的价值?
在 Artificial Analysis 智能指数测试中,Muse Ember 最高推理强度下的成绩约为 36 分,与 Claude Haiku 5.5 的 36 分持平,高于 GPT-6 Luna 的 28 分。
但在价格上,三者存在明显差距。
按照 Meta 展示的测试数据,在接近最高智能水平的配置下,Muse Ember 的单任务成本约为 0.136 美元,而 Claude Haiku 5.5 最高配置约为 0.411 美元。换言之,Muse Ember 的成本约为后者的 33%,相当于降低了约 67%。
而在具体能力上,Muse Ember 的表现并不局限于基础问答。
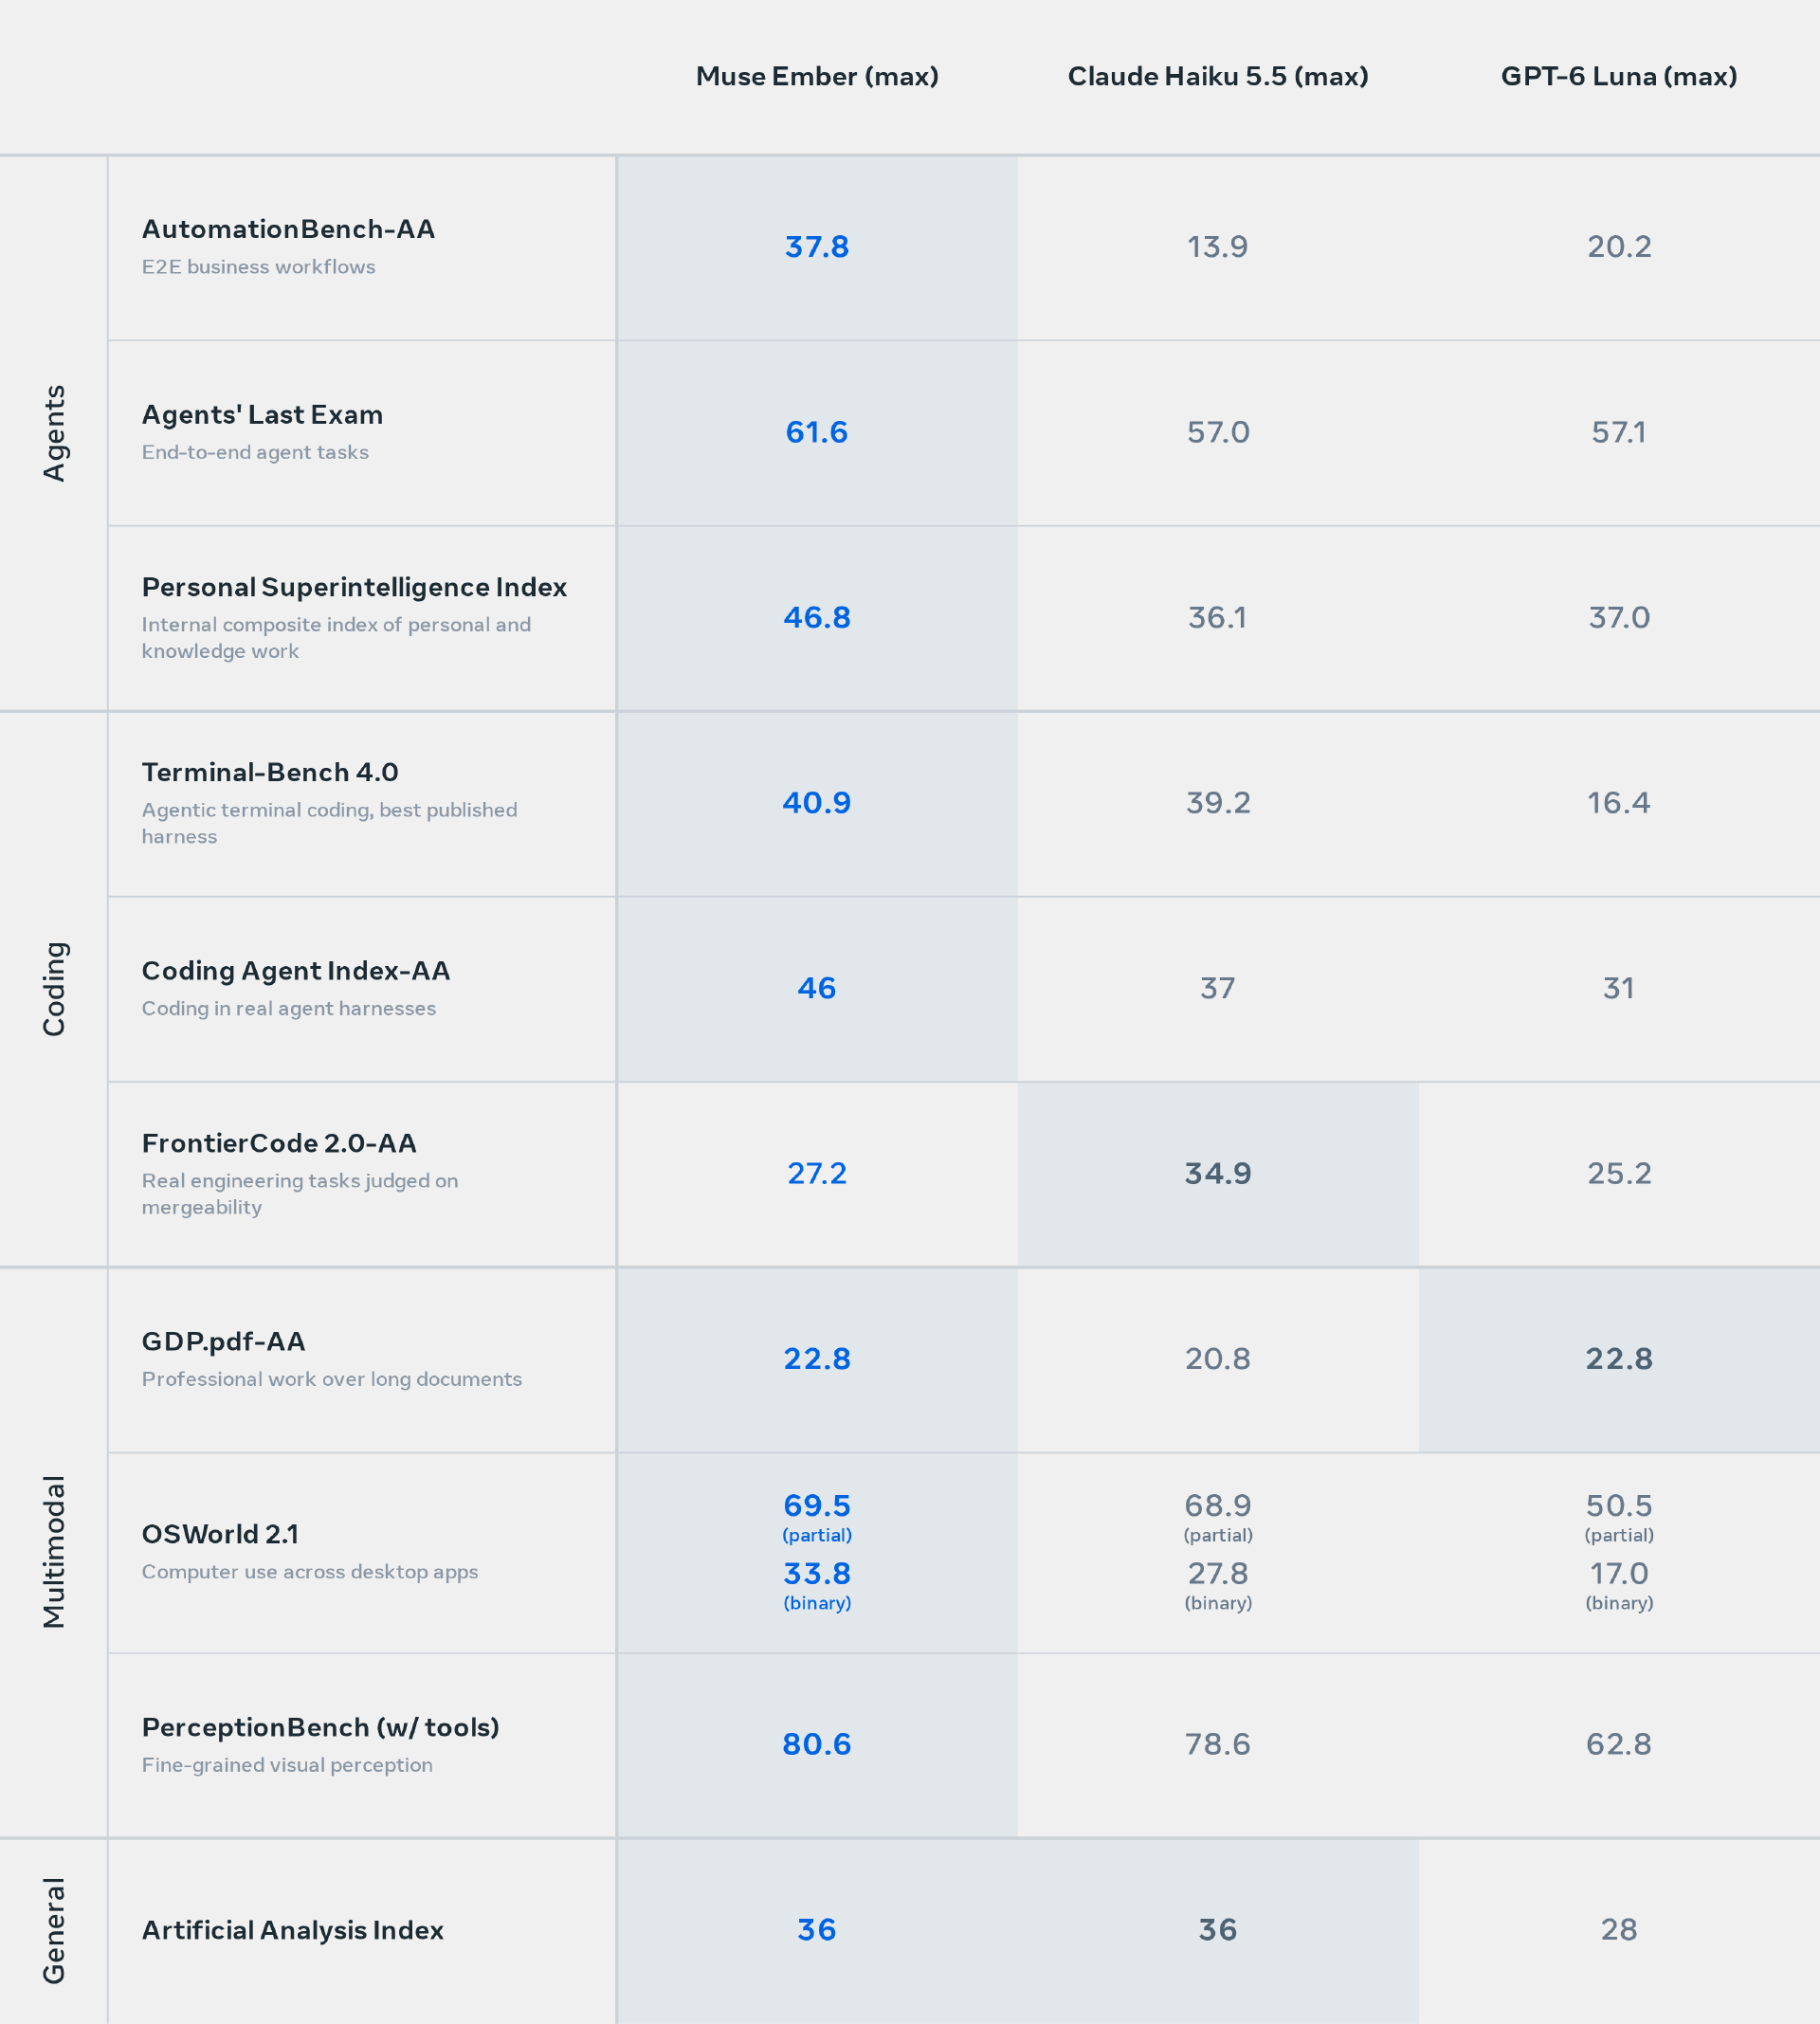
根据 Meta 汇总的评估数据,在企业工作流自动化测试 AutomationBench-AA 中,Muse Ember 取得 37.8% 的成绩,GPT-6 Luna 和 Claude Haiku 5.5 分别为 20.2% 和 13.9%。
在衡量端到端 Agent 任务执行能力的 Agents' Last Exam 中,Muse Ember 得分为 61.6%,高于另外两款模型的 57.1% 和 57.0%。
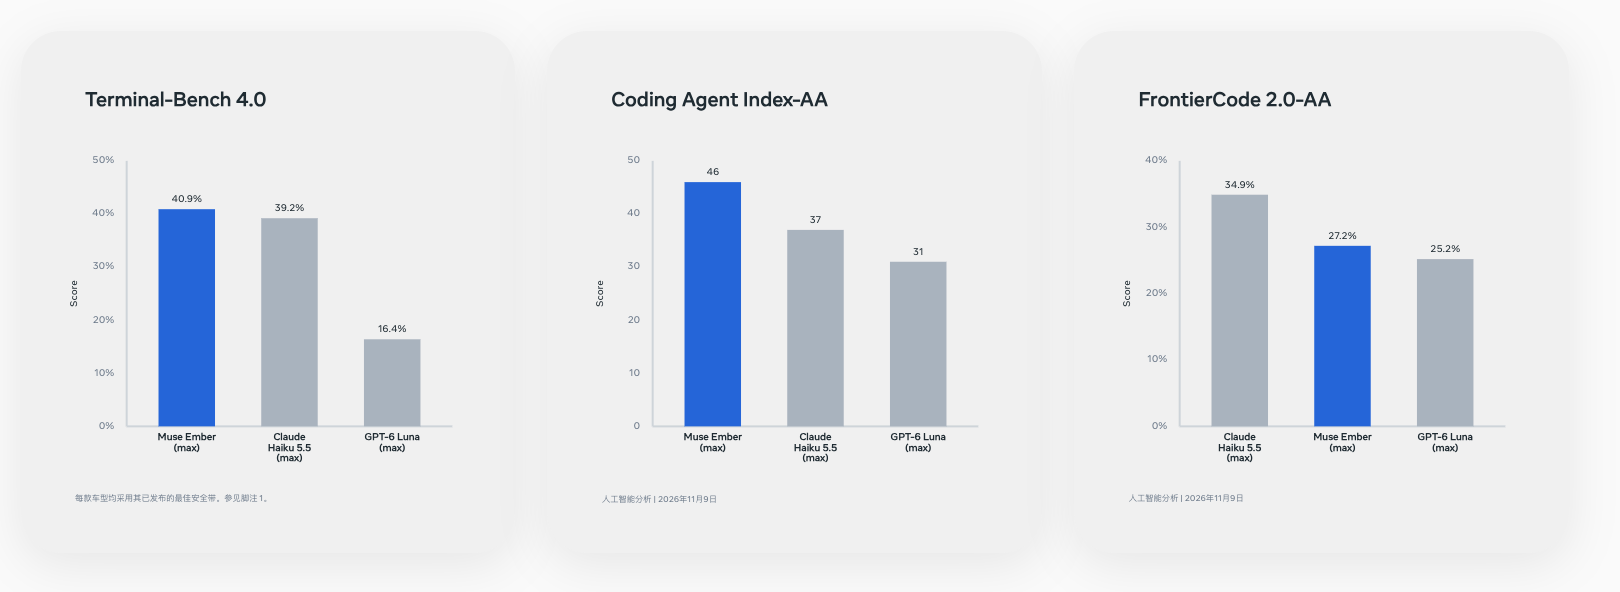
编程方面,Muse Ember 在 Terminal-Bench 4.0 中取得 40.9% 的成绩,略高于 Claude Haiku 5.5 的 39.2%,明显高于 GPT-6 Luna 的 16.4%。
不过,Muse Ember 并非在全部测试项目中领先。例如,在衡量真实工程任务及代码可合并性的 FrontierCode 2.0-AA 中,Claude Haiku 5.5 取得 34.9%,而 Muse Ember 为 27.2%。
目前,Muse Ember 已通过 Meta Model API 开放,正式定价为每百万输入 Token 0.10 美元、每百万输出 Token 0.50 美元。
Cloudflare、Cline 等实测:最快达 2.2 秒延迟
在正式发布前,Meta 已邀请多家合作伙伴测试 Muse Ember,覆盖企业文档处理、编程、软件工程以及高吞吐量 Agent 任务等场景。
其中,企业内容管理平台 Box 的 AI 产品副总裁 Yashodha Bhavnani 表示,Muse Ember 在 Box AI Complex Work Eval 中展现出了较好的准确率、速度和 Token 效率。
例如,它可以根据企业的合同谈判规则,逐条评估合同条款,并给出整体风险等级;也可以根据详细的招聘要求筛选候选人,识别那些虽然不完全符合首选标准、但仍然值得保留为备选的人选。
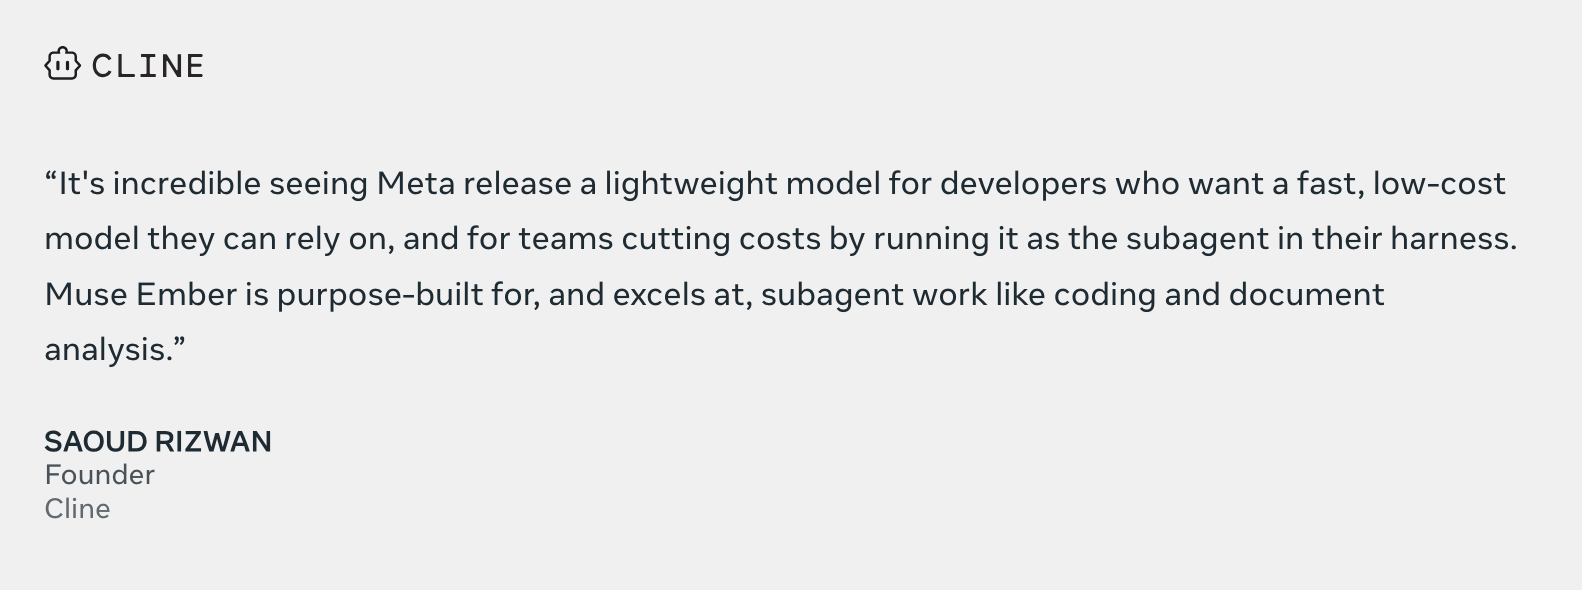
AI 编程工具 Cline 的创始人 Saoud Rizwan 则特别提到了 Muse Ember 作为子 Agent 模型的价值。
他认为,对于希望降低成本的开发团队而言,可以让 Muse Ember 承担编程、文档分析等重复性任务,而不必每次都调用价格更高的大模型。
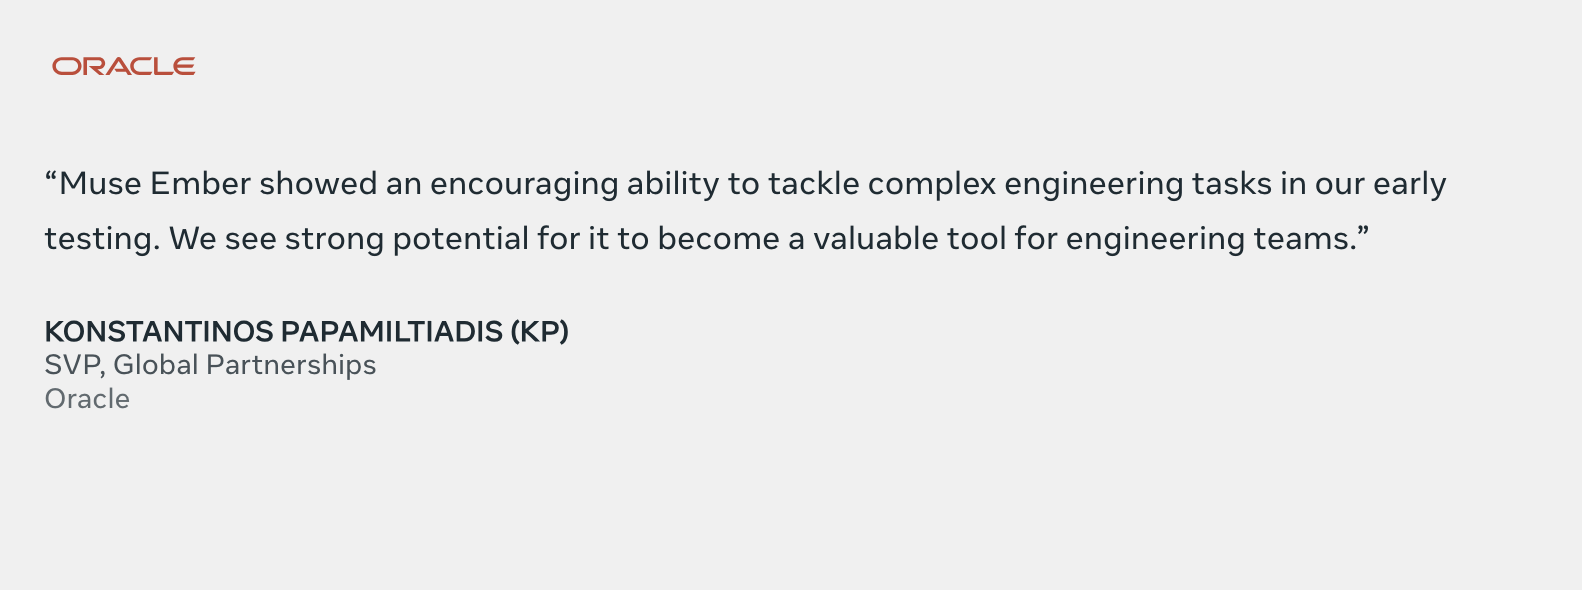
Oracle 全球合作伙伴高级副总裁 Konstantinos Papamiltiadis 也表示,Muse Ember 在早期测试中展现出了处理复杂工程任务的潜力。
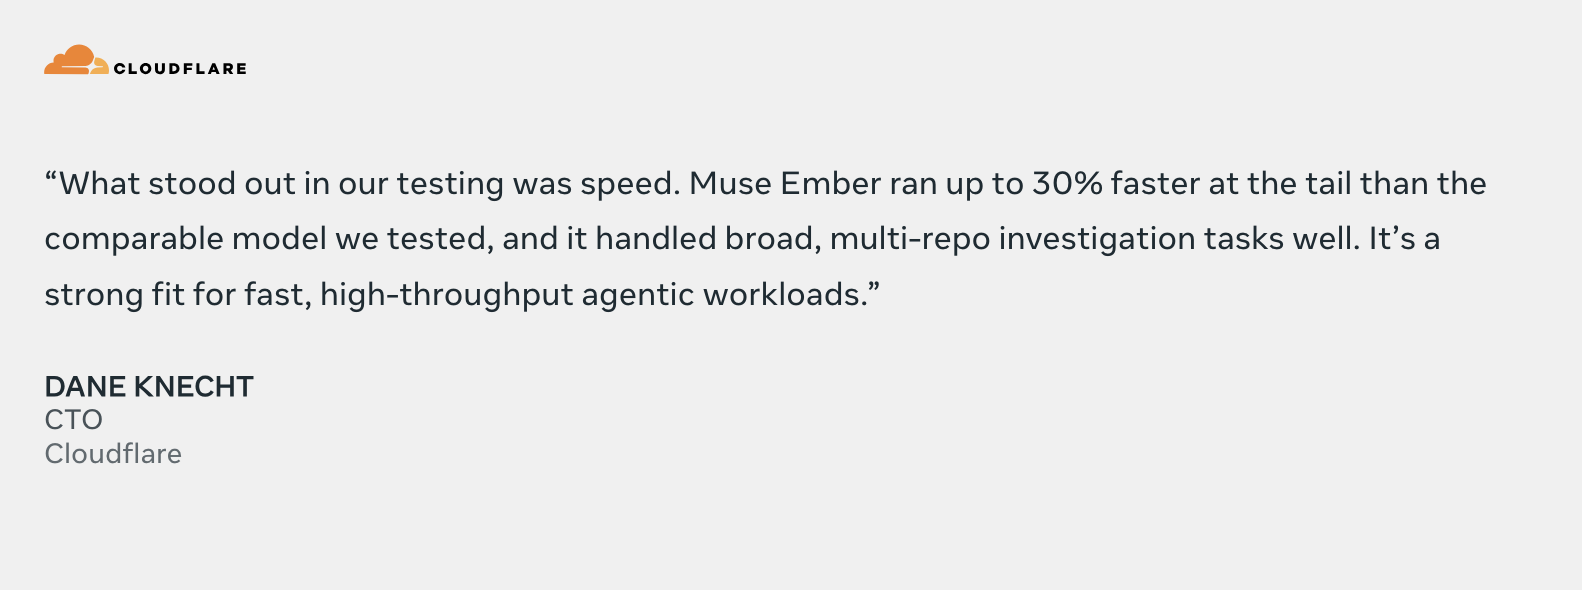
在运行效率方面,Cloudflare 首席技术官 Dane Knecht 提供了另一组数据。
根据 Cloudflare 的测试,Muse Ember 在尾部延迟方面比其测试的可比模型最多快 30%,同时能够较好地处理涉及多个代码仓库的大范围调查任务。
搜索及 AI 服务公司 You.com 的测试结果则更加突出。
You.com 推理负责人 Chak Pothina 表示,在其测试的编程任务中,Muse Ember 完成了全部任务,并且在受测模型中具有最低延迟。
具体而言,其 P95 延迟为 2.2 秒,速度约为部分领先开放权重模型的 4 至 13 倍,同时输出 Token 数量减少了 36% 至 48%。
Agent 能力:一次读入完整代码库,支持百万 Token 上下文
在介绍完合作伙伴的测试反馈后,Meta 将重点转向 Muse Ember 的三项主要能力:Agent、编程和多模态。
首先是 Agent。
Meta 认为,Agent 在执行实际工作时,大部分 Token 消耗并不一定发生在最复杂的推理环节,而是来自大量规模较小、结构相对固定的操作。
例如,一个企业 Agent 可能需要先读取客户记录,再调用相关工具,随后更新多个业务系统中的信息。整个过程中,模型需要反复处理数据、判断下一步操作并执行相应指令。
Muse Ember 正是为这种高频任务设计的。
它能够完成端到端业务流程,包括检索记录、依次调用工具,以及跨应用更新系统数据。
同时,Muse Ember 提供了 100 万 Token 的上下文窗口,最大输出长度达到 51.2 万 Token。
这意味着,对于规模适当的代码库或文档集合,开发者可以在一次调用中提供大量上下文,而不必频繁拆分输入内容。
在 Agent 能力测试中,Meta 重点公布了三组数据。
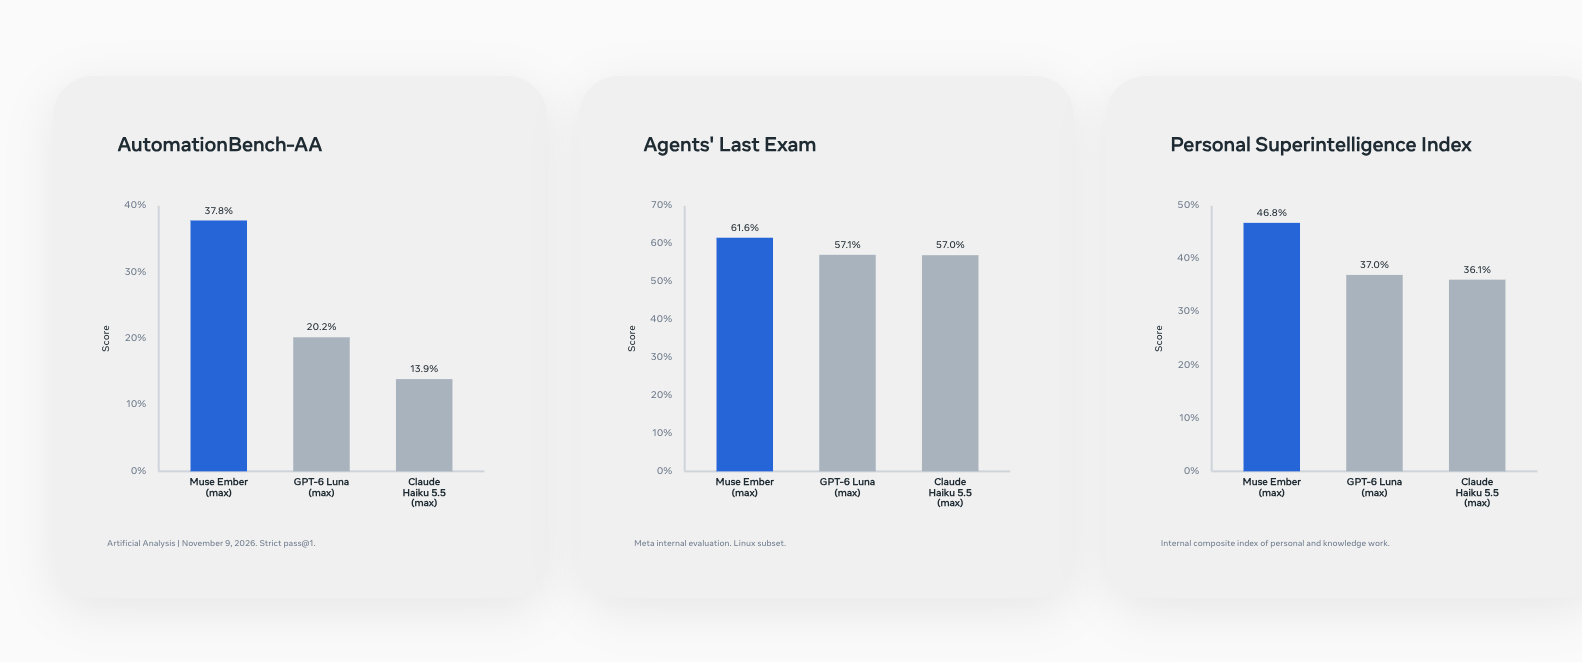
其中,AutomationBench-AA 主要考察端到端业务工作流执行能力;Agents' Last Exam 则侧重完整 Agent 任务;Personal Superintelligence Index 是 Meta 用于评估个人及知识工作任务的内部综合指标。
从这些数据来看,Muse Ember 的优势主要体现在任务执行环节,而不只是生成答案。
对于正在部署 Agent 的企业而言,这也提出了一个值得关注的方向:未来 AI 系统中的大部分任务,是否真的都需要由最强、最昂贵的旗舰模型来完成?
编程测试得分超过 Claude Haiku 5.5
除了企业工作流,编程是 Muse Ember 的另一项重点能力。
Meta 在博客中指出,一个编程 Agent 在执行任务时,可能需要数百次调用子任务,包括读取文件、运行测试以及针对特定问题修改代码。
对于这类操作,模型的调用频率、执行速度和成本,直接影响整个编程 Agent 的工作效率。
在 Terminal-Bench 4.0 测试中,Muse Ember 以 40.9% 的成绩略微领先 Claude Haiku 5.5 的 39.2%,并明显超过 GPT-6 Luna 的 16.4%。
在 Coding Agent Index-AA 中,Muse Ember 同样排名第一,得分为 46,Claude Haiku 5.5 和 GPT-6 Luna 分别为 37 和 31。
不过,面对更复杂的工程问题,Muse Ember 仍然存在局限。
在 FrontierCode 2.0-AA 中,Claude Haiku 5.5 以 34.9% 的成绩领先,Muse Ember 得分为 27.2%,GPT-6 Luna 则为 25.2%。
这一结果也反映了不同编程任务对模型能力要求的差异。读取文件、运行测试和局部代码修改,与解决涉及多个模块、需要满足实际合并要求的工程问题,并不是一回事。
Meta 对 Muse Ember 的定位也并非完全取代旗舰模型。
其在博客中明确提出,对于最困难的问题,可以将 Muse Ember 与 Muse Wonder 搭配使用。
其中,Muse Wonder 负责规划复杂任务,Muse Ember 则承担大量具体执行工作。
这种分工实际上对应了一种正在形成的 Agent 架构:由高能力模型负责全局规划、复杂推理及关键决策,再由成本更低的模型承担高频执行任务。
如果能够有效协调不同模型的调用,这种方式有望在保持任务完成质量的同时,降低整个 Agent 系统的运行成本。
在多模态方面,Muse Ember 原生支持文本、图像、音频和视频理解。
Meta 表示,这意味着 Agent 可以使用同一个模型读取屏幕截图、图表、扫描文档,也可以处理语音备忘录、会议录音和视频内容,而不必为每一种输入单独调用不同模型。
目前,Muse Ember 已正式通过 Muse Code 和 Meta Model API 上线,模型名称为 muse-ember-1.0,并支持 Responses API。
定价方面,Muse Ember 的价格为每百万输入 Token 0.10 美元,每百万缓存输入 Token 0.004 美元,每百万输出 Token 0.50 美元。
值得关注的是,Muse Ember 还是 Meta 首款使用 Muse Wonder Full 训练的模型。Meta 此前发布 Muse Wonder 和 Muse Wonder Full 时便表示,将使用这些高能力模型开发更加专业化的模型,并进一步面向开发者和普通用户提供服务。
随着 Muse Ember 发布,Meta 也进一步明确了不同模型的分工:Muse Wonder 负责最复杂的问题,Muse Spark 侧重编程和 Agent 工作流,Muse Ember 则用于大规模、可重复的编程及 Agent 任务。
在官方公布的对比中,Muse Ember 与 Muse Spark 1.3 的成本差距尤为明显。
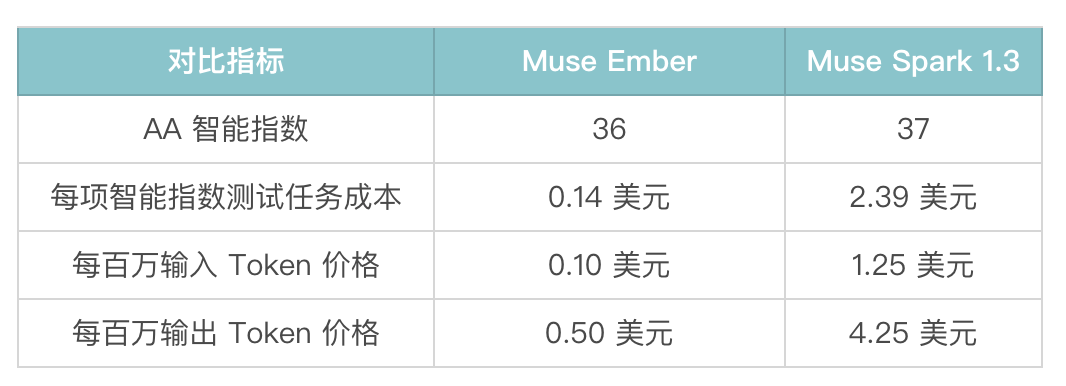
按照 Meta 公布的数据,Muse Ember 的 Artificial Analysis 智能指数仅比 Muse Spark 1.3 低 1 分,但单任务成本从 2.39 美元降至约 0.14 美元,下降约 94%,相当于前者的约十七分之一。也就是说,开发者如果只关注这项智能指数,Muse Ember 能够以远低于 Muse Spark 1.3 的成本取得接近的成绩。当然,这并不意味着它在所有任务中都能够替代 Muse Spark。
这种差距也解释了 Meta 为什么要推出一款更小的模型。
当 Agent 从简单的问答助手,逐渐演变为能够调用工具、运行代码、操作计算机的复杂系统,模型调用次数将随任务执行过程不断增加。
对开发者而言,决定系统能否大规模部署的因素,除了单次推理的能力,还包括数百次、数千次调用累积形成的成本,以及任务执行的稳定性。
Meta 在博客结尾重申,其目标是让 AI 帮助人们实现个人目标、创造内容、深化关系,并采取有价值的行动。要让这种能力真正普及,光有前沿模型还不够,还需要让使用成本具备可扩展性。
公司同时透露,目前还有效率更高的模型正在训练中。
参考链接:


