随着 Agent 开始承担更长、更复杂的任务,如何让 Agent 从执行中积累经验、持续改进自己,正在成为新的技术方向。
今年 7 月,一篇针对 2024—2026 年 1250 篇相关论文的 RSI 综述《Recursive Self-Improvement in AI: From Bounded Self-Refinement to Autonomous Research Loops》显示,AI 自我改进已经形成相当广泛的研究版图。研究对象从部署阶段的行为、训练阶段的策略,进一步延伸到评估器乃至 AI 研究过程本身。这意味着,RSI 所讨论的“自我改进”,正在从单一对象的优化,扩展到 AI 系统不同环节的持续迭代。
围绕 Agent 的自我改进,openJiuwen 也已经进行了一系列探索。openJiuwen 是由华为 2012 实验室、华为云、终端、计算等团队联合构建的开源 AI Agent 平台。今年 6 月,openJiuwen 发布 Auto Harness,让智能体能够根据任务执行结果,自动优化 Prompt、Skill、Tool、Rail 等自身“工作装备”。这一次,openJiuwen 又将优化对象进一步扩展,发布了完整的 RSI 框架。
这套框架首先回答了 RSI 的优化逻辑。openJiuwen 将优化对象分为 Harness 和 Artifacts 两个维度。Harness 包括 Prompt、Skill、Tool 和 Rail,决定 Agent 如何完成任务;Artifacts 则是 Agent 最终生成的交付物,目前覆盖科研论文和算法程序。由此,Agent 的工作方法和工作成果,都可以进入持续迭代。
其次是如何证明优化有效。openJiuwen 将改进放进一套可验证的工程闭环:先建立基线,根据失败、执行轨迹和指标定位问题,再生成候选版本并重新执行、评测。只有验证有效的修改才会被采纳,成功和失败的经验则继续进入下一轮迭代。
目前,这套 RSI 框架已经落地到 WorkSwarm 蜂群办公智能体,形成“可插拔 Harness + Artifacts”双维度优化。同时,针对 RSI 反复生成、执行和评测带来的计算开销,openJiuwen 引入算力亲和能力,减少重复计算和资源消耗。
由此,openJiuwen 将 RSI 落成了一条可以实际运行的工程链路:发现问题、提出改进、执行验证、保留有效版本,并将经验带入下一轮。
接下来,我们具体看看这套框架如何运行。
openJiuwen RSI 框架:让自我迭代真正跑起来的工程闭环
openJiuwen RSI 不是一套固定的优化算法,而是让不同自我迭代任务都能稳定运行的工程框架。它以版本化优化对象、可验证的执行证据和可扩展的算法为核心,通过四层协作,把任务目标转化为可执行、可评估的改进过程。
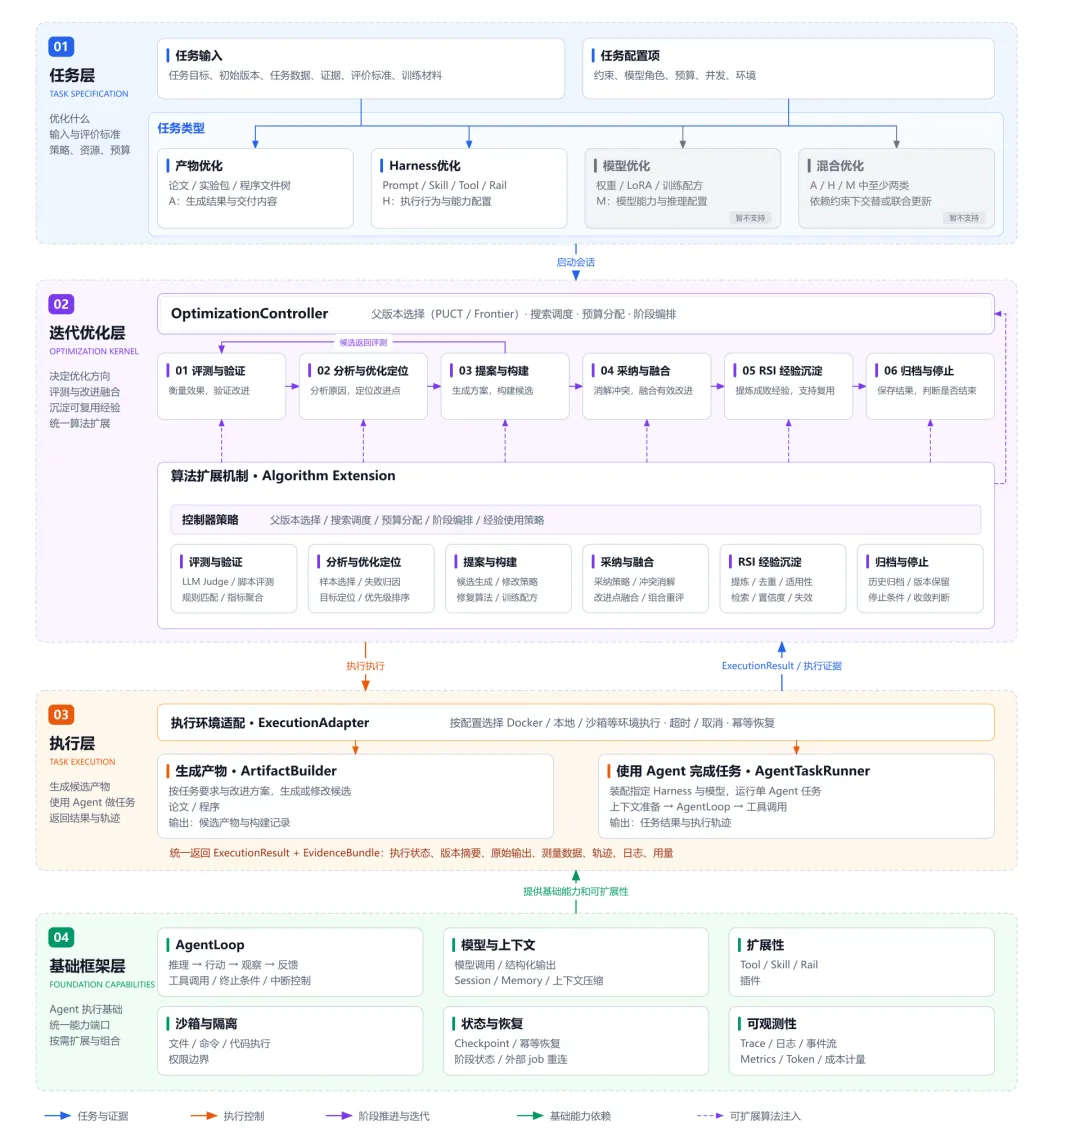
任务层定义"优化什么、如何评价、能用多少资源";迭代优化层决定"下一步试什么、哪些改进可以采纳";执行层负责"真正跑起来并返回证据";基础框架层提供运行、模型与上下文、沙箱隔离、状态恢复和可观测性等统一能力。
整个流程串起了六阶段闭环:评测与验证 建立基线;分析与优化定位 从失败、轨迹和指标中找到原因;提案与构建 生成候选,再按同一标准重新评测;采纳与融合 消解冲突、组合有效改进,形成新版本;RSI 经验沉淀 提炼方法及适用条件;最后通过归档与停止 保存结果、判断是否结束。只要还有预算和改进空间,就会选择父版本继续迭代。
可靠性来自明确的分工。AgentLoop 负责单次任务的“推理—行动—观察—反馈”,控制器负责跨版本优化,避免用生成者的主观判断代替验证。每份证据都绑定版本和评价上下文,候选经过过滤、融合或配置变更后必须重测;执行失败、证据无效和效果不佳也会分别记录。问题、假设、改进点及采纳或未采纳的原因都会保留,让下一轮既能借鉴成功,也能避开无效方向。
在统一的任务表达、阶段接口和生命周期下,不同对象可以采用各自的算法:
科研论文优化 接收研究目标、初稿或实验材料及评价标准,通过 Frontier 选择父版本,提出研究方案,构建包含研究内容和实验结果的论文,再经论文评测决定是否采纳。
科研算法程序优化 接收程序文件树、任务数据和标准,通过 PUCT 选择父版本、安排搜索,生成源码修改或修复方案。候选构建运行后,以脚本评测、规则匹配和指标聚合比较效果,指导下一轮搜索。
Harness 优化 先运行当前版本,依据任务结果和轨迹诊断,再装载候选重跑同一组任务。只有经过自身评测的改进才能被采纳,方法及适用条件也会随之沉淀。
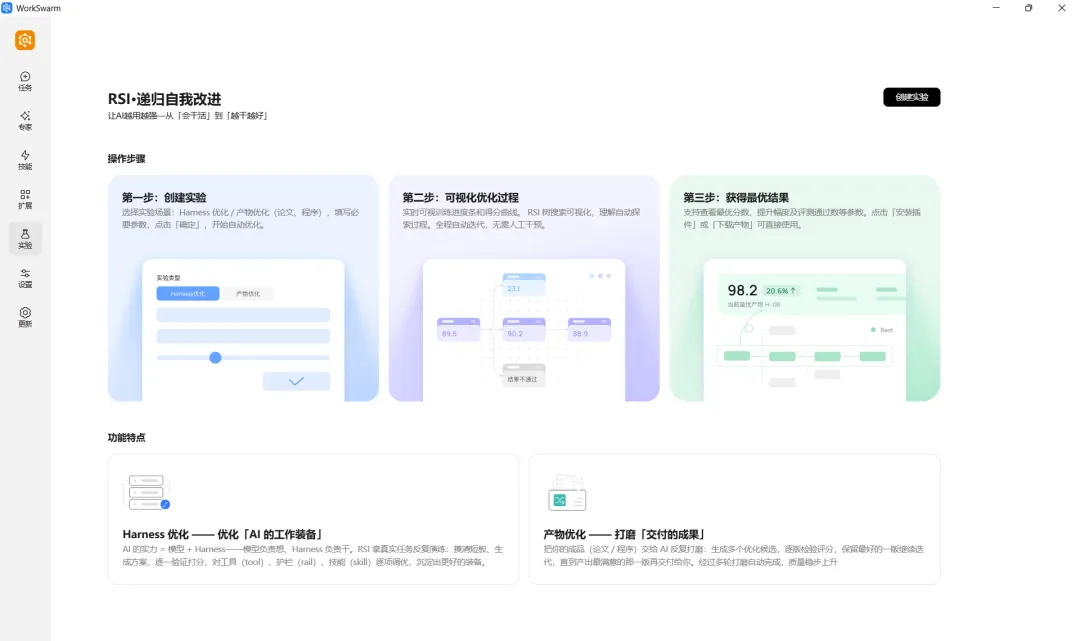
这套框架已经做进 WorkSwarm:新增的"实验"模式下,用户可以像创建普通任务一样发起 Harness 优化或产物优化,查看每一轮的改进过程和搜索路径,最终拿到经过验证的 Harness 插件或论文、程序产物。下面分别看三类优化在 WorkSwarm 里的实战案例。
Harness 优化:四步把失败案例变成即装即用的新能力
Harness 是智能体的“工作装备”:Prompt 决定如何理解任务,Skill 提供专业方法,Tool 负责实际操作,Rail 则约束执行过程。当问题出在这些环节时,WorkSwarm 可以直接从失败案例入手,帮助用户改进装备。
构建优化数据。 准备一份 JSON 评测集,每条用例包含用例标识、任务要求、评测方式,以及参考答案和评分规则。建议优先选真实失败过的任务。
[ { "id": "case_001", "input": "需要 Agent 完成的任务", "judge_method": "llm", "reference": { "solution": "参考答案", "judge_rubrics": "评分规则" } }]创建实验。 进入 WorkSwarm 的"实验"页面选择"Harness 优化",填写实验名称,选择优化模型、测试模型和初始插件,再选择评测集、评测方式和最大迭代轮次,即可创建。
自动迭代。 WorkSwarm 先运行当前 Harness 建立基线,再从失败用例和执行轨迹中定位问题,围绕 Prompt、Skill、Tool 和 Rail 生成候选修改。候选先验证目标用例确实修好,再回放完整评测集确认整体有提升、没有改坏原本通过的任务。页面持续展示得分、迭代轮次、模型用量和搜索树,哪些方案试过、哪些被采纳,一目了然。
安装使用。 实验产出有效版本后,点击"安装插件",最优 Harness 即作为插件包导入并热加载,不用手工复制任何内容;版本信息保留,需要时可以回退。
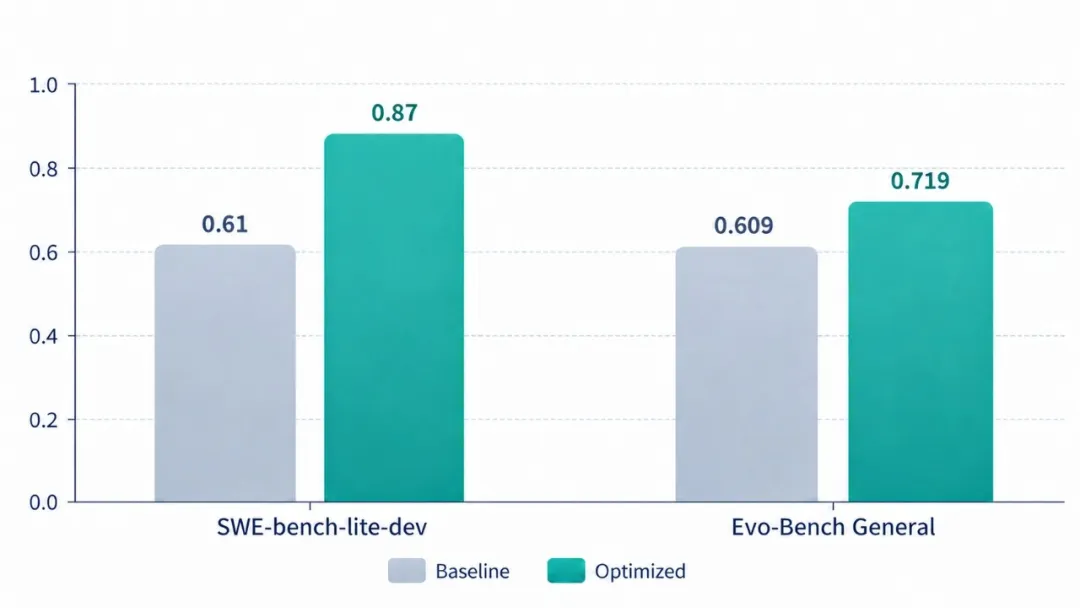
在 DeepSeek-V4-Flash 任务模型、最多 5 个 Epoch 的配置下,Harness 优化在 SWE-bench Lite Dev 全部 23 道题上的通过率由 61.0% 提升至 87.0%;冻结优化后的 Harness 后,在 Evo-Bench General 64 道独立评测题上的单次执行通过率由 60.9% 提升至 71.9%。结果表明,优化收益不仅覆盖参与迭代的任务,也能泛化到未参与优化的任务。
科研论文产物优化:从研究构想到论文成稿,持续打磨
在 WorkSwarm 中,既可以从一个科研构想出发生成科研论文,也可以提交已有科研论文继续优化。
在"实验"页面依次选择"产物优化"和"论文",填写优化指令(研究主题、目标问题或重点改进方向)或选择本地论文文件夹,设置最大迭代轮次,即可创建。
运行期间,详情页展示当前分数、最优论文、模型用量和迭代轮次;论文优化树记录每一轮产生的版本,点击节点可以看到本轮改动、评测结果以及未被采用的原因。实验完成后,预览当前最优产物,确认后一键下载完整论文。
科研算法程序产物优化:提交任务包,寻找更优版本
对于可以运行和评价的算法程序,WorkSwarm 支持从现有实现出发自动尝试多个版本,交付最优结果。
首先准备待优化的初始科研算法程序及其评价配置。推荐预先安装并调用 rsi-program-dataset-creator Skill,生成包含初始程序、scorecard 等运行和评价信息的任务包,再在"实验"页面依次选择"产物优化"和"程序",选择任务包文件夹,即可创建与启动优化。
优化过程中详情页展示当前最优分数、模型用量和程序优化树,每个节点是一个候选程序,点击可查看改动、评测结果和失败原因;中途可以暂停,之后再继续。实验完成后,一键下载经过多轮尝试和评测筛选的最优程序,用于后续验证、集成或开发。
算力亲和:把 RSI 多轮优化的成本降下来
RSI 的本质是拿算力换智力:反复生成候选、执行任务、评测结果,一次完整实验动辄成千上万次模型调用;优化过程中,提示词、工具描述和任务材料会反复使用,工具调用、评测和重试又带来频繁的暂停与恢复。如果每轮都重新计算相似上下文,优化规模越大,等待和资源开销就越高。
openJiuwen 算力亲和依托昇腾算力基础设施,让推理引擎"读懂"智能体的任务状态,框架通过 Agent Hint 把任务运行、等待、恢复和结束等信息传给引擎,帮助引擎在昇腾 NPU 显存、鲲鹏 CPU 内存和远端缓存池之间主动调度上下文缓存(KV Cache):等待时卸载到低成本存储,恢复前提前预取,结束后及时释放。从而降低多轮优化的时延与资源开销,让智能体在持续改进的同时更高效地使用算力。
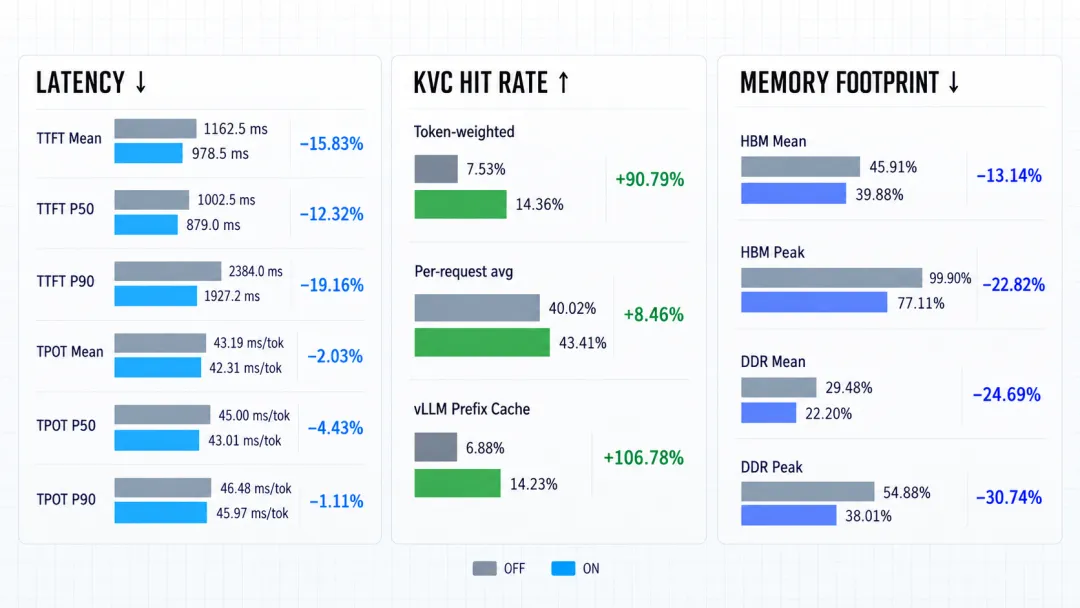
在科研算法程序优化的实验中也验证了这一收益,开启算力亲和后,TTFT(首 Token 时延)均值下降 15.83%、P90 下降 19.16%;Token 加权 KV Cache 命中率由 7.53% 提升至 14.36%;HBM 与 DDR 峰值使用率分别下降 22.82% 与 30.74%。重复 Prefill 少了,首 Token 更快,存储压力也更低。
结语
openJiuwen RSI 已经形成一条从创建实验到获得优化结果的完整链路:
Harness 优化会根据失败案例改进智能体的工作方式;
Artifacts 优化打磨科研论文和算法程序等交付产物;
再结合算力亲和,减少重复计算,降低资源开销。
从 Harness 到 Artifacts 的双维度优化,openJiuwen RSI 让优化成为用户可以发起、观察和复用的持续流程:每次改变都有证据,每次采纳都经验证,每轮经验都能帮助下一轮。
后续框架将继续丰富搜索、评测与融合算法,增强跨任务经验复用,并沿统一架构接入模型优化与混合优化,让 Harness、Artifacts 和 Models 在明确的评价标准、预算与安全边界内协同迭代。
值得一提的是华为云 AgentArts 将 openJiuwen 引入到商业化平台能力中,提供开箱即用的体验。感兴趣的朋友锁定华为 HC 大会,现场体验。openJiuwen 官方也提供了在线体验入口,Token 免费。
RSI 实验模式已在 WorkSwarm 上线,感兴趣的用户可前往官网一键下载,立即体验:


