核心要点
将 MCP 安全视为四个控制层而非单一的协议特性。执行、基础设施管理、出站信任与语义完整性都需要对应的强制执行点。
使用网关进行认证、授权与审计,但不要指望它能检测语义滥用或保护管理平面。
在注册时对工具 Manifest 进行固定,以避免批准后的模式漂移和“rug-pull”行为。将基于差异的评审作为运维模型,而非简单的允许/拒绝门控。
使用出站出口控制与作用域令牌。Azure MCP Server 的 SSRF 漏洞(CVE-2026-26118)表明仅有入站认证并不足以解决问题。
优先考虑可操作性:CI 门控、隔离工具、基于差异的 Manifest 评审与行为基线。规范会随后补上,但生产不能等待。
为什么写这篇文章,以及为何现在写
在 2025 年底,我们团队决定将 MCP(Model Context Protocol,模型上下文协议)作为生产级多智能体平台的集成层。我们只问了一个问题:在大规模的自动化(基于工具)执行之前,需要哪些架构控制才能让我们信任它?
简洁的答案,也是本文的论点,那就是需要四个层面:安全的工具执行、隔离的管理平面、受限的出站信任边界以及语义完整性,每一项都应该在其对应的可信任点上强制执行,而不是仅仅依赖网关。
这些层次在刚开始时并不明显,但接下来六个月的漏洞记录将它们勾勒了出来。在 2026 年最初的六十天中,针对MCP部署的CVE报告超过了三十个。
来自Adversa AI的三月份数据表明,在扫描五百多个 MCP 服务器时,38%的关键端点缺少认证,43%存在命令执行漏洞。微软在 3 月 10 日发布补丁修复了 Azure MCP Server 的 SSRF 漏洞(CVE-2026-26118,CVSS 8.8),该漏洞会导致托管身份令牌泄露。
在 3 月 9 日,主维护者 David Soria Parra 发布了2026 MCP路线图。文档将“企业就绪性”列为优先关注的领域,但同时指出在四个方向中它可能是最不明确的。
在 2026 年 4 月 2 日至 3 日的 MCP 开发者峰会上,亚马逊云科技与优步分享了它们的 MCP Gateway 与 Registry 的生产架构,Pinterest的工程团队也公布了其域专用的 MCP 服务器生态。企业级生产环境 MCP 的使用速度快于安全规范成熟的速度。
综上所述,这些并非孤立的缺陷。它们在少数的几个边界处聚集,这意味着需要架构性的响应而非零星的修补。本文描述了我认为如今每个生产环境的 MCP 部署都需要的架构控制模式。每种模式均与当前 MCP 规范兼容,不需要更改协议。
MCP 安全是一个控制平面的问题
在早期实现中,第一个直觉是将网关置于 MCP 流量之前。这是正确的直觉。网关是集中认证、授权、审计与策略评估的地方。InfoQ近期发布了一篇使用 MCP、OPA 与短期运行器(ephemeral runner)实现的最小权限 AI Agent Gateway 的详细实现文章,该设计非常接近理想情况。
然而,网关只是一个强制执行点,而不是完整的控制平面。网关无法确保工具处理器能够以安全的方式执行其参数,它无法隔离围绕 MCP 的检查器、测试工具与管理控制台,也无法阻止 MCP 服务器使用过宽的凭据发起不安全的出站调用。此外,网关也无法检测团队上周批准的工具定义何时会发生变化。
我对每一种 MCP 故障模式都会提出同一个问题:最早的可信强制执行点在哪里?
对于命令注入,答案是工具处理器和 CI 流水线;对于暴露的检查器(inspector),是管理平面和网络边界;对于通过出站请求泄露凭据,是出站策略与令牌作用域;对于工具定义漂移,是注册边界,在此处本应该对 Manifest 进行固定、差异比较与评审。
从形态上看,这就是控制平面,而不是单一的网关。在这些点上分散强制执行,也会将责任分散到构建、托管与运行 MCP 服务器的团队和厂商。CoSAI 的共享责任框架阐明了 AI 栈中安全责任的划分以及当智能体失效时该由谁负责。这些强制点将在下一节被规范化为四个控制层。
四个控制层
这四个层次并不能构成一个严谨的分类体系。它们各自独立存在依然具有一定的局限性,比如,加固执行环境对存在漏洞的出站路径毫无帮助,固定 Manifest 也无法证明检查器的身份合法性。每个层面都有其最早触发的强制执行点,并且通常由不同的团队负责。正是这些差异,决定了它们是相互独立的安全边界,而不是从四个不同角度看待同一个问题。
这种框架在业界与学术界也越来越常见。Acharya与Gupta(2026)提出了 MCPShield,这是一个将威胁划分为四类攻击面的安全框架。Rostamzadeh等人(2026)提出了防御布局分类法,指出现有缓解措施过于集中在工具层,而主机编排、传输与供应链层则防护不足。目前的共识是,MCP 防御是一个要分层处理的问题。
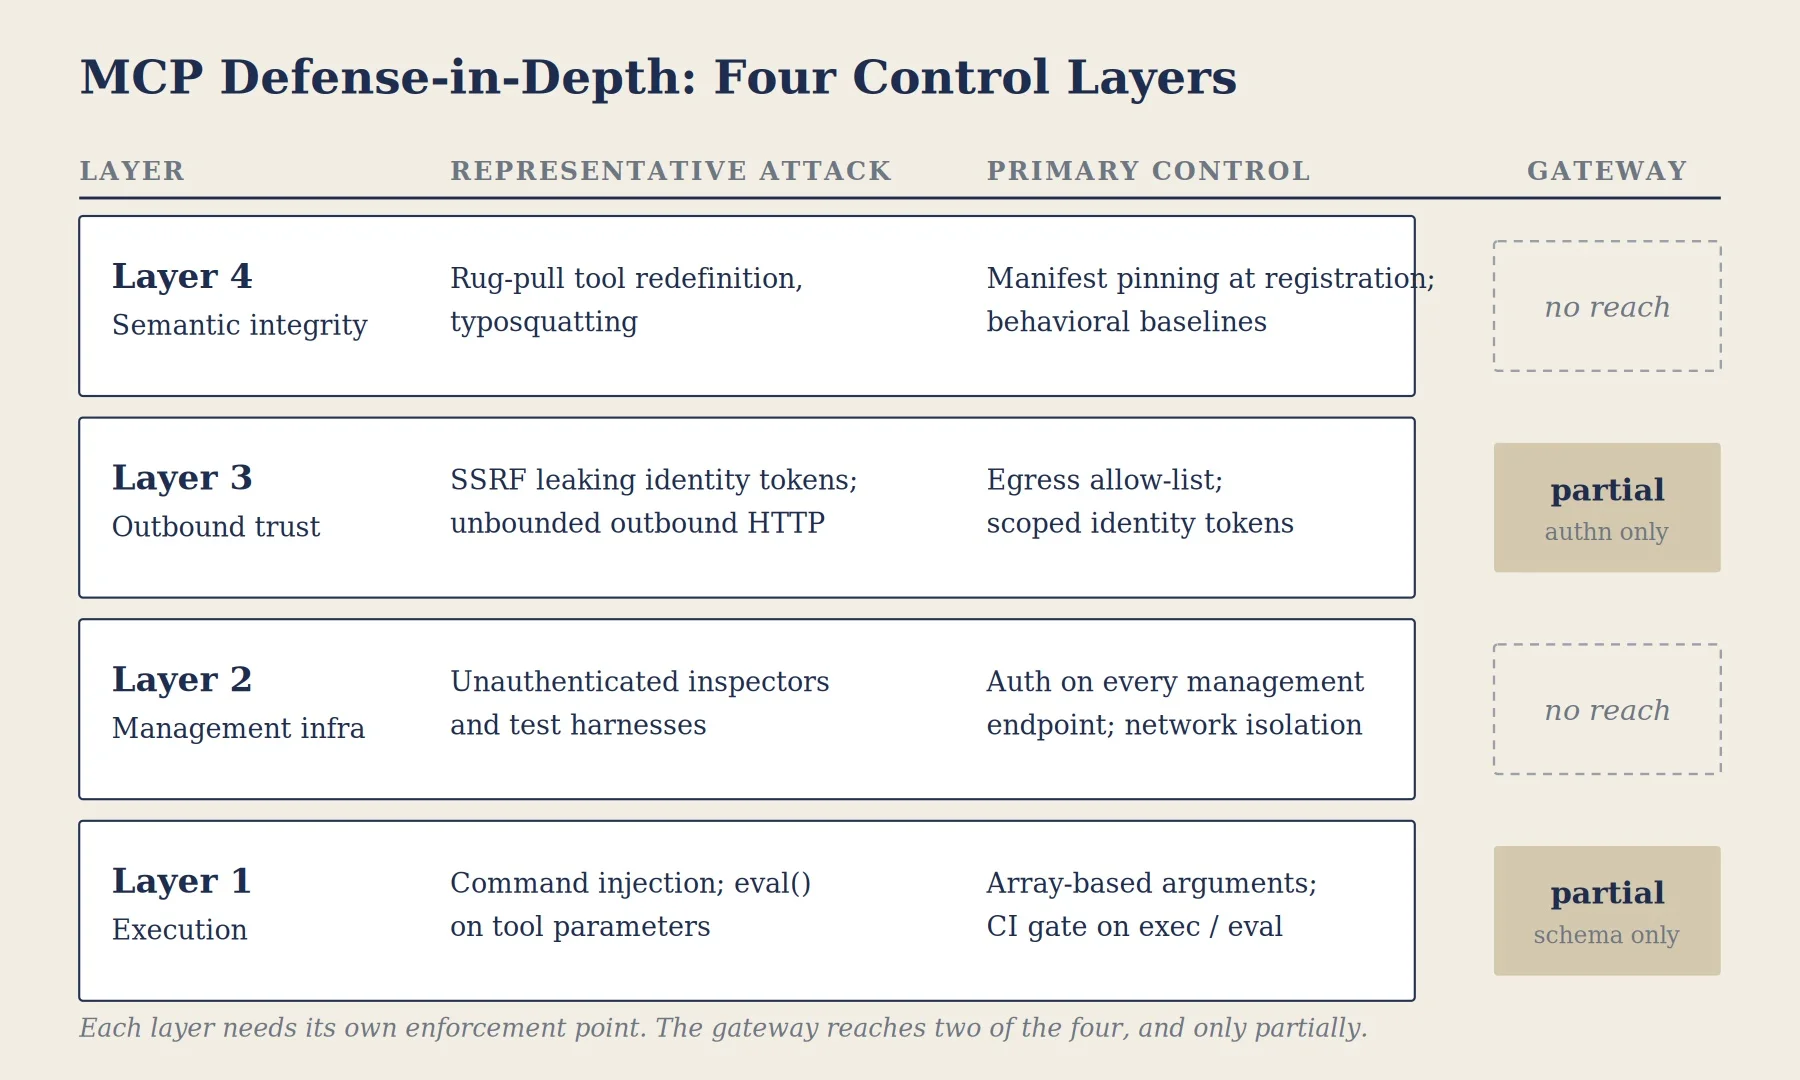
表 1. 四层控制矩阵
各层的概述如下:
第 1 层是执行,即在调用工具时运行的代码。
第 2 层是管理基础设施,包括检查器、harness、注册界面和管理控制台。
第 3 层是出站信任边界,即服务器自行可达的目标。
第 4 层是语义完整性,即工具定义随时间推移,其含义是否还保持一致。
每层都有不同的最早可信任强制执行点,并需要不同的主控制。网关只参与其中两层,并且只是是部分参与。
在确立模型后,文章接下来将逐层展开,给出相应的控制措施与实现代码。
第 1 层:安全的工具执行
第 1 层关注一件事,那就是工具处理器必须将其参数视为数据,而非指令。
在 2026 年前六十天记录的 30 个 CVE 中,有 13 个呈现出相同的模式:未验证的用户控制输入到达了 shell 或动态解释器。例如,CVE-2026-2130(mcp-maigret)、CVE-2026-2178(xcode-mcp-server)与 CVE-2026-2131(HarmonyOS-mcp-server)均通过 exec()执行了工具参数。CVE-2026-1977 在 Python 中对图表规范(chart specification)的参数使用了 eval()。CVE-2026-27203 通过未经验证的换行符操纵环境变量,导致在下次服务器重启后会触发载荷。
命令注入并不是什么新的概念。在 MCP 中,它之所以在架构上如此重要,主要原因在于信任模型。开发者将工具参数视为带类型的 JSON,伴随的 JSON 模式(schema)说明了输入结构,但它并未就值在 shell 执行环境下的安全性作出保证。
代码 1. 易受攻击与修复后的 shell 执行模式
// VULNERABLE: string interpolation into a shell commandconst { username } = toolCall.params;exec(`docker run maigret ${username}`);// If username is "; rm -rf /" the shell interprets the semicolon.// FIXED: array-based argument passing, no shell interpretation const { username } = toolCall.params; execFile('docker', ['run', 'maigret', username]); // Semicolons and metacharacters are passed as literal values.架构原则就是,工具处理器不是便捷的工具化包装器,而是受控的输入边界。
CI 规则比代码审查清单更为有用。下面的 Semgrep 规则会在构建时阻止将工具处理器的参数传入 shell 解释器的代码提交,这覆盖了大多数 MCP 服务器实现所用的两种语言。
代码 2. Semgrep 规则:阻止 MCP 处理器中的不安全执行
rules: - id: mcp-unsafe-exec-js languages: [javascript, typescript] severity: ERROR message: > MCP tool handler passes a parameter into a shell interpreter. Use execFile or spawn with array arguments instead. pattern-either: - pattern: exec(`...${$PARAM}...`) - pattern: exec($CMD + $PARAM) - pattern: eval($PARAM) - id: mcp-unsafe-exec-py languages: [python] severity: ERROR pattern-either: - pattern: subprocess.run(..., shell=True, ...) - pattern: os.system($CMD) - pattern: eval($PARAM)需要注意的是,这些规则是起点,并没有覆盖完整的生产环境。它们能够捕获常见的汇流点(sink),生产环境的规则集应该扩展到其他解释器、间接汇流点与特定语言的规避手段。
Huang等人构建了 114 个恶意 MCP 服务器的数据集,表明多组件攻击链常常比单组件攻击更有效。这一发现支持分层防御的方法,因为不应该期望任何单一控制机制能捕获所有的问题。每个信任边界都需要自己的防护。
第 2 层:保护管理平面
在评估 MCP 时,我们发现测试 harness 监听了一个没有认证的内部网络。关闭它只花了二十分钟,但它默认是开放的。快速部署 MCP 的团队大多在别人发现之前是不会注意到这种暴露的。
该测试 harness 属于管理平面的范围:授予信任权限和注册工具的界面,一旦它被攻陷,攻击者获得的远不止一次工具调用的权限。
在 30 个 CVE 中,有 6 个针对的是 MCP 的开发与运行基础设施,而不是协议本身。例如,CVE-2026-23744(MCPJam Inspector)打开了一个未认证的端点,默认监听 0.0.0.0,导致可安装任意的 MCP 服务器;CVE-2026-23523(Dive MCP Host)则利用精心构造的深链接在用户客户端应用内安装恶意配置。
这一层至关重要,因为开发环境通常比生产环境提供更多的访问权限,例如,源代码、密钥、构建系统与部署凭据等。管理平面的漏洞会让攻击者接触到授予信任权限与注册工具的环境,而不仅仅是一次工具调用。
我对 MCP 管理平面的期望与对 CI/CD 控制面的期望一致:
禁止匿名访问
默认不对外暴露广泛的内部网络访问
最小化文件系统的可达范围
尽可能使用短期凭据
管理端点必须认证并记录日志
把检查器、harness 和注册界面视为“接近生产”的组件,因为它们确实如此。
第 3 层:出站信任、出站限制与令牌作用域
第 3 层关注的是服务器在运行时能自行访问的目标。
Azure MCP Server 的 SSRF 漏洞(CVE-2026-26118,CVSS 8.8)说明了为何仅靠入站认证是不够的。攻击者将 Azure 资源标识符替换为恶意 URL,服务器使用其托管身份令牌向该 URL 发起出站调用,从而允许攻击者控制服务器可访问的 Azure 资源。
我们需要并行采用三项控制:
对每个入站端点强制认证。
受控的出站访问(即“egress allow list”),使服务器只能访问其运行所需的服务。
确保下游凭据的权限最小化,使令牌的影响范围与工具的影响范围相匹配。
代码 3. NetworkPolicy 限制 MCP 服务器的出站流量
# Allow egress only to internal services it needs and to DNS# All other egress traffic will be denied by default.apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: mcp-server-egressspec: podSelector: matchLabels: app: mcp-server policyTypes: - Egress egress: - to: - ipBlock: cidr: 10.0.0.0/8 ports: - port: 443 - to: - namespaceSelector: {} ports: - port: 53 protocol: UDP在这个场景下,有两点假设值得说明一下。第一,集群的 CNI 必须真正执行 NetworkPolicy(Calico、Cilium 等能够做到这一点,一些默认安装方式可能无法做到)。第二,在选定 pod 下列出 Egress 作为 policyTypes 会拒绝所有未明确允许的流量,但将其与命名空间范围内的默认拒绝策略配对使用会更明确,而不会产生这样选择的副作用。
自动化的文件搜索工具不应持有可控制公司云账户的访问令牌。如果工具需要访问新的域或内部服务,那应该是一次显式的变更,而非隐式行为。
这或许不是最有趣的工作,但却是最重要的。许多基于代理的系统保护了“前门”,但是忘记了进入进程后还能做什么。
第 4 层:语义完整性与 Manifest 固定
第 4 层关注的是语义,而非语法,也就是工具是否仍然保持着被信任时的含义。
我认为,最具架构意义的攻击并不是输入验证漏洞,而是语义层面的攻击。请求可能格式正确、模式合法、通过了认证,但仍然具有危险性,因为工具的含义在被授予信任后发生了漂移。
Pillar Security 在 2026 年 3 月指出了与 MCP 相关的 11 类漏洞(The New AI Attack Surface: 3 AI Security Predictions for 2026),包括供应链拼写仿冒与跨服务器上下文滥用。Solo.io 提出了“rug-pull”攻击,即服务器在注册后改变工具的定义。Maloyan与Namiot(2026)将该问题正式化为“缺乏能力认证”:协议缺少在执行时证明工具定义与客户端信任时一致的手段。
上述攻击并不能通过输入验证来阻止。输入是合法的,认证也阻止不了它们,因为调用者是被认证过的,网关策略也不能阻止它们,因为请求符合模式。
Manifest 固定能阻止这类攻击。需要明确的是,这是一种在网关处实现的模式,而非 MCP 规范本身的特性。该控制类似于 Web 的子资源完整性(Subresource Integrity)。在注册时,网关对服务器的工具 Manifest 进行规范化,对名称、描述与参数模式进行哈希,并将哈希作为签名基线存储。在重新连接或更新时,网关再次检查哈希值:若相同则允许更新;若不同,则将更新搁置并交由差异分类器,根据差异类别区分外观性修改与实质性的模式变化。
代码 4. 在 MCP 服务器注册期间固定 Manifest
import { createHash } from 'node:crypto';interface ToolManifest { name: string; description: string; parameters: Record;}const registry = new Map();const operatorQueue: Array = [];function canonicalJson(value: unknown): string { if (value === null || typeof value !== 'object') { return JSON.stringify(value); } if (Array.isArray(value)) { return '[' + value.map(canonicalJson).join(',') + ']'; } const obj = value as Record; return '{' + Object.keys(obj).sort().map(k => JSON.stringify(k) + ':' + canonicalJson(obj[k]) ).join(',') + '}';}function canonicalize(tools: ToolManifest[]): string { const sorted = [...tools].sort((a, b) => a.name.localeCompare(b.name)); return canonicalJson(sorted);}function pin(serverId: string, tools: ToolManifest[]): PinResult { const canonical = canonicalize(tools); const hash = createHash('sha256').update(canonical).digest('hex'); const existing = registry.get(serverId); if (!existing) { registry.set(serverId, { hash, tools, signedAt: Date.now() }); return { outcome: 'registered', hash }; } if (existing.hash === hash) { return { outcome: 'unchanged', hash }; } const diff = diffSchemas(existing.tools, tools); if (diff.cosmeticOnly) { registry.set(serverId, { hash, tools, signedAt: Date.now() }); return { outcome: 'auto-approved-cosmetic', hash }; } operatorQueue.push({ serverId, diff }); return { outcome: 'pending-review', hash };}递归辅助函数在每个层级对键进行排序,以确保相同的 Manifest 始终产生相同的哈希。建议在生产实现中使用诸如 RFC 8785(JCS)等既定的规范化 JSON 格式,这也固定了数字和字符串的编码方式。

差异分类器(diff classifier)使该控制在运维上是可持续的。纯粹的允许/拒绝门控会产生很多的误报,这样会训练自动化的运维员草率地执行批准操作。将外观性(cosmetic)改动与实质性模式改动区分开,意味着评审队列只包含那些真正需要人工决策的条目。
建议将 Manifest 固定与行为监控配合使用。监控每个 MCP 服务器实际访问的端点、数据移动量与延迟模式。当以文件搜索工具形式批准的服务器开始向未知域发起针对外部的 HTTP 请求时会触发告警,而无需逐条判断每个请求的模式合法性。静态信任与行为验证相结合,比单独使用任何一项控制都更有力。
目前,MCP 规范与 2026 MCP 路线图对 Manifest 固定均保持了沉默。这是各团队需要在网关层实现的功能。
网关的定位
网关仍然是必要的。关键是将网关正确地放置于这些层级之间,并明确定义哪些功能应该在网关之外。
网关提供了一个合适的平台,以实现客户端认证、按策略授权请求、维护审计轨迹和请求日志、提供速率限制(例如,基于单位时间的请求数进行限制)、管理注册工作流,并集中评估适用于传入请求的策略。这些示例体现了在协议层要强制执行的限制,这正是我们要创建网关所支持的功能。
相比之下,在安全执行、管理平面隔离、出站连接限制和语义漂移检测等方面的检查发生在不同层。因此,正确的做法是将网关视为多层安全解决方案的一个组成部分,并在每个最早的可信层上使用其他的技术方案进行限制。
优步在 4 月的 MCP 开发者峰会上关于 MCP Gateway 与 Registry 的演讲,以及 Pinterest 通过单一注册表使用多个域的专用 MCP 服务器并采用两层授权系统的实践,都体现了这一方法。该模式在生产环境中的趋同速度与研究中的趋同速度相当。
为期四周的推广计划
推广顺序需要遵循控制模型:先部署成熟且易于验证的控制,再部署 MCP 特有的控制。团队不需要同时实施所有控制,分阶段的方式通常效果更好。
表 2. 为期四周的推广计划。
第 1 周:稳定明显的边界
第 1 周要关闭那些不需要 MCP 特有工具即可处理的边界。对每个面向 MCP 的端点都要求进行认证,将检查器、测试工具与管理控制台迁移到隔离网络,并限制每个进程实际需要的文件系统访问。
第 2 周:执行路径安全
第 2 周要使执行路径变得更加安全。增加 CI 规则,标记可从工具处理器触及的 shell 插值、eval 或以 shell=True 调用的 subprocess,并将热点路径转换为数组参数传递。
第 3 周:信任限制
第 3 周要限制出站信任。在服务器层使用出站允许列表,并以工具特定的作用域令牌替换宽泛的服务凭据,使出站 HTTP 成为服务器被授予的能力而非默认持有的权限。
第 4 周:开始实现语义控制
第 4 周开始语义控制。在注册时启用基于差异的 Manifest 固定评审,并在两到三周的生产流量期间收集每个 MCP 服务器的行为基线(覆盖端点、数据量与延迟),在基线稳定后对偏差触发告警。
取舍权衡是难以避免的
上述每项控制都会通过牺牲某些方面来换取安全性:延迟、维护或灵活性。这些成本并不是偶然出现,在投入之前要先明确识别它们。
容器化或沙箱化执行会增加延迟。在我们的测试中,与本地执行相比,短期运行器(ephemeral-runner)隔离每次工具调用增加了 50 到 200 毫秒。这对后台智能体的工作是可接受的,但对交互式助手则较为明显。
出站允许列表会破坏需要新外部端点的 MCP 服务器。在我们的场景中,大多数 MCP 服务器连接三到五个内部服务和一到两个外部 API,因此允许列表是可管理的,但需要为每台服务器进行人工处理。
Manifest 固定会为演进中的服务器会带来一定的冲突。基于差异的自动化评审可以缓解该问题,但无法完全消除。
行为监控在基线稳定之前会产生成本与误报。在我们的部署中,大多数 MCP 服务器在两到三周的生产流量后会趋于稳定,低流量服务器则需要更长的时间。我建议将该时间视为我们的运维经验而非通用阈值,因为窗口取决于请求量与可变性。
这些成本是明确的。不过,重要的是,较之凭据泄露或工具重新定义被滥用造成的损失,这些成本要小得多。以我的经验来看,最常见的情况并不是团队过度保护 MCP,反而更加频繁地低估他们创造的不同信任边界的数量。
规范的发展方向
有两项进展值得我们关注。首先,从MCP 2026路线图可以看到,“企业就绪性(enterprise readiness)”是被反复提及的优先事项,尽管它也是四个领域中最不明确的一项,主维护者邀请“所有从生产到贡献都面临挑战的人”。其次,关于 NIST 在 2026 年 2 月启动的AI Agent Standards Initiative,NCCoE 有关于智能体身份与授权的概念性论文。作为 OASIS CoSAI 与 IETF AGNTCY 工作组的参与者,我可以说在 MCP 身份问题上还没有共识,特别是服务器是否应携带自身凭据,或应代表人类用户承载委托权限。CoSAI 在RSAC 2026之后发布了智能体身份与访问控制(Agentic Identity and Access Control)研究,直接讨论了该问题。
上述两项倡议都很有前景,但都不是不作为的借口。本文详述的控制方式与当前规范和基础设施均兼容,可以立即实施。
结论
回到文章开头提出的问题:在大规模信任工具执行之前需要哪些准备?这四个层次就是答案。在生产中部署 MCP 时,要考虑的最重要转变是不要再把它当作单一的协议问题,而应当视为一个分层的控制平面问题。
网关会一直存在。它是必要的,但仅靠它本身还是不够的。
真实的生产部署需要如下内容:第 1 层的安全工具执行,第 2 层的隔离管理平面,第 3 层的受限出站信任,以及第 4 层通过 Manifest 固定实现的语义完整性。每一层都有一个最早可信的执行点,而这个点通常并不是网关。
我留给团队的教训是:去保护第一个授予信任的边界,而不只是保护流量通过的边界。
这就是使 MCP 在运行方面值得信赖的方式。
查看英文原文:Securing MCP in Production: Defense-in-Depth Beyond the Gateway


