从「构建 AI」到「驾驭 AI」,100+ 实战案例拆解 AI Native 时代的工程新实践!
推理模型持续突破能力边界,Coding Agent 深度参与研发流程,Agent Runtime、Agent Framework 快速演进……AI 正在从回答问题的模型,演变为能够自主规划、调用工具、执行任务的软件系统。AI 不再只是软件中的一个能力,而开始成为软件系统的一部分。这意味着软件工程面对的挑战也发生了变化:团队需要思考的不再只是如何训练模型、模型、部署模型 或优化 Prompt,而不是如何让具备自主能力的 AI 稳定、可信、可控地运行。模型决定 AI 能做什么,系统决定 AI 能否真正创造价值。
在这一背景下,2026 年 QCon 全球软件开发大会大会 · 上海站正式启动。本次大会将于 10 月 22 日—24 日举办,聚焦 Harness AI 时代的工程实践,围绕 AI Native 架构、Agent Runtime、AI Infra、Data Systems、Agent 安全与可观测、Loop Engineering、Vibe Coding、具身智能与世界模型、端云协同等前沿技术方向,邀请全球技术社区与产业一线的实践者,系统性分享前沿洞察与实战经验,共同探索 AI 从能力到系统、从实验到生产的真实路径。
阿里巴巴高级技术专家杨林枫已确认出席 “AI Infra:算力效率决定规模化落地” 专题,并发表题为《从算子调优到推理自治:构建 MaaS 场景下的 AI Inference 自动优化闭环》的主题分享。MaaS 业务中的模型、硬件和请求工况变化较快。传统的部署调优和算子优化依赖人工完成需求分析、性能定位、算子开发、验证及上线,优化周期难以跟上生产负载的变化。本次分享将介绍一套面向 MaaS 生产场景的自动优化流程:给定卡型、模型和典型工况,探索合适的部署配置;从实际运行 Trace 中识别热门算子,并结合当前工况判断是否采用已有的算子融合模式;对典型工况进行归并、清洗、脱敏和泛化,生成可复现的 Benchmark;再由 Atrex Kernel Agent 通过 Agent Loop 完成性能分析、代码生成、验证和持续优化;最后将优化结果回接推理框架,进行端到端性能回归和灰度验证。分享将重点介绍算子优化,以及各环节之间如何衔接。
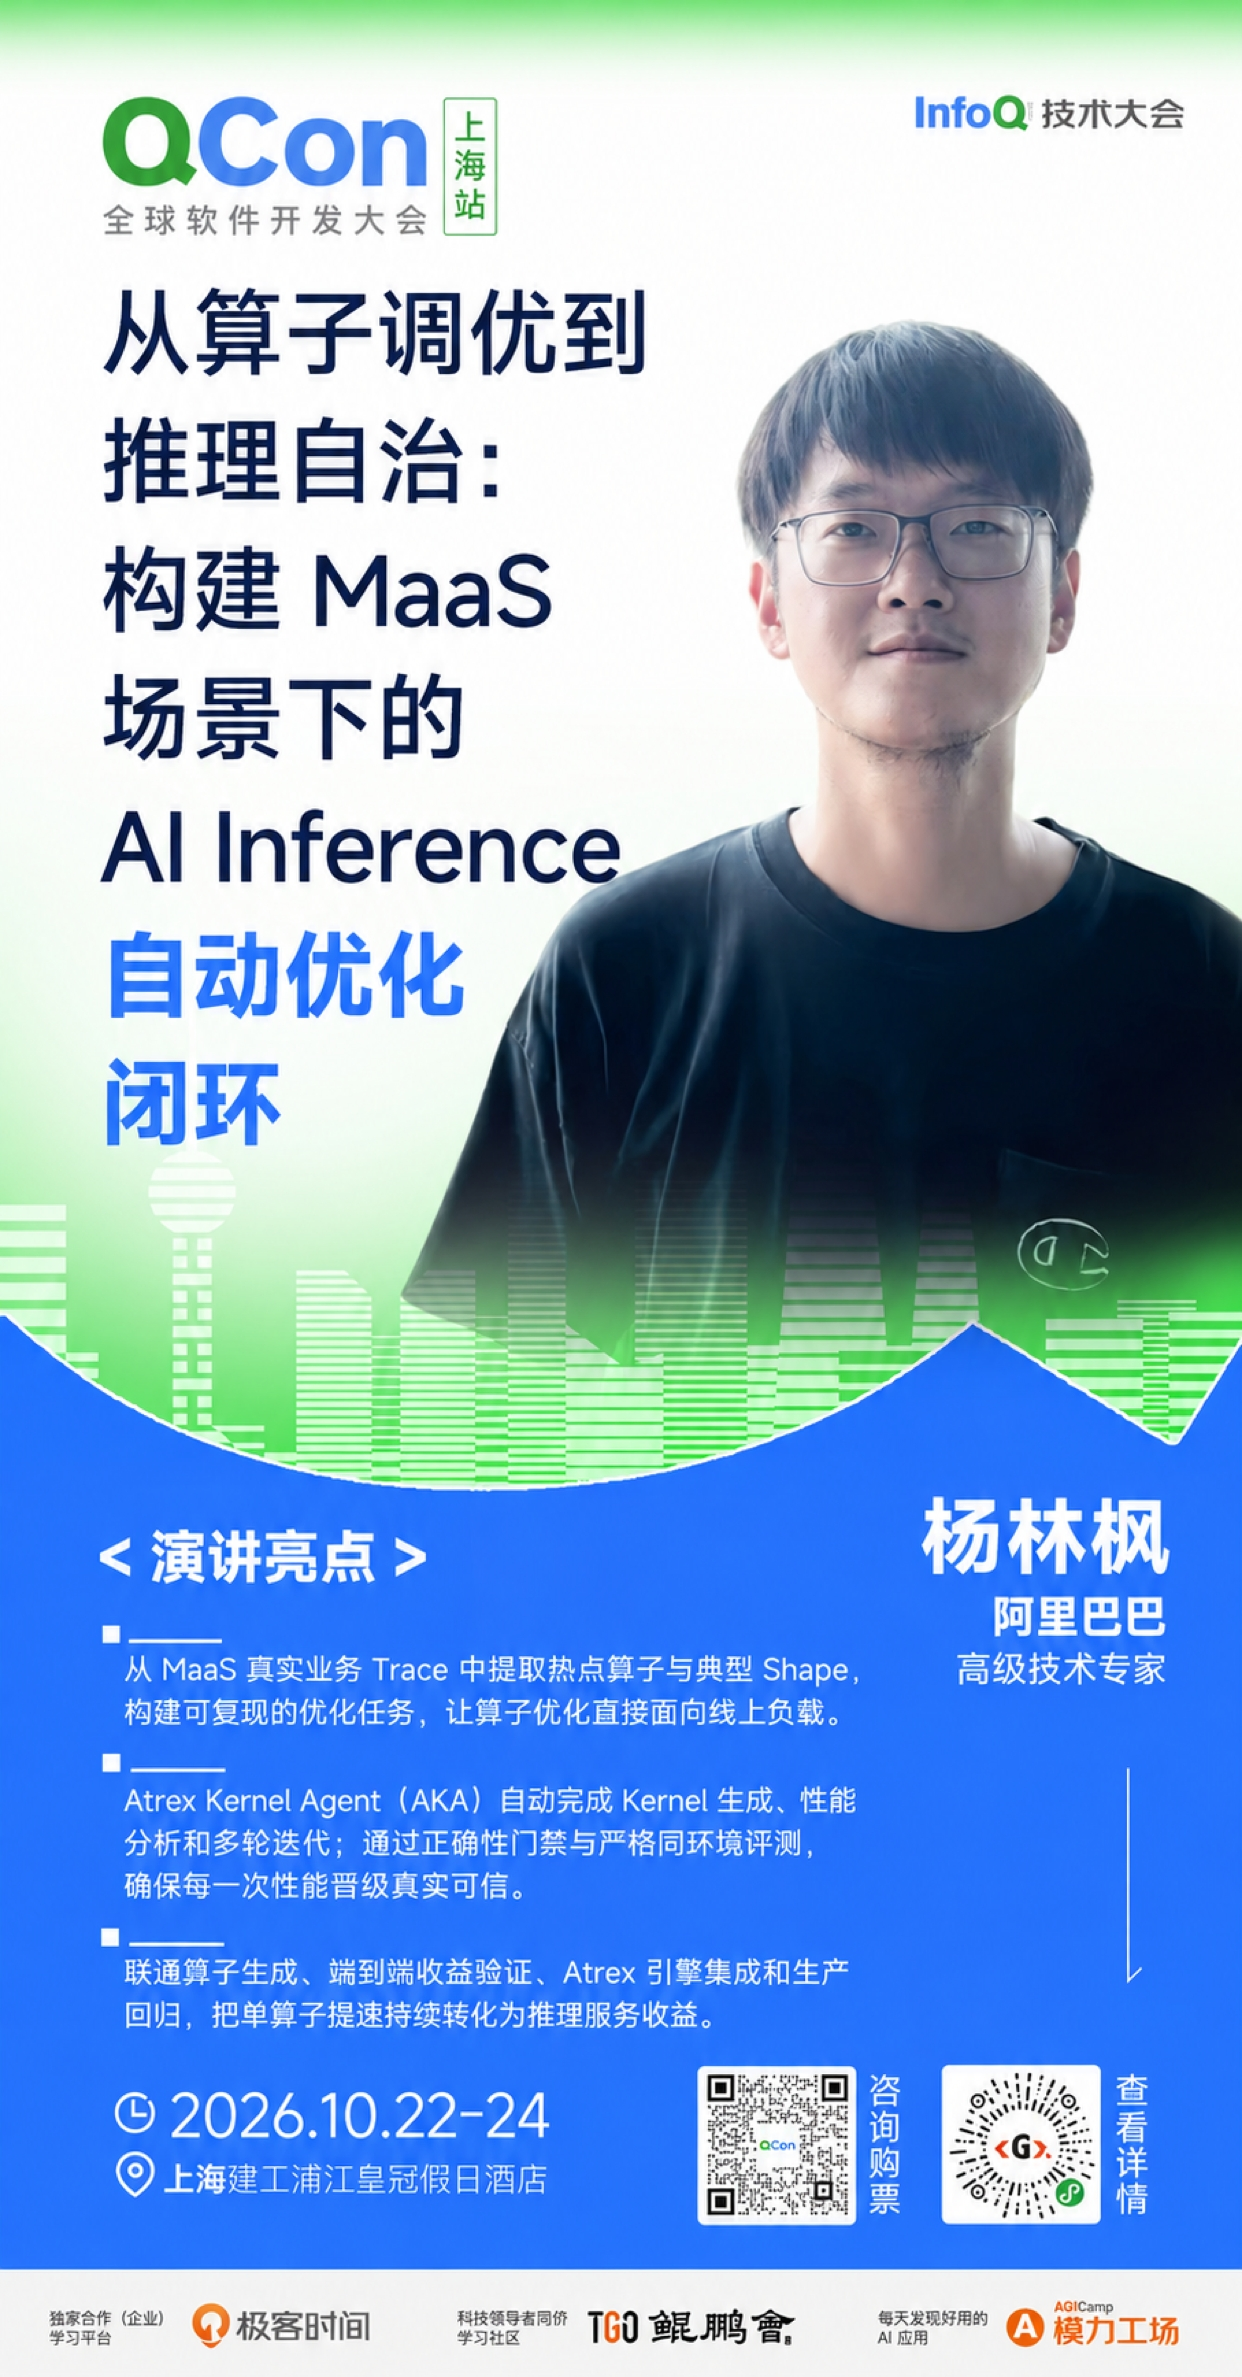
杨林枫,阿里巴巴高级技术专家,斯坦福大学博士。长期从事 AI 软件栈、AI 编译与算子编译工作,是开源 AI 框架 MindSpore 核心贡献者,曾主导昇腾算子编译器 SWFT 的设计与研发。现聚焦大模型推理、GPU Kernel 自动生成与长周期智能体工程,是 Atrex Kernel Agent 核心研发者,相关实践支撑阿里百炼 MaaS 大规模 GPU 集群的性能优化。也曾支撑 Qwen3.8 获得 NVIDIA SOL-ExecBench FlashInfer 算子优化榜首。他在本次会议的详细演讲内容如下:
演讲提纲:
为什么 MaaS 推理优化需要自动化
MaaS 场景中的模型、卡型、请求工况和部署配置持续变化
传统流程依赖人工完成需求分析、性能定位、算子开发和框架集成,整体周期较长
单算子 Benchmark 的优化结果不一定能转化为端到端收益
从部署配置探索、算子任务生成、Agent 优化到框架上线的整体流程
探索推理部署配置
给定卡型、模型和典型工况,探索并行策略、批处理及推理引擎配置
结合延迟、吞吐、显存和资源成本选择候选部署方案
根据实际运行 Trace 定位当前部署配置下的主要性能瓶颈
从生产 Trace 到算子 Benchmark
从生产 Trace 中识别热门算子,归并动态 Shape,选取典型 workload
结合卡型、模型、工况和算子 Trace,判断是否采用已有的算子融合模式
对生产工况进行去重、清洗、脱敏和泛化,形成可复现的 Benchmark
建立正确性、数值容差和性能评测标准,确定算子任务的优化优先级
Atrex Kernel Agent 的优化 Loop
Agent 循环进行 profile、瓶颈分析、方案生成、代码修改、验证和复盘
通过隔离会话、Git worktree、结构化 memory 和实验 journal 管理多轮优化
外围 Loop 负责实验预算、状态恢复、正确性门禁和终止控制,并使用完整 workload 与同卡 ABBA 测量验证性能收益
记录有效方案和失败实验,并结合代表性算子介绍一次完整的优化过程
优化结果回接推理框架并上线
将优化后的算子回接推理框架,检查接口、依赖和硬件兼容性
进行算子正确性与性能回归,以及模型端到端性能验证
通过灰度发布观察实际效果,并保留异常回滚能力
实践成果
支撑 Qwen3.8 获得 NVIDIA SOL-ExecBench FlashInfer 算子优化榜首
介绍百炼 MaaS 中面向不同卡型、模型和生产工况的优化实践
展示代表性算子的优化结果,以及回接框架后的端到端效果
实践痛点
生产工况变化快且存在长尾。采样过少可能遗漏重要场景,采样过多则会增加分析和评测成本
线上 Trace 不能直接作为 Benchmark,需要进行数据脱敏、Shape 去重、工况归并和可复现性处理
Agent 可能过拟合公开 Shape,也可能将 GPU 测量波动误判为性能收益
Kernel 局部变快不代表端到端一定有收益,仍需在推理框架和模型层重新验证
自动生成的代码在进入生产环境前,仍需经过正确性验证、性能回归、灰度发布和异常回滚
演讲前沿亮点
从真实生产工况中生成优化任务。 根据 MaaS 部署中的实际 Trace 识别热门算子和典型 workload,而不是只依赖人工提交优化需求
衔接部署配置与算子优化。 给定卡型、模型和工况,先探索候选部署配置,再从实际运行结果中提取算子任务
通过 Agent Loop 完成多轮算子优化。 Agent 负责性能分析和优化实验,外围 Loop 负责正确性检查、性能验证、状态恢复和终止控制
将优化结果放回框架验证。 算子优化完成后回接推理框架,以模型端到端结果判断实际收益
听众收益
了解如何从 MaaS 生产工况和运行 Trace 中提取可用于优化的算子 Benchmark
了解 Atrex Kernel Agent 如何通过 Agent Loop 完成多轮算子性能优化和结果验证
了解算子优化结果回接推理框架并进行端到端验证的基本流程
除此之外,本次大会还策划了Loop Engineering、千行百业 Agent 创新实践、Agent 自主进化:从记忆到持续学习、Agent as a Service、Vibe Coding 时代的新质量债、理性驾驭 AI 的 SRE 可靠性工程、金融 AI Native工程实践:从研发提效到业务破局、AI Infra:算力效率决定规模化落地、AI Native 架构等 20 个专题论坛,届时将有来自不同行业、不同领域、不同企业的 100+资深专家在现场带来前沿技术洞察和一线实践经验。
查看更多详情可扫码或联系票务经理 18514549229 进行咨询。