过去两年,AI 基础设施的竞争几乎围绕 GPU 展开。模型能生成多少 Token、每秒能输出多少 Token、每瓦功耗能够支撑多少推理吞吐量,成为衡量算力效率的重要指标。
但随着 AI Agent 从聊天问答走向软件开发、企业自动化和复杂任务执行,一个新的问题开始浮现:如果模型生成了代码,却要花很长时间才能完成编译和测试;如果推理速度足够快,工具调用、数据库访问和任务编排却跟不上,那么更快的 Token 生成速度,究竟能带来多少实际生产力?
这也让 CPU 在 AI 基础设施中的作用开始被重新审视。
Arm 云 AI 解决方案架构总监 Ravi Malhotra 在一场技术分享中提出,智能体 AI 正在改变 CPU 性能的评价逻辑。过去,AI 性能主要围绕 Token 生成展开,而在 Agent 场景下,基础设施不仅需要支持模型思考,还必须让模型生成的内容转化为真实行动。
这一判断的背景,是 AI 工作负载正在发生变化。Arm 此前发布的新评估方法,将智能体应用中的工具调用、任务编排、推理支持和端到端任务执行纳入 CPU 性能评价,并与富士通、Meta、OpenAI 等企业共同探索相关方法。
从行业角度看,这场讨论实际上指向一个更深层次的问题:当 AI 不再只是生成答案,而是持续执行任务,数据中心的算力分工是否需要重新调整?CPU 的价值,又该如何衡量?
Agent 时代,CPU 正从后台走向任务执行的关键环节
传统大模型推理主要依靠 GPU 等加速器完成密集计算,CPU 更多承担请求处理、资源调度、数据准备等工作。但 Agent 的工作方式有所不同。
以软件开发智能体为例,用户提出一个需求后,模型首先分析任务并生成代码,随后智能体需要创建文件、调用编译器、运行测试、检查错误,必要时再将结果反馈给模型,进入下一轮修改。
整个过程并不是连续不断地生成 Token,而是在模型推理与外部操作之间反复切换。
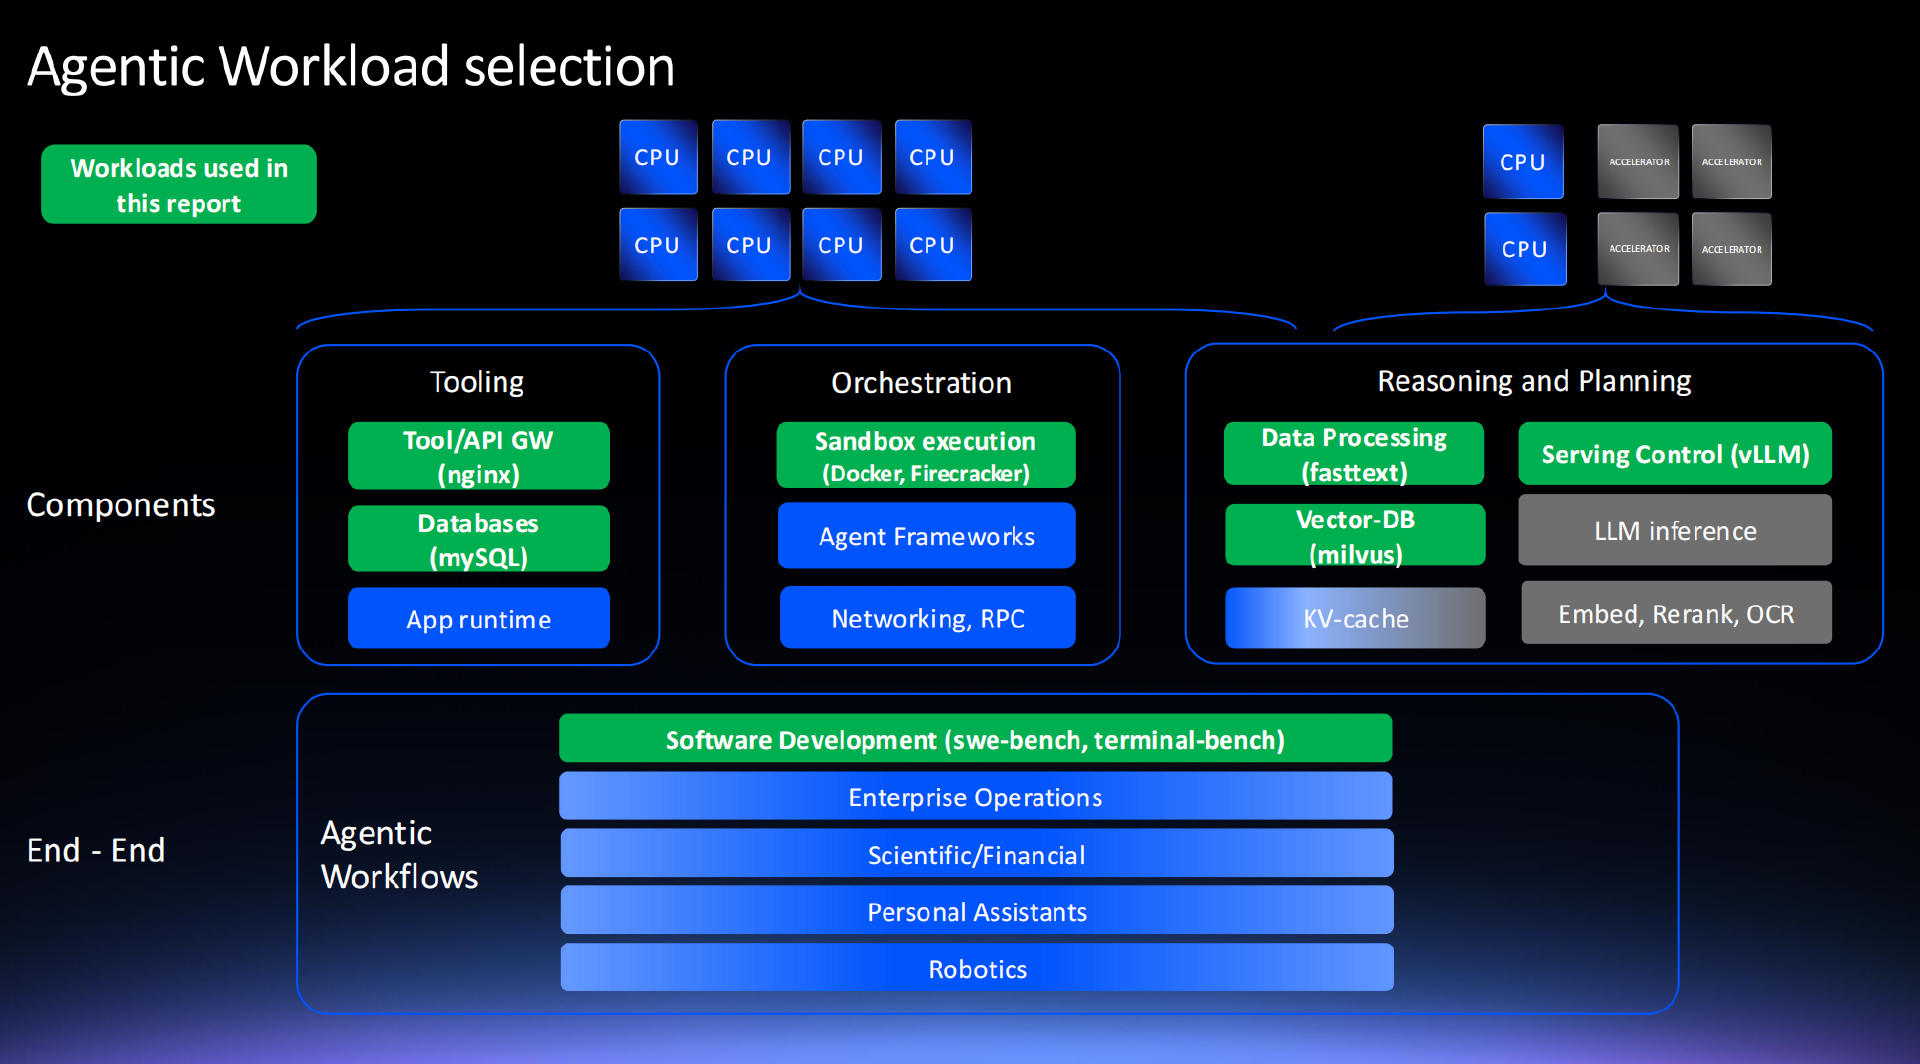
Ravi Malhotra 将这种工作负载分为两个主要部分:一部分是推理与规划,主要由 AI 加速器承担;另一部分是工具调用与编排,包括代码执行、数据库访问、沙箱运行等,大量依赖 CPU 资源。
“在智能体 AI 时代,CPU 的关键任务可以分为三类。”他表示,首先是将生成的 Token 转化为行动,其次是为推理提供数据和上下文支持,最后是负责工作流编排以及沙箱隔离。
这意味着,CPU 不再只是推理任务的辅助组件,而是决定 Agent 能否顺利执行任务的重要环节。
尤其是在软件开发场景中,编译和测试可能消耗大量 CPU 计算资源。如果 CPU 无法及时完成这些工作,后续模型推理就需要等待,昂贵的 GPU 也可能因为依赖前序任务而无法充分发挥效率。
Ravi Malhotra 指出,CPU 需要尽快完成自身承担的操作,使任务控制权重新回到 GPU 或其他加速器上。“如果 CPU 不够快,更昂贵的 GPU 就会处于闲置状态,而这是没有人希望看到的结果。”
当然,这并不意味着 Agent 越复杂,CPU 的工作量就一定越大。不同任务中的模型推理、工具调用及外部等待时间占比可能相差很大。真正需要关注的,是 CPU 是否处于整个任务执行链路的关键路径上,以及它的处理能力是否正在限制系统整体效率。
同样是 Agent,CPU 需求可能完全不同
Agent 给 CPU 带来的另一项挑战,是工作负载越来越难以用单一指标概括。
在分享中,Ravi Malhotra 将当前较有代表性的智能体应用归纳为五类:软件工程、企业自动化、科学与金融研究、个人助理以及机器人技术。
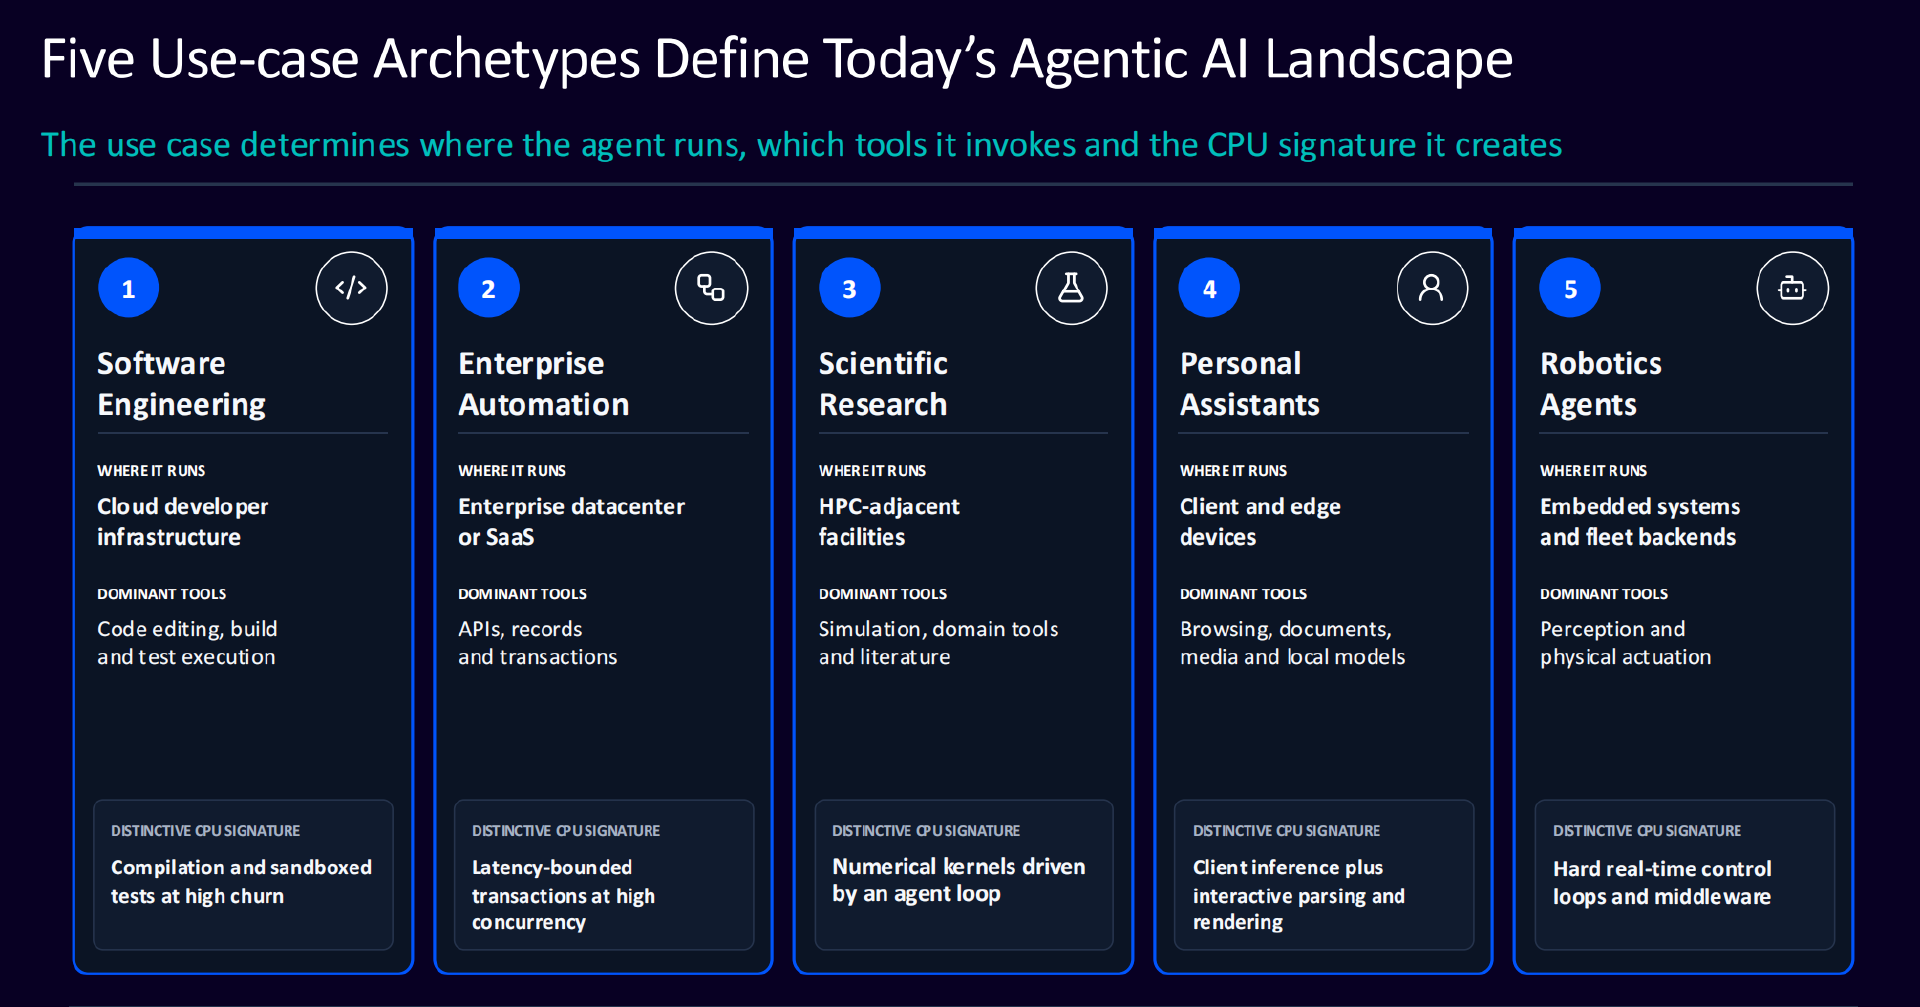
这些应用虽然都被称为 Agent,但底层的计算特征并不相同。
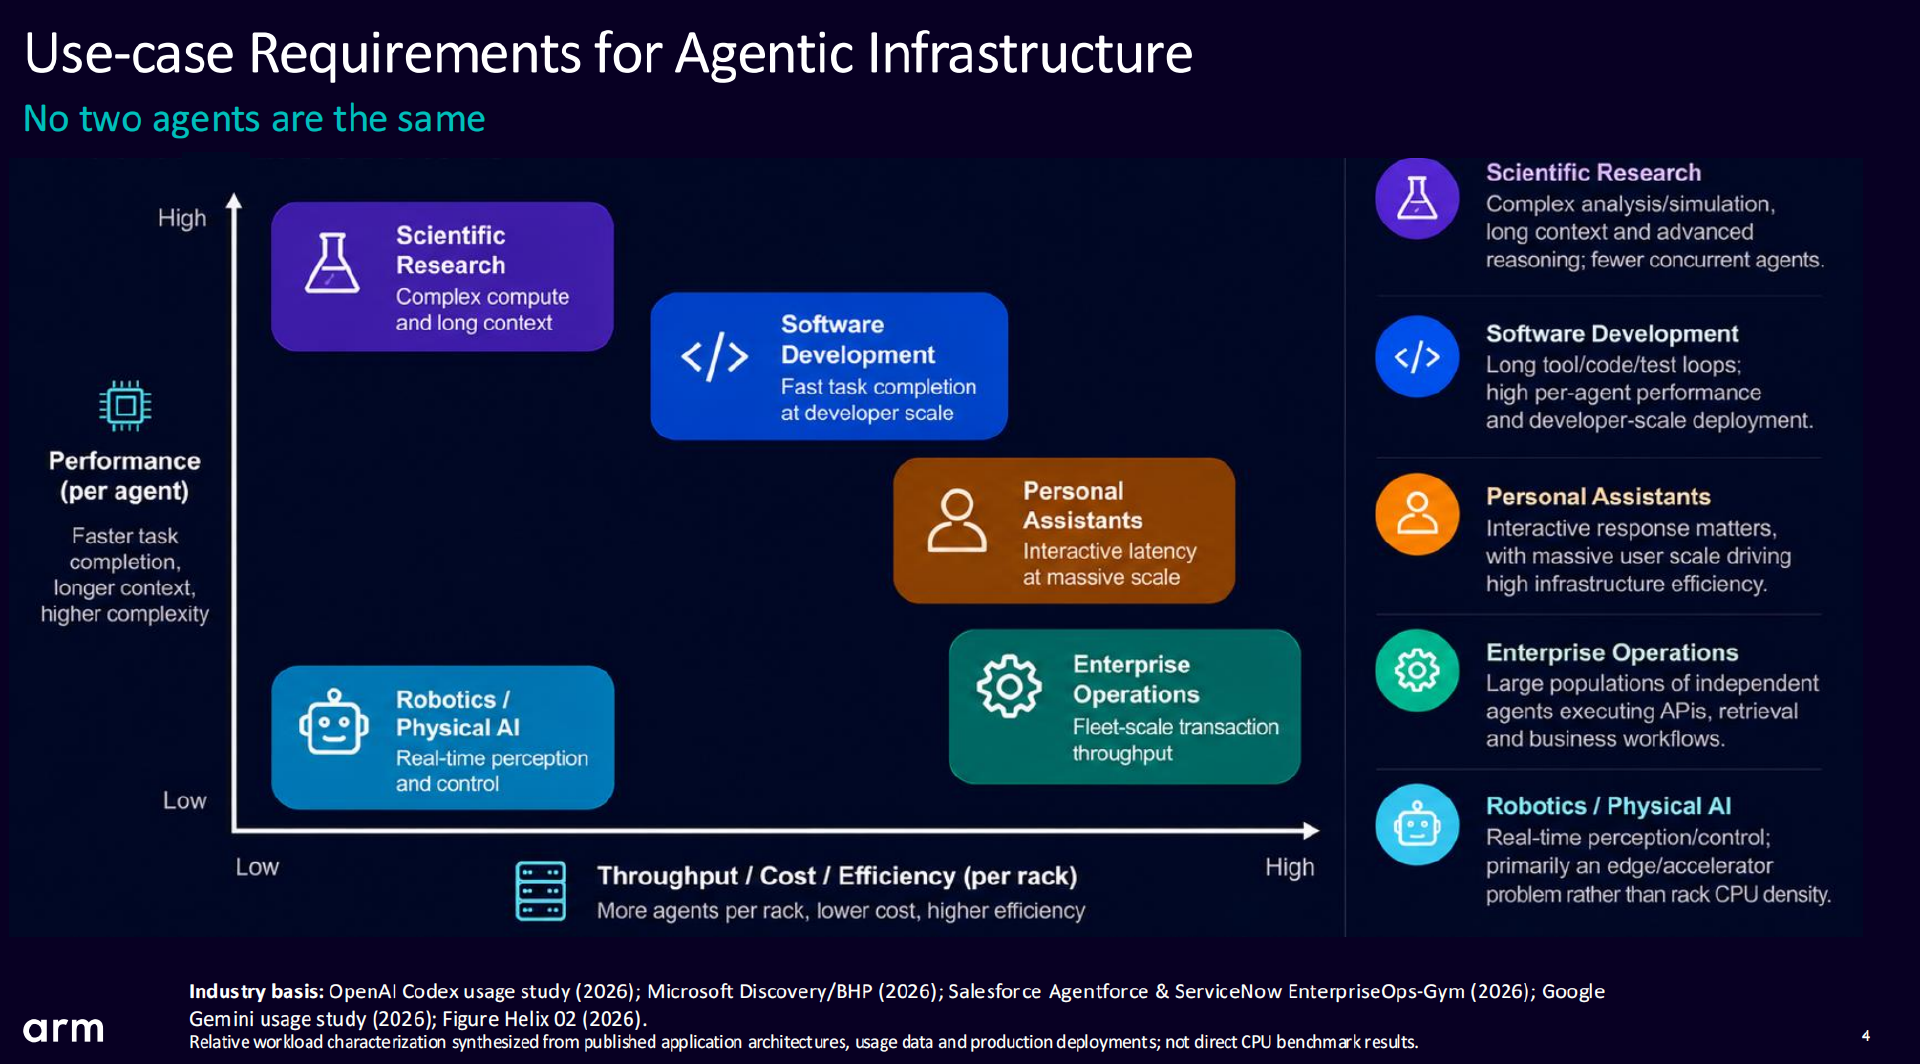
软件开发智能体通常需要执行编译、测试、代码分析等计算密集型操作,任务持续时间较长,对单核性能和内存访问效率提出较高要求。在这类场景中,让单个任务更快完成,可能比单纯增加同时运行的 Agent 数量更加重要。
企业自动化则呈现出另一种特征。客户服务、库存管理或供应链系统中的智能体,可能需要频繁访问数据库、调用 API 或执行较短的业务操作。单次任务的 CPU 开销不一定很高,但同时运行的任务数量可能非常庞大。
这时,系统关注的重点就变成了并发能力、吞吐量以及单位资源能够处理多少次请求。
个人助理同样如此。一次日程查询或网页访问可能十分短暂,但当大量用户同时使用智能体服务时,成千上万个短任务会对服务端的资源管理、I/O 和调度能力形成持续压力。
因此,软件开发场景需要较强的单任务执行能力,而企业运营场景更强调高并发下的稳定吞吐,两者未必适合采用完全相同的 CPU 配置。
Ravi Malhotra 在分享中提到,对于 Terminal-Bench、SWE-bench 所代表的软件开发负载,每个 CPU 核心运行一到两个 Agent 可能已经足够。继续增加并发数量,虽然可能提高资源使用率,却也可能导致单个任务的完成时间超出服务等级协议(SLA)的要求。
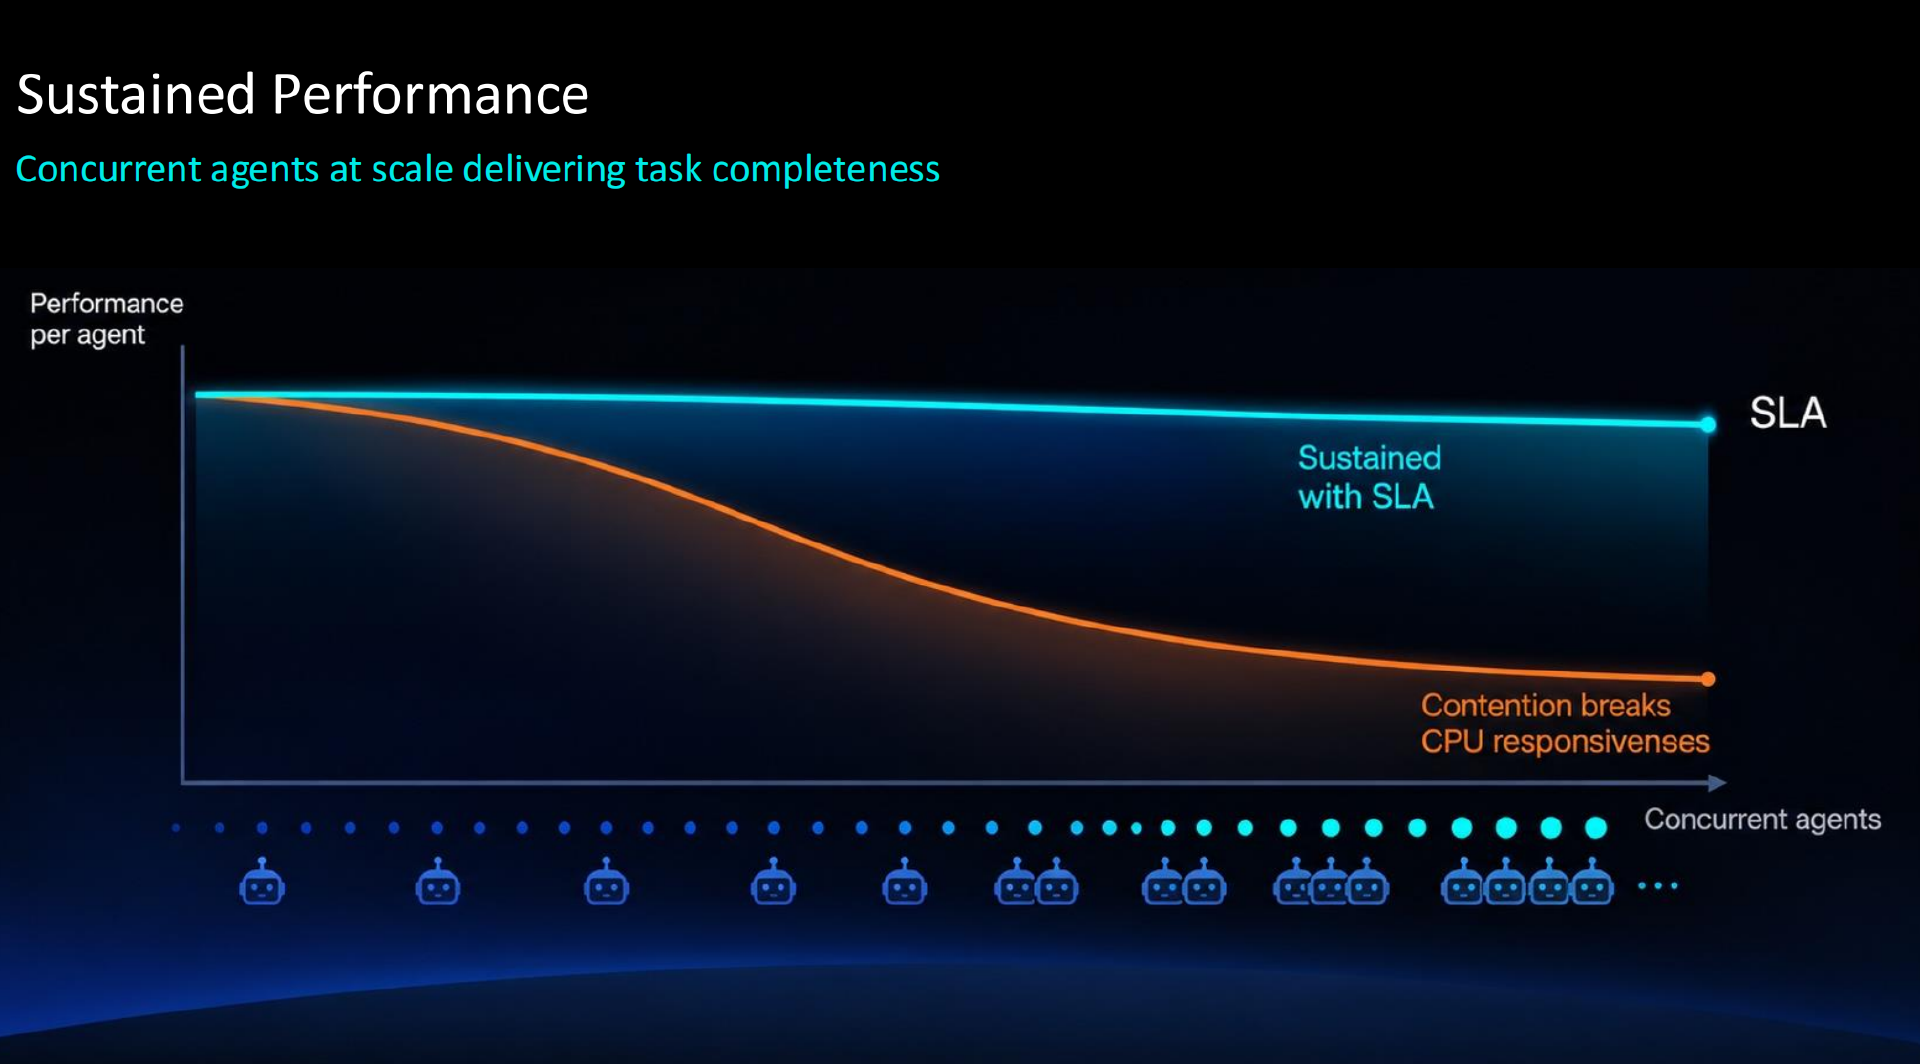
对于持续时间较短的企业自动化和个人助理任务,则有可能在单核上承载更多并发执行实例。
这也引出了 Agent 基础设施选型中的一个核心矛盾:最高吞吐量,并不等于最好的实际服务能力。
一个系统即使能够同时运行更多 Agent,如果任务延迟大幅上升、超时频繁发生,或者关键任务无法按时完成,这种并发能力也很难转化为实际业务价值。
未来的 CPU 评估,需要同时回答两个问题:一个 Agent 能跑多快,以及在延迟和稳定性约束下,系统究竟能够持续运行多少个 Agent。
CPU 的竞争,正在从单芯片延伸到整个机架
当 Agent 开始大规模部署,CPU 评价的另一个变化,是从单颗芯片性能转向整个数据中心能够持续交付的计算能力。
10 月发布的一份 Signal65 研究报告,对 Arm AGI CPU 与 AMD 第五代 EPYC 9755 进行了比较。测试覆盖了 Web 服务、数据库、向量检索、模型服务支持及智能体任务执行等工作负载。
结果显示,在其设定的相同机架功耗预算下,Arm AGI CPU 的平均机架级性能约为对比平台的 1.99 倍。其中,工具调用类负载约为 1.7 倍,推理与规划支持类负载约为 2.2 倍,端到端智能体相关负载约为 2 倍。
这些数据背后的关键,并非单颗 CPU 的性能提升了两倍,而是部署密度与单芯片性能共同作用的结果。
按照 Signal65 的机架功耗模型,在 24kW 的功率预算下,可配置 21 至 23 台 Arm AGI CPU 服务器,而对比配置为 13 台 EPYC 9755 服务器。通过在相同功率预算下部署更多计算核心,系统获得了更高的总体吞吐能力。
需要说明的是,报告中的机架级结果基于芯片实测结果与服务器额定功耗进行建模,并非完整生产环境中的机架实测。研究由 Arm 委托开展,最终的性能和成本表现仍需结合实际部署配置验证。
但这一评估方向具有一定的行业代表性。
Ravi Malhotra 解释,企业最终部署的是整个机架,而不是孤立的一颗处理器。因此,除了单核性能,还必须考虑内存利用效率、服务器功耗、机架容量以及能够承载多少并发任务。
对于大规模 Agent 服务而言,基础设施的约束条件正在变得更加具体:机房空间、电力容量、散热能力,以及业务能够容忍的任务延迟。
在这些约束之下,单颗 CPU 跑得更快固然重要,但整个机架能够完成多少符合 SLA 要求的任务,可能更接近企业真正关心的指标。
Agent 越多,沙箱和编排越不能被忽视
除了计算性能,Agent 还带来了一个容易被低估的基础设施成本:执行环境。
与传统聊天机器人不同,能够实际操作文件、运行代码或访问外部系统的智能体,通常需要在受控环境中执行任务。Docker、Firecracker、gVisor 等容器和隔离技术,因而成为智能体基础设施的重要组成部分。
但隔离并不是免费的。
每次创建执行环境,都需要消耗一定的 CPU、内存和时间资源。对于长时间运行的软件开发智能体,这部分成本可能被较长的任务周期摊薄;但对于需要频繁启动和销毁执行环境的短任务,沙箱启动延迟就可能直接影响用户体验与系统吞吐量。
Signal65 的研究专门测试了沙箱冷启动、热启动和高并发情况下的性能开销。这也反映出 CPU 评估对象正在从传统计算任务扩展到更完整的软件执行生命周期。
在这一过程中,编排系统同样重要。即使硬件能够提供大量计算核心,如果调度层无法及时分配任务、复用执行环境,或者处理不同 Agent 之间的资源竞争,理论上的并发容量也难以转化为有效吞吐量。
因此,Agent 对 CPU 的需求,并不是简单地增加核心数量,而是要求硬件性能、系统软件和运行时环境协同优化。
最大的问题:行业还没有统一的 Agent CPU 跑分标准
随着 Agent 成为新的基础设施竞争焦点,Arm、AMD、Intel 等厂商及研究机构都开始围绕相关工作负载建立评估方法。
但问题也随之出现:不同机构选择的软件、部署拓扑、并发规模和统计口径并不相同,最终得到的性能数据,很难直接进行横向比较。
例如,Signal65 在另一项针对 Intel Xeon 6 与 AMD EPYC 云实例的研究中,使用 Terminal-Bench 2 的记录回放方式,尽可能消除模型推理结果变化对测试的影响,重点衡量 CPU 承担的命令执行、容器任务与编排工作。该研究同样发现,不同处理器在任务延迟和成本效率方面的表现并不完全一致。
Ravi Malhotra 对此表示,Arm 当前提出的是评测方法论,而不是正式的行业标准,也不建议为不同智能体场景设定统一权重。他认为,组件测试与端到端测试需要结合,企业则应根据自己的业务选择相应指标。
这可能是当前 Agent 基础设施评估最值得关注的变化:行业正在从追求一个统一的性能分数,转向衡量特定业务在实际资源约束下的任务完成效率。
不过,新的评估体系仍有待完善。当前不少测试侧重 CPU 承担的工作,尚未完整覆盖 CPU 与 GPU 之间的网络传输、跨节点调度,以及 DPU 在数据搬运和基础设施服务卸载中的作用。
Ravi Malhotra 也表示,CPU 与 GPU 机架之间的网络带宽和延迟十分重要,未来需要将这些因素纳入更完整的评估。
从这一角度看,Agent 带来的变化并不是 CPU 取代 GPU,而是两者之间的协作效率变得更加重要。GPU 继续承担模型推理等密集计算任务,CPU 负责工具执行、任务编排和相关数据处理,DPU 则可以在网络、存储及基础设施服务等环节承担部分卸载任务。只有这些组件能够有效衔接,才能减少任务等待和资源空转。
对于企业来说,接下来真正值得衡量的,是完成一项代码修复、处理一张客服工单或执行一次复杂业务流程,究竟需要多少时间、消耗多少资源,以及付出多少成本。


