视觉 AI 项目里有一个并不陌生的现象:算法在测试和验收阶段表现不错,但进入现场一段时间后,效果开始发生变化。
摄像头角度会调整,白天和夜间的光线不同,目标外观会变化,客户的管理规则也可能发生调整。对于过去以定制开发为主的视觉 AI 项目来说,一旦遇到新的误报、漏报或者需求变化,往往意味着重新采集数据、标注、训练、测试,再安排一次部署。
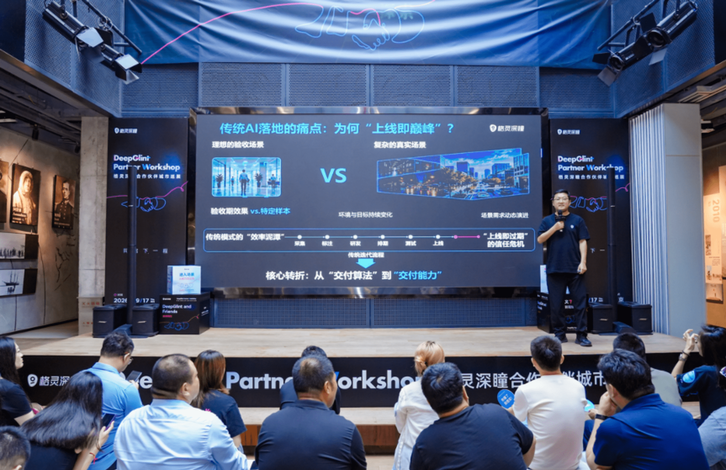
近期,在 DeepGlint Partner Workshop 北京站现场,格灵深瞳政企事业部负责人陈平安把这一问题概括为“上线即巅峰”和“上线即过期”。在他看来视觉 AI 落地的难点并不只是把算法训练出来,还包括模型上线以后如何适应现场和业务变化。这也是格灵深瞳视觉智能工坊 VE²S 想解决的问题。
与过去围绕单个算法完成项目交付的方式不同,VE²S 将算法生产、业务编排、现场运行和数据回流放进同一套产品体系,格灵深瞳将其定义为“视觉 AI 生产线+现场运营后台”。
对视觉 AI 来说,模型部署并不是终点,模型上线之后由谁维护,现场出现的新问题如何重新进入算法生产流程,一直影响着项目后续的运行成本和效果。
算法上线,只是工程链路的中点
传统计算机视觉项目的基本流程并不复杂,客户提出一个需求,算法团队收集和标注数据,再训练模型、测试效果,最后完成部署。只要任务足够明确,这种模式在很多成熟场景中已经运行多年。
问题往往出现在部署以后。模型训练依赖的是某一阶段的数据,而现场环境不会固定不变。如果后续增加新的目标类别、调整判定规则,或者出现训练集中没有覆盖的情况,就需要再次进入算法研发流程。
陈平安在现场展示的传统迭代链路里,采集、标注、研发、排期、测试和上线彼此相对独立。每次需求变化,都可能重新启动这条链路,而视觉智能工坊 VE²S 的思路,是把这些环节重新组织。这套产品由 MENTOR、EXPERT 和 GBOX 三部分组成。MENTOR 负责数据、标注、训练、评测和模型生产;EXPERT 负责现场任务、规则以及多算法编排;GBOX 则承担边缘侧的推理和运行。一项视觉任务可以从 MENTOR 完成模型生产,再通过 EXPERT 组织业务规则,由 GBOX 在现场运行。运行中产生的误报、漏报和难例又可以重新回到模型生产环节,经过评测和更新后形成新的模型版本。
过去,当客户提出一个新的视觉需求时,算法团队通常需要先判断任务是否成立,再收集样本、设计规则或者训练一个初始模型。这一过程对算法人员的依赖较高,也意味着每个新需求都有一段前期验证成本。
陈平安在现场介绍了一种不同的冷启动方式。用户可以先通过自然语言描述需要检测的行为,由视觉大模型直接创建任务并进行零样本验证,先判断这类需求是否具备可行性,确认以后,再进入规则和算法编排阶段。在 EXPERT 中,时间、地点、对象、出现次数以及外观等条件可以被组织成可视化规则,不同算法也可以根据任务需要组合在一起。对于复杂事件,还可以在传统视觉模型初筛之后,再引入视觉大模型进行判断。
不同视觉任务,需要不同的模型
大模型已经可以解决越来越多的视觉任务,但在企业环境里,效果并不是唯一指标。成本、时延、并发规模以及现场硬件条件,同样会决定一项能力最终采用什么技术方案。
格灵深瞳 AI Infra 负责人闫梓祯在现场把公司的视觉模型划分为三个层级:L1 是面向检测、识别和跟踪等明确任务的专用视觉模型;L2 是视觉基座模型 Glint-MVT,用于可复用的视觉表征和少样本适配;L3 则是 Glint-VL 视觉语言模型,处理视频理解、复杂场景和行业任务。
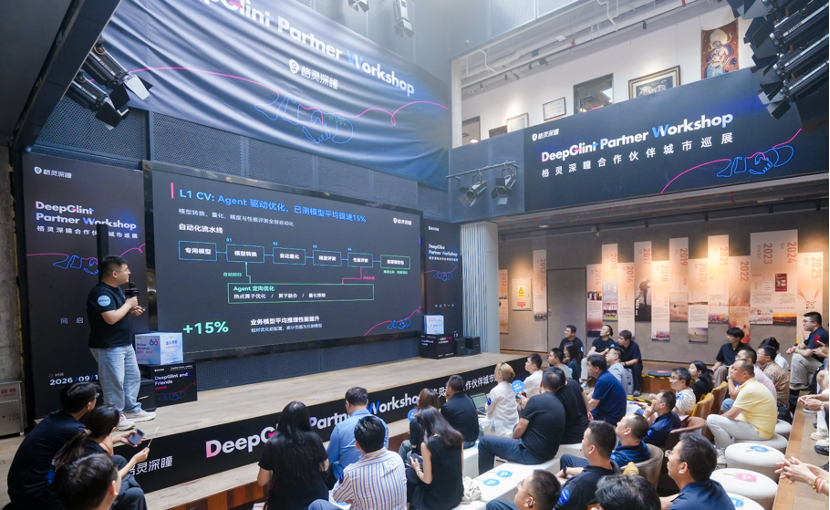
稳定、高频、边界明确的任务,更适合专用模型;需要少样本适配时,可以使用视觉基座;涉及复杂行为、上下文和事件理解时,VLM 的价值更明显。因此,VE²S 并不是一个“大模型工作台”,而是把不同层级的视觉模型组织在同一套生产和运行体系里。
从视频识别,到业务事件
格灵深瞳在北京站展示的成品油监管案例,是一个比较直观的例子,传统摄像头产生的是连续视频,而业务人员真正需要处理的往往不是“这段视频里有什么”,而是某一次业务事件发生了什么。
在这一案例中,GBOX 会识别车辆进入、提枪、挂枪、离开等关键动作,将连续视频整理成可以查询的加油事件,并保留对应的时间和视频记录。随后,EXPERT 再把视频事件与业务系统里的流水、支付和开票信息进行关联。如果不同来源的信息出现异常,系统将对应事件交给工作人员复核。复核过程中发现的夜间、遮挡或者此前没有充分覆盖的情况,还可以重新形成样本,进入 MENTOR 完成训练和评测,再将新的模型版本部署回 GBOX。
一次视觉识别不再只是生成一个告警。它开始变成一条能够被查询、核验、处置和重新训练的数据记录,这也是 VE²S 所谓“闭环”的实际含义。
从项目经验到可复用的产品流程
在此次活动上,格灵深瞳 CEO 吴一洲将公司定位概括为“大模型原生的 AI 全栈产品与服务商”。落到视觉智能工坊 VE²S 上,过去大量依赖项目团队完成的视觉 AI 工作,有多少能够沉淀为可复用的产品流程。
模型训练可以形成标准化流程,规则配置可以由工具承接,部署和升级也可以沉淀为可重复使用的能力。但最终能否改变视觉 AI 项目的成本结构,还需要在项目中检验。例如,新的视觉需求能否不再每次都进入完整研发周期;业务人员能否承担更多任务定义和规则配置;难例回流能否稳定形成模型更新;同一套产品在不同客户之间能够复用多少,而不是换一个项目重新做一遍。
这些问题比一次 Demo 是否识别成功更难回答。但它们可能更接近视觉 AI 进入规模化应用之后,行业接下来要面对的问题。
对于格灵深瞳而言,视觉智能工坊 VE²S 给出的答案并不是“再训练一个更强的模型”,而是把算法生产、模型部署、业务运行和后续更新放进同一套产品里。
当模型本身越来越容易获得之后,如何让模型长期运行、随业务变化更新,并减少反复开发和适配的成本,正在成为视觉 AI 工程化过程中更值得关注的问题。


