“刚选定模型、完成平台搭建,业务流程也已经接入。但没过几天,市场上又出现一个表现更好的模型,CEO 转头就问 CIO:能不能也试试?”红帽全球副总裁兼大中华区总裁曹衡康(Victor Tsao)提到了企业落地 AI 时经常遇到的一个困境。
对企业来说,换模型并不像个人更换一个聊天工具那么简单。模型背后还连接着 GPU 适配、推理服务、数据接口和业务流程,前一套系统刚刚跑顺,新模型就来了,企业既不想错过技术进步,也不愿意为此重新搭建整套环境。
Agent 的出现又带来了另一层压力。当智能体开始接入企业内部系统,能够访问什么数据、执行哪些操作,就成了必须明确的问题。如果缺乏有效的权限约束,Agent 为了完成任务,甚至可能直接删除生产数据库。
模型迭代越来越快,企业需要保持技术选择的灵活性;Agent 能力越来越强,企业又必须确保其行为可控。这些变化正在推动企业 AI 基础设施从模型部署和算力供给,进一步走向推理效率、资源管理和运行治理。
红帽近几个月的产品布局也围绕这些问题展开:从 GPU 调度和 Token 生产,到 Agent 权限管理,再到软件漏洞发现与修复,试图解决 AI 从试点走向生产环境时遇到的实际困难。
底座不能频繁重建,总账单需要控制
模型厂商之间的竞争,正在让企业 IT 部门面临新的选择难题。
企业如果把业务流程深度绑定在某个模型和运行环境上,就很难及时享受到新技术带来的收益。模型换代还会牵动底层硬件、推理框架和应用接口,之前的投入也未必能够直接复用。
曹衡康认为,企业 CIO 真正关心的不只是哪个模型最好,而是当前选择的平台能否适应持续变化的技术环境。过去,红帽将这一思路概括为“四个 Any”:任意加速器、任意云、任意模型和任意智能体。
红帽希望延续 Linux 和 OpenShift 的路径,将开源技术转化为企业可以长期使用的商业化平台。底层硬件和模型可以变化,但企业不必每次都重新建设整个运行环境。据红帽介绍,目前其平台支持 20 多个开源模型、合计 700 多个版本。在加速器方面,除了 NVIDIA、Intel 和 AMD,也已经支持国产 GPU 厂商沐曦,并继续推进其他国产算力产品的适配。
随着企业对算力的管理需求增加,这种开放性也开始从硬件层向推理服务延伸。
红帽大中华区方案架构部总经理王慧慧(Aella Wang)提到,红帽早期将相关场景称为 GPU as a Service,即通过统一平台管理不同品牌的 GPU,让企业按需使用。随着推理需求增长,客户开始更多地谈 Token 工厂:将 GPU 资源集中起来,通过模型和推理引擎生产 Token,再将其作为服务提供给不同业务部门。再往上一层,则是 Model as a Service,由企业 IT 部门统一提供模型服务,业务部门根据自身需求选择模型,而不必分别搭建运行环境。
这背后是企业 AI 成本结构的一次变化。
曹衡康指出,过去一年,单位 Token 价格虽然持续下降,但企业的总账单不一定减少。随着思考模型和 Agent 普及,一项任务可能需要多轮推理、工具调用和结果验证,Token 消耗量也随之增加。单价下降,并不意味着总支出同步下降。
这也是红帽提出企业不能只做 Token 消费者,还应该考虑成为 Token 生产者的原因。对于已经投入大量 GPU 资源的企业,可以通过自建推理平台提高算力利用率,减少对外部 API 的长期依赖。
不过,自建 Token 工厂并非天然更便宜。它需要相对稳定的业务负载、合理的 GPU 利用率、专业的运维团队,以及持续的模型优化能力。如果算力长期闲置,折旧、电力和维护成本反而可能高于直接调用商业 API。企业真正需要比较的,不是单个 Token 的价格,而是完成一项有效任务的综合成本。
红帽在推理基础设施上的布局,正是围绕这一问题展开。其深度参与的 vLLM 已经成为开源模型推理领域的重要项目。与此同时,红帽还推动分布式推理项目 llm-d,希望进一步解决大规模 GPU 集群中的资源调度和推理效率问题。
10 月 20 日,llm-d 发布 1.0 版本。相比此前主要关注推理性能和集群调度,这次更新进一步补齐了生产环境所需要的多租户资源管理、请求优先级调度、高可用和滚动升级能力,并增加了面向 Agent 工作流的会话感知路由,让多轮请求尽可能复用已有上下文缓存,减少重复计算。
IBM Research 的一项基准测试展示了其规模化能力:通过 llm-d 部署约 7530 亿参数的模型,在并行 Agent 工作负载下,最多支持 3000 个并发编码 Agent,峰值输出吞吐超过每分钟 660 万 Token。按照测试采用的云资源租赁价格估算,单位 Token 成本比同等商业 API 低 5 至 10 倍。
这类优化的价值不仅在于提高吞吐量,也在于让 GPU 资源能够承载更多并发任务,降低高负载下的推理成本。
在中国市场,红帽还与趋境科技共建推理 AI 创新实验室 AI 推理技术联合创新实验室。双方的分工是,红帽提供 vLLM 推理框架和标准化平台,趋境科技负责不同模型、加速卡和平台环境下的具体优化,包括 KV Cache 处理等技术实现。双方希望将成熟成果进一步回馈开源社区。
Agent 真正难的不是开发,而是权限
推理效率解决的是 AI 能否以合理成本运行,Agent 进入企业工作流后,另一个问题随之出现:企业敢不敢让它真正执行操作?
王慧慧认为,当前智能体开发本身已经不是很高的门槛,开发人员经过几个小时培训,就可能搭建一个能够完成特定任务的 Agent。真正复杂的是权限管理和治理。
当 Agent 开始承担 IT 运维工作,它可能修改服务器配置、关闭机器、执行脚本,甚至删除数据库。一旦操作超出预期,影响的就不再是一段错误回答,而可能是企业真实运行的业务系统。红帽将这一方向称为 Agent AIOps,即通过智能体承担企业内部的 IT 运维工作。
类似的风险也出现在 AI 辅助软件开发中。AI 生成代码之后,可以进入自动化开发流程,但并不意味着可以跳过审核。无论代码由人还是 AI 生成,都需要经过相应检查,尤其是 AI 生成的代码,仍需要必要的审核环节,才能进入最终合并流程。
这意味着,企业需要管理的不只是模型本身,还包括 Agent 的实际执行行为:它能调用哪些工具、访问哪些数据,哪些操作可以自主完成,哪些必须经过人工确认。
Red Hat AI 3.5 进一步加入模型安全评估、Agent 开发模板、工具调用防护和可观测性能力。其中,EvalHub 可以帮助企业对模型和 Agent 开展安全评估,NeMo Guardrails 则用于约束模型和 Agent 的行为。平台还增加了按用户统计 Token 消耗的能力,帮助企业追踪不同团队的资源使用情况。
红帽与 CIO 时代联合发布的《2026 中国企业级 AI 实践调研分析年度报告》也反映了应用速度与治理能力之间的落差:接近 70%的受访企业正在推进 Agent 应用,但正式治理框架覆盖率还不到 15%。
对于企业来说,Agent 的权限不能只靠一条提示词约束,还需要身份认证、工具访问控制、操作审计和人工审批等机制共同发挥作用。尤其涉及生产数据库、核心业务系统等高风险资源时,企业必须明确自主执行的范围,并保留必要的人工控制。
AI 发现漏洞更快,企业修复跟得上吗?
Agent 治理之外,AI 还在改变软件安全的攻防节奏。AI 工具加快了漏洞发现,也可能帮助攻击者将多个看似无关的低危漏洞组合起来,形成更复杂的攻击路径。
对于企业而言,发现漏洞只是第一步,真正麻烦的是修复。很多生产系统依赖大量 Java、Python 开源组件,当漏洞出现时,上游社区维护人员通常只会在软件的最新版本中进行漏洞修复。对于拥有高度自定义、互连生产环境的企业来说,直接升级到新版本可能引发兼容性问题。企业往往需要在安全风险和系统稳定性之间作出取舍。
红帽与 IBM 联合推进的 Lightwell,试图解决的正是漏洞发现之后的修复问题。其方式是利用 AI 辅助漏洞识别,再由工程师参与验证和修复,将补丁回移到企业实际使用的软件版本中,尽量避免为了修复漏洞而整体升级。
10 月 6 日,IBM 与红帽披露,Lightwell 已经在广泛使用的 Java 库中发现并修复 400 多个此前未知的漏洞,Lightwell Clearinghouse 也正式进入全面可用阶段,企业可以提交具体的软件依赖,申请优先审查和修复。
企业还需要将补丁快速应用到生产环境中。王慧慧还给出了一组时间对比:传统情况下,企业完成相关补丁部署可能需要 40 多天,通过自动化流程可以缩短到 7 至 14 天。
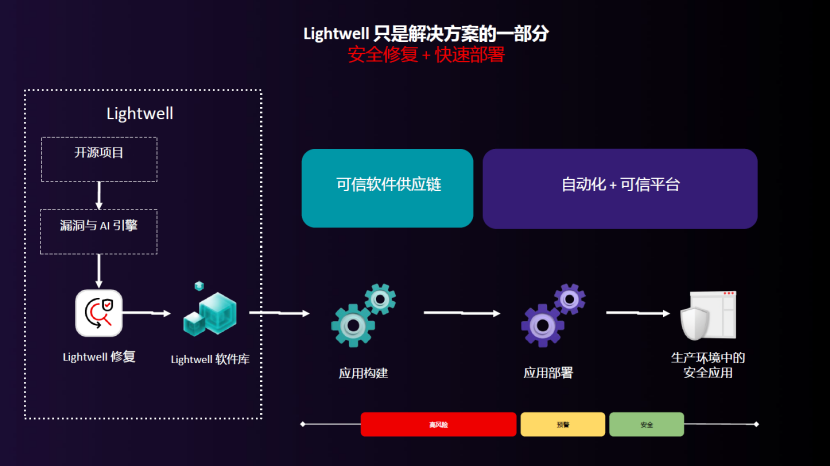
从漏洞发现到补丁部署,Lightwell 希望缩短的是企业安全响应中间的这段时间。对于仍然运行大量旧系统的企业,这种方式也能减少因整体升级带来的业务中断和兼容性风险。
红帽的平台边界也在变化
红帽的基础设施能力还在从数据中心向工业现场延伸。
在具身智能领域,红帽联合 Intel、紫金星宇、西湖机器人和施耐德电气,推出面向工业自主运营的联合解决方案。这套方案中,西湖机器人提供机器人本体,Intel 提供计算平台,施耐德电气提供工业场景能力,紫金星宇提供通信技术,红帽则负责底层软件平台。
王慧慧将人形机器人比作一座移动的数据中心,。机器人端侧负责集成感知、计算、实时动作和肢体控制等多种能力,。随着应用场景要求的提高,更复杂的推理和决策则可以放在云端或数据中心。在红帽平台支持下,软件无需重新编译即可实现位置迁移。此外,通过红帽 OpenShift AI,企业可以统一管理多台机器人、模型和相关计算资源,集中下发算法更新和控制指令。
这实际上是红帽原有平台能力向边缘计算场景的延伸。过去管理的是数据中心里的服务器、虚拟机和容器,现在则可能增加工厂里的机器人。对于需要部署和管理大量设备的企业,统一的软件环境和远程运维能力也会变得重要。
回到企业 AI 落地本身,曹衡康坦言,国内外企业面临的问题大体相同:投入不小,但真正能够证明投资获得回报的案例还不多。中小企业目前仍主要集中在邮件处理、文档管理和客服等相对轻量的场景,更复杂的自主决策和自动化运维,即使在领先企业中,也受到安全、成本和可控性的限制。
从 GPU 调度、分布式推理,到 Agent 治理、漏洞修复,再到工业机器人,红帽近几个月的产品布局看似分散,实际都指向同一个问题:如何让不断变化的 AI 技术进入企业现有系统,并在生产环境中稳定运行。
模型和算力仍在快速迭代,企业却不能跟着每一次技术变化重建基础设施。对红帽而言,开放平台的价值正在从提供技术选择,进一步延伸到帮助企业管理 AI 运行的成本、权限和风险。至于这些能力能否转化为可量化的业务回报,还需要更多真实生产场景来验证。


